
Двенадцать факторов приложения. Новый взгляд
Методология Twelve-Factor App, разработанная Адамом Виггинсом, описывает подход к созданию приложений в формате «программного обеспечения как услуги» (software as a service, SaaS). Разберём все двенадцать факторов: как они менялись, что из них актуально сегодня и как они повлияли на практику разработки.
Нередко приходится слышать, как расхваливают подходы к разработке и развёртыванию софта в старые добрые времена. Сегодня так говорят о Heroku. Не поймите меня неправильно: это и в самом деле был выдающийся продукт, он задал новый способ писать веб-приложения и разворачивать распределённые системы.
Похоже, они многое сделали правильно: больше десяти лет спустя мы всё ещё пытаемся добиться такой же лёгкости разработки.
Я хочу пройтись по каждому из двенадцати факторов Адама Виггинса, сооснователя Heroku. Этот текст, известный как “12 Factor App”, обобщил идеи, которые сделали работу с Heroku удобной и результативной. Я хочу рассмотреть, как как эти идеи повлияли на практики в прошлом, как они изменились со временем и какие из них актуальны сегодня.
Кодовая база
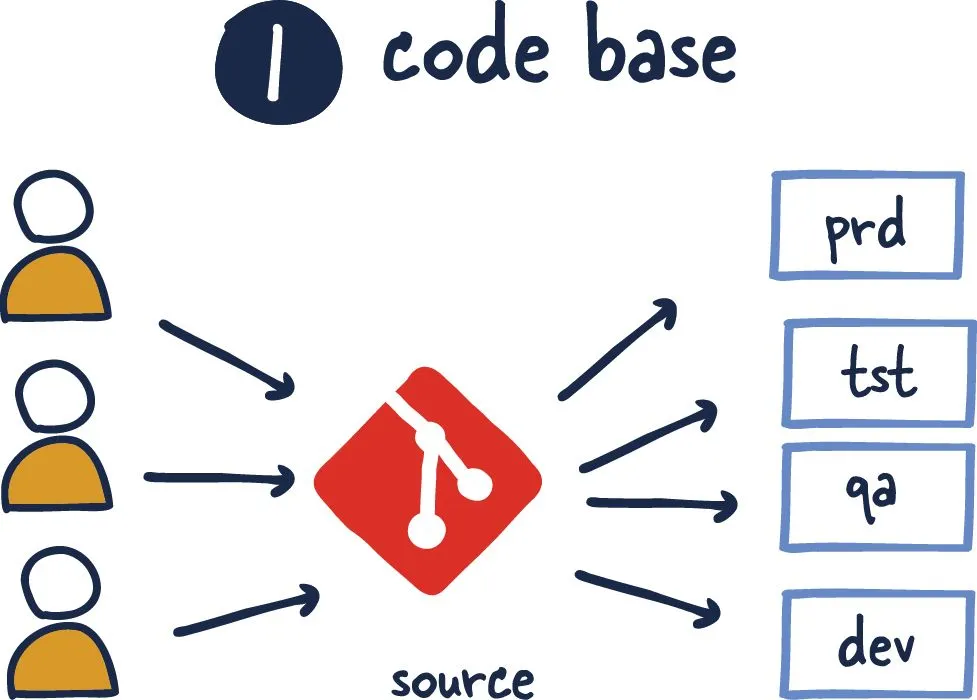
Одна кодовая база, отслеживаемая в системе контроля версий, множество развертываний.
Когда появилась концепция “12 Factor App”, не было привычным даже версионировать код. Звучит странно, но это так. Я помню, как в начале карьеры приходилось разбираться с проблемами Subversion.
С тех пор связь между репозиториями и приложениями заметно выросла и теперь она охватывает всё, от тестирования до развёртывания. При этом один вопрос остаётся предметом споров: нужен ли монорепозиторий.
Если существует несколько кодовых баз — это уже не приложение, а распределённая система. Каждый компонент такой системы — это отдельное приложение, и каждое из них может само по себе соответствовать принципам «двенадцати факторов».
Особенно в мире, ориентированном на микросервисы, издержки на поддержку множества репозиториев могут сильно утомлять.
Зависимости
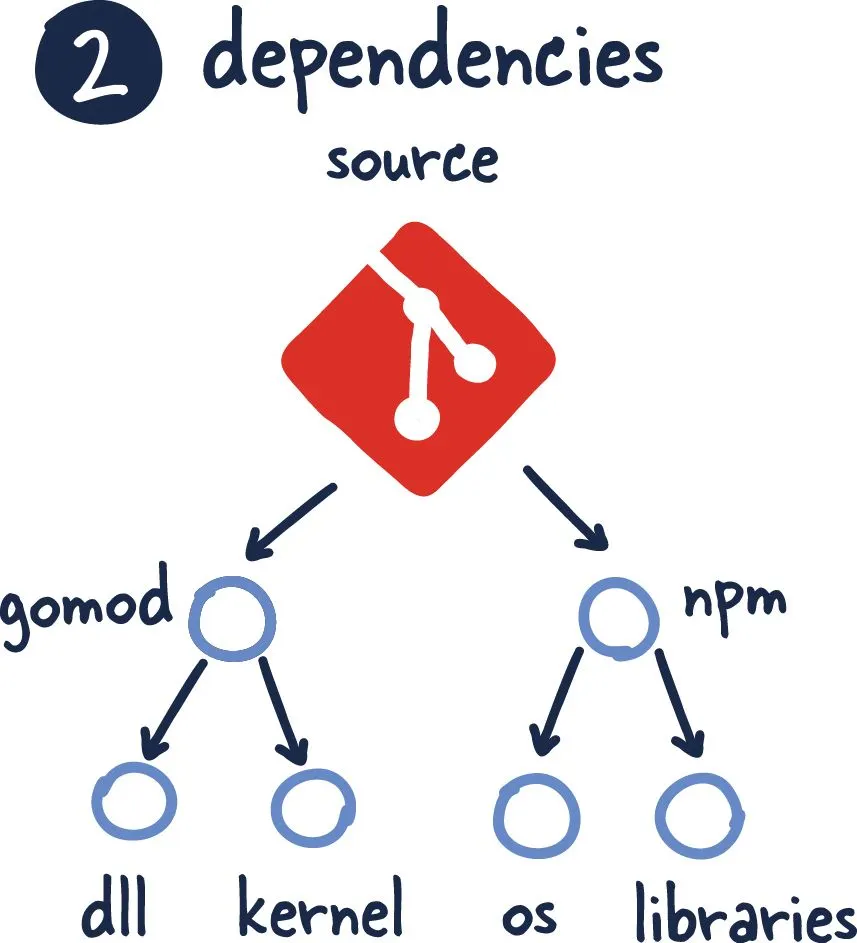
Все зависимости должны быть объявлены без неявной зависимости от системных инструментов или библиотек.
Я не знаю, многим ли из вас приходилось настраивать серверы вручную или самописными скриптами до появления систем управления конфигурацией вроде Ansible и Puppet. Особенности разных операционных систем и версий библиотек были настоящим кошмаром.
Этот фактор попал точно в цель, и сегодня можно считать, что эта проблема в основном решена.
Благодаря появлению манифест-файлов наши приложения можно пересобирать стабильно и предсказуемо. Более того, инструменты сборки вроде Bazel пошли ещё дальше: они предоставили мощные средства для билд-инженеров, позволяющие создавать воспроизводимые релизы.
И это не говоря о том, что теперь мы можем выкатывать компактные образы, в которых есть лишь то, что нужно для продакшена (подробнее об этом дальше).
Конфигурация
Конфигурационные данные, которые различаются в зависимости от развертывания, следует хранить в среде.
Этот фактор остаётся неизменным, но стоит учитывать несколько моментов при отделении конфигурации от кода приложения.
Инструменты всё чаще предлагают собственный жёсткий подход (opinionated), поэтому выбор смещается в сторону Vault и систем обнаружения сервисов (service discovery), которые управляют конфигурацией и хранят её в системах, учитывающих окружение (environment-aware)..
Сторонние службы
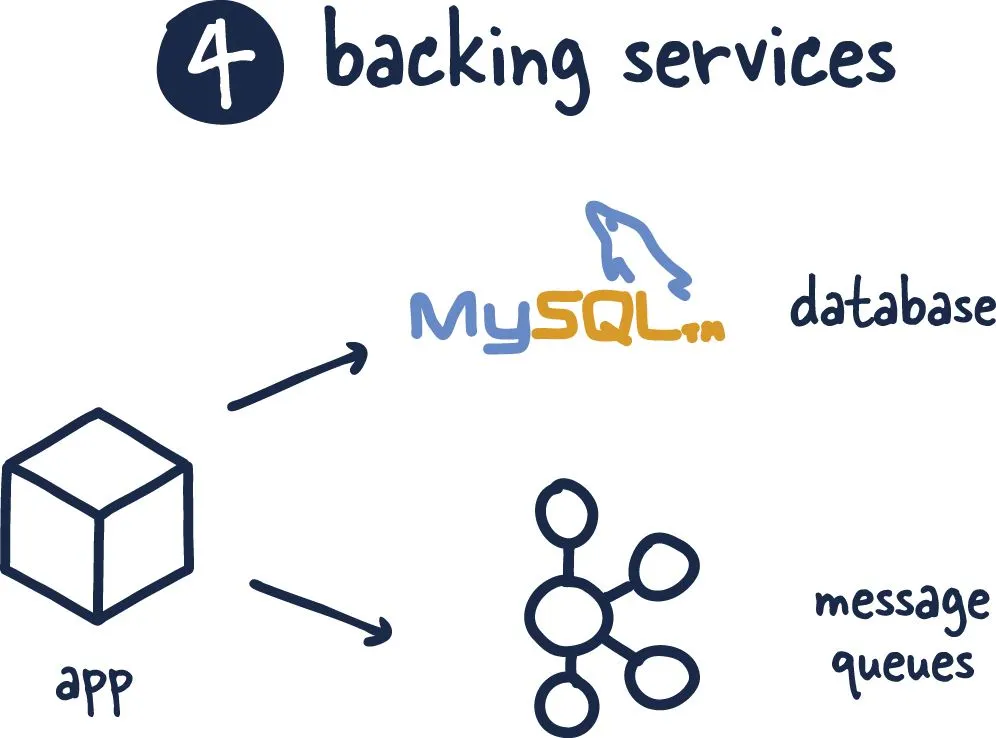
Все вспомогательные сервисы рассматриваются как подключённые ресурсы; они подключаются и отключаются средой выполнения.
Изначально фактор писался для компонентов одной системы, в основном вокруг баз данных и тому подобного. Хотя в нём и не описывается различие между локальными и сторонними службами, эта идея получила развитие с появлением систем, построенных на принципе API-first.
Этот принцип оказался настолько успешным, что его стали перенимать многие команды: он помогает выстроить чёткий контракт между разработчиками, отвечающими за разные части системы. В итоге это решение повышает гибкость и эффективность по мере роста этих систем.
Сборка, релиз, выполнение
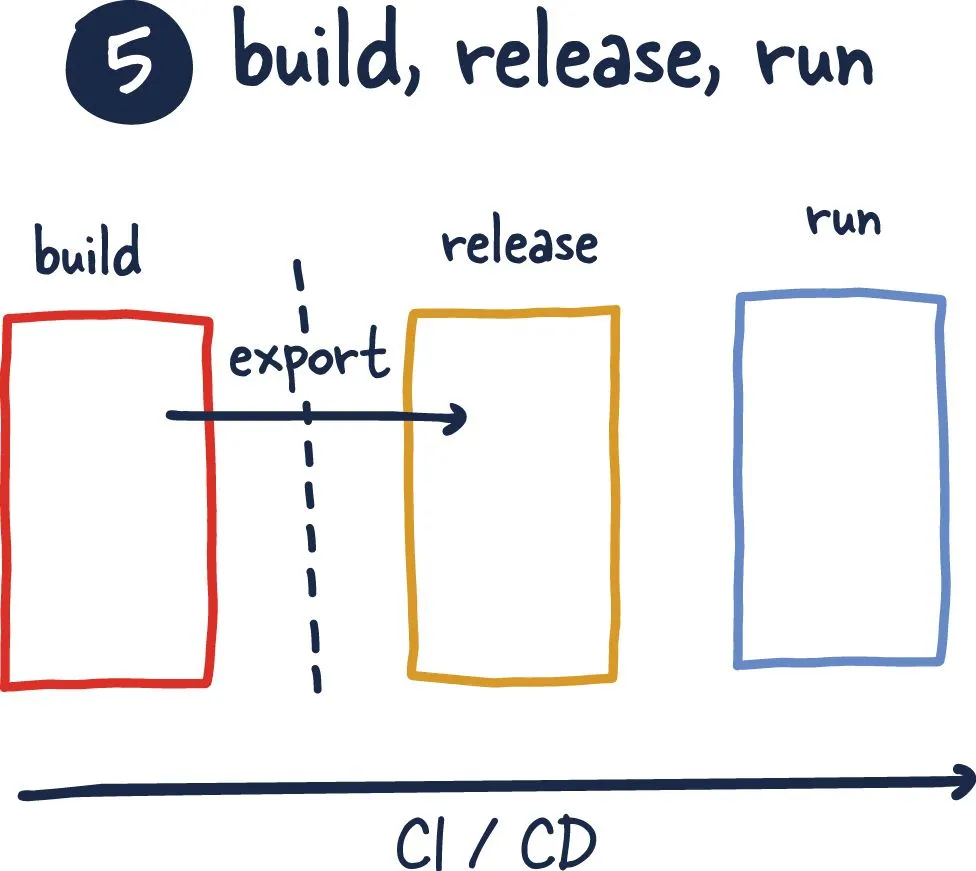
Конвейер доставки должен состоять из этапов сборки, выпуска и запуска.
Этот фактор сегодня можно считать стандартом почти для любого современного сервиса. Хочу отметить, что на практике я довольно редко вижу разделение этапов сборки и релиза, а это критически важно для выстраивания разумных процессов развёртывания и отката.
По мере того, как код объединяется и проходит тестирование, результат каждой сборки, будь то образ или бинарный файл, должен где-то сохраняться, чтобы его можно было впоследствии запросить для релиза и развёртывания. Такое разделение делает цикл разработки проще и снижает вероятность ошибок.
При небольших масштабах или на ранних этапах разработки, когда изменения тесно связаны с развитием самого приложения и его инфраструктуры, это разделение не так уж необходимо. Многие из этих идей подробно разбираются в GitOps.
Процессы
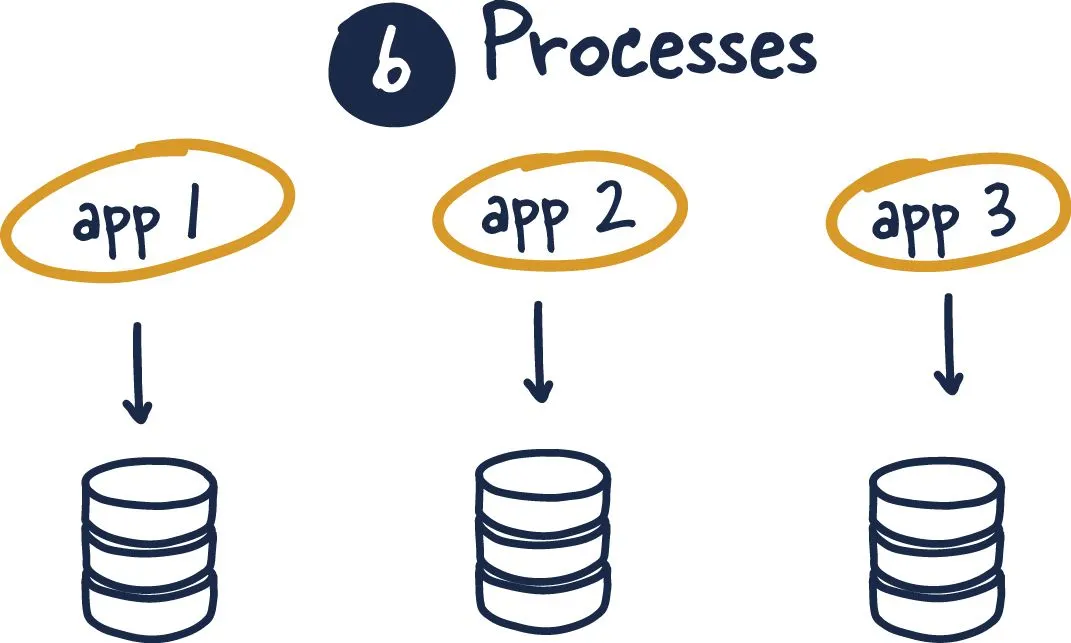
Приложения следует развертывать в виде одного или нескольких процессов без сохранения состояния, при этом данные могут сохраняться в отдельной службе.
Этот принцип остаётся актуальным в мире REST API. Применительно к веб-сервисам это означает, что между запросами мы не должны хранить состояние домена в памяти. Взаимодействие между приложениями не должно сохранять состояния, либо необходимые данные должны храниться в отдельной службе.
Управление и хранение состояния остаётся одной из проблем масштабирования для любой системы. Это особенно важно при горизонтальном масштабировании в модели SaaS. Эта идея хорошо сочетается с концепцией ограниченного контекста: каждая система должна управлять собственным слоем хранения данных. Если другим системам нужен доступ к этим данным — даём его через хорошо документированный API.
Привязка портов
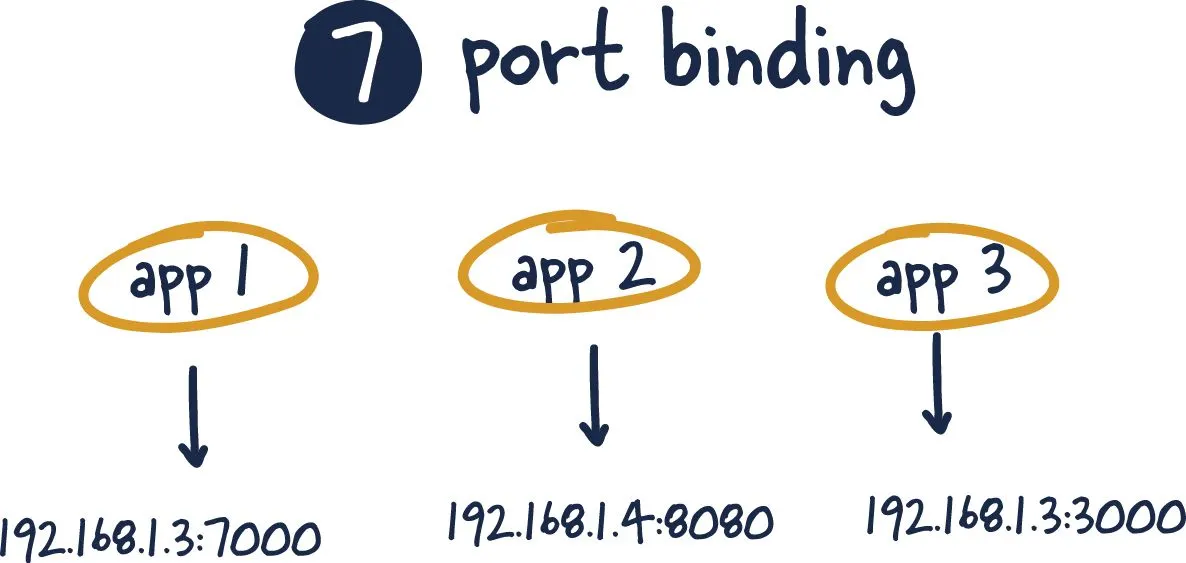
Автономные сервисы должны предоставлять свои услуги через определённые порты.
Это уже давно стало стандартной практикой, и здесь мало что изменилось по существу. Более того: этот принцип поддерживают многие стандарты контейнеризации, прокси и балансировщиков нагрузки.
Основная идея в том, что у каждого приложения должна быть своя привязка к порту. Часто по номеру порта можно понять, что за сервис на нём работает — но это возможно только при сетевом сопоставлении контейнеров с хостами.
Смысл привязки приложения к порту состоит в том, что использование единообразного номера порта может быть лучшим способом открыть процесс для сети. Например, порт 80 по умолчанию используется для веб-серверов при работе по HTTP, а порт 22 — при работе по SSH.
Параллелизм
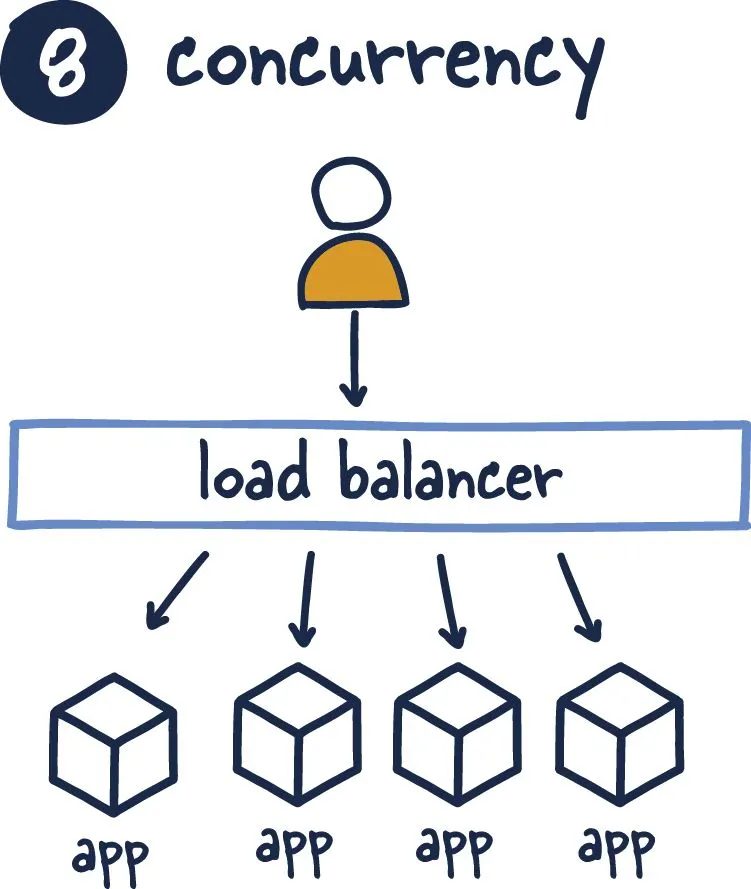
Параллельное выполнение процессов обеспечивается за счет масштабирования отдельных процессов.
Смысл параллелизма в том, что приложение должно организовывать каждый процесс в соответствии с его назначением. Инженеры могут добиться этого разделением процессов на группы.
Этот фактор обобщает различные аспекты горизонтального масштабирования. Много небольших машин справляются с рядом определённых задач лучше, чем несколько крупных. К новым подходам в этой области относятся, например, функции как услуга (functions as a service).
Ещё один важный вывод в том, что приложения должны организовывать параллелизм в зависимости от рабочей нагрузки, а приложения с конкурирующими нагрузками следует выносить отдельно и масштабировать независимо друг от друга.
Запуск и остановка без потерь
Для повышения надежности и отказоустойчивости системы рекомендуется быстрый запуск и остановка.
Этот фактор — важный элемент, о котором, как я часто вижу, вспоминают лишь когда система уже нуждается в нём. Проверки при запуске критически важны, чтобы убедиться, что система работает корректно. Проверки состояния (health checks) позволяют убедиться, что система остаётся в рабочем состоянии, а если нет — будет выведена из ротации.
Я наблюдаю такое же пренебрежение к деталям и при остановке сервиса. Это относительно сложный процесс, и здесь нередко звучит старый аргумент в духе «какая разница, чисто мы завершим процесс или нет, ведь он всё равно завершится».
На деле в распределённой системе неправильное завершение может вызвать каскадные последствия для зависимых систем. Кроме того, пренебрежение этим фактором может снизить надёжность системы и в итоге затронуть пользователей.
Паритет сред разработки и продакшена
Все условия должны быть максимально похожими друг на друга.
На мой взгляд, ситуация ухудшается по мере того, как мы переносим всё больше инфраструктуры в облака с привязкой к конкретному вендору. Разумеется, такие инструменты, как Docker и Kubernetes, делают среды разработки и продакшена похожими, но если разобраться в деталях, ситуация выглядит иначе.
Любой, кому приходилось отлаживать ошибку, воспроизводимую только в продакшене, может много рассказать об этом кошмаре. К сожалению, у вендоров облаков очень мало стимулов, чтобы сделать свои технологии открытыми: сама по себе закрытость (в виде модели «как услуга») — одно из главных преимуществ их предложения для клиентов.
Кроме того, попытка уместить все эти системы на машине, доступной каждому разработчику, сама по себе превращается в сизифов труд.
Логи
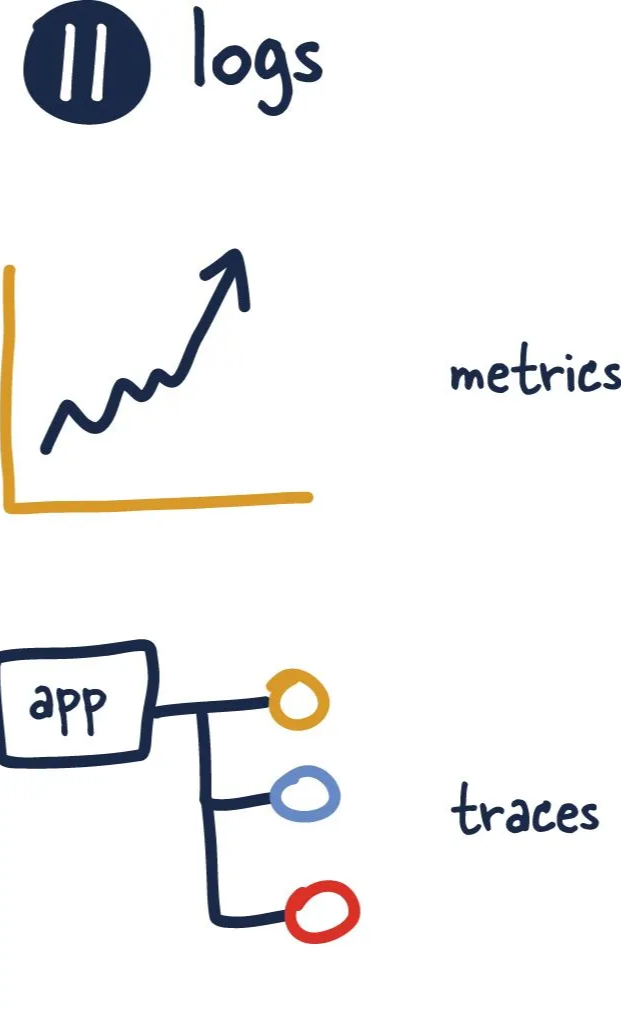
Приложения должны создавать журналы в виде потоков событий, а агрегирование данных должно осуществляться в среде выполнения.
Вокруг этого фактора выросла целая отрасль, хотя Адам описал его так, будто это чья-то чужая забота. Раньше логи считали просто выводом приложения, который кто-то подберёт и обработает. Теперь о логах обязано заботиться само приложение.
По мере роста приложениям нужно отслеживать логи, метрики и трассировки, чтобы по-настоящему понимать состояние своих систем и поддерживать их работу. Поэтому формулировку этого фактора, вероятно, стоит обновить: следует говорить о том, что приложение должно быть наблюдаемым без необходимости что-либо менять в самой системе.
Задачи администрирования
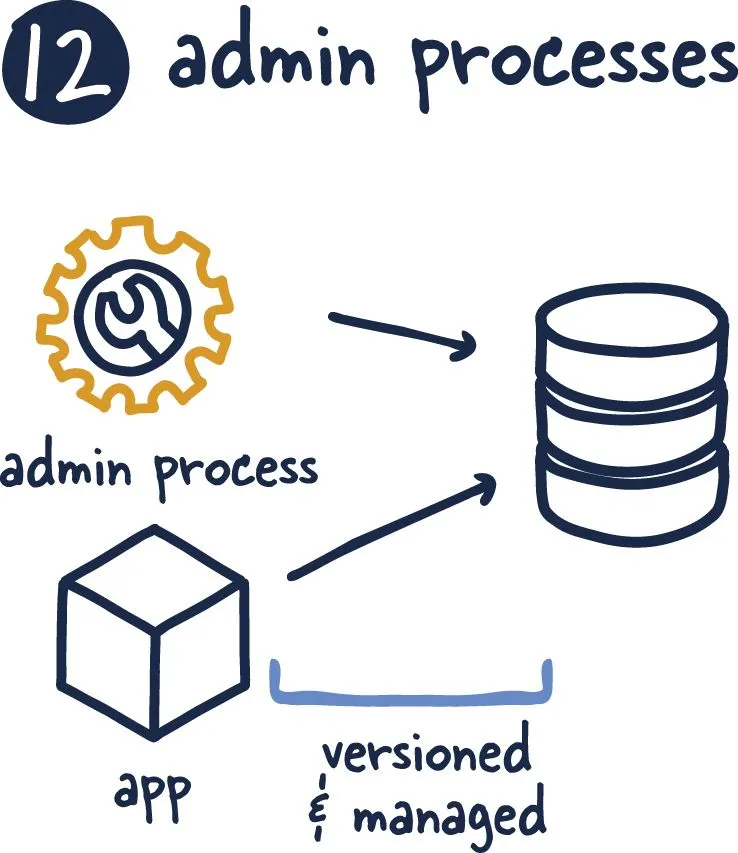
Все необходимые административные задачи следует хранить в системе контроля версий и включать в состав приложения.
Ко всему, что меняет состояние приложения, стоит относиться так же внимательно, как и к самому приложению: эти изменения необходимо тестировать и ревьюить.
Соблюдать это правило непросто — и его на удивление легко нарушить, когда горят сроки. Мне кажется, именно из-за этого происходит поразительно много аварий и тяжёлых разборов полётов
Более зрелые языки программирования и их фреймворки предлагают удобные механизмы для создания и тестирования административных процессов.
Однако если вы работаете с языком, который не предоставляет таких инструментов — их придётся создавать самостоятельно. Сюда входят процессы миграции, управление зависимостями и даже разовые задачи для очистки и обслуживания системы.
Принципы из этой статьи — фундамент. А на практике все архитектурные решения обосновываются конкретными цифрами: количеством запросов в секунду, объёмом данных за год, шириной канала…
Этим проблемам посвящён курс Хекслета «Системный дизайн». Пять месяцев практики и путь от монолита на одном сервере до распределённой платформы.
Отдельный модуль курса — секция System design на собеседованиях.
Автор курса — действующий SRE-инженер Виталий Лихачев.
Автор: darovska_online