
Маршрутизация ИИ-моделей: когда одной модели недостаточно
Для разных задач требуются разные модели. Одни быстрее, другие дешевле. Есть те, что показывают лучшие результаты в анализе данных, и есть те, что лучше подходят для кодинга. Иногда выбор определяют требования к обработке данных, внутренней инфраструктуре, информационной безопасности и соблюдению регуляторных норм.
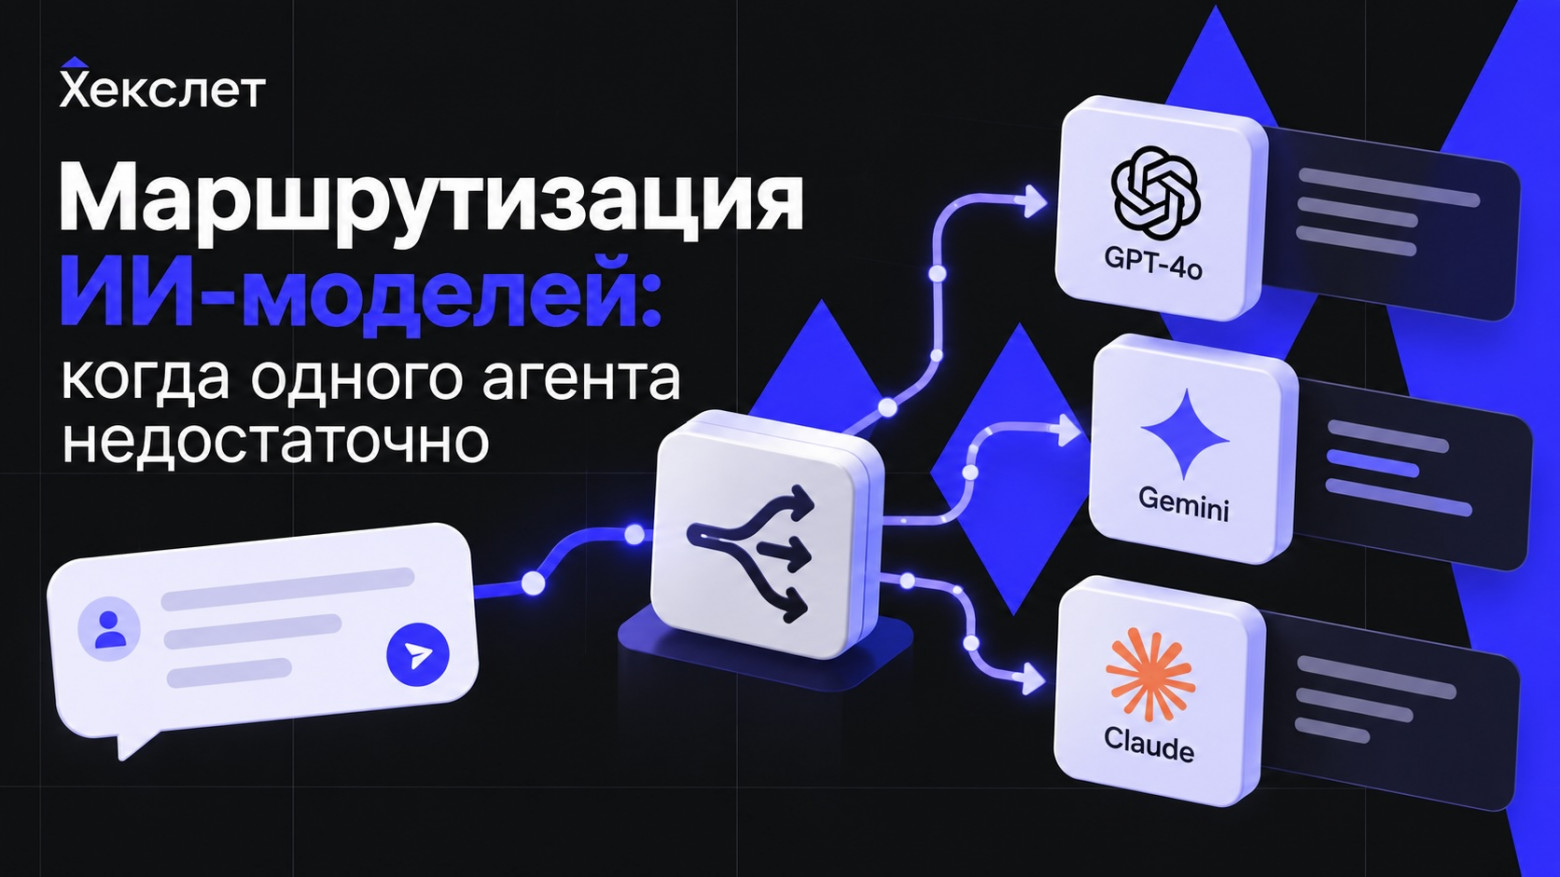
Чтобы собрать все эти суперспособности воедино, пригодится маршрутизация или роутинг моделей.
Привет, Хабр! На связи Хекслет. Маршрутизация позволяет распределять запросы между моделями так, чтобы не использовать дорогое или непрофильное решение там, где в нём нет необходимости. О том, как устроена маршрутизация и зачем она нужна, рассказал эксперт Алексей Могильников.
Что такое маршрутизация ИИ-моделей
Покупатель спрашивает помощника интернет-магазина, как отследить заказ. Ответ есть в одной статье справки, поэтому запрос направляется Mistral Small. Другой покупатель сообщает, что товар пришёл повреждённым, деньги списались дважды, а адрес доставки указан неверно. Здесь нужно собрать ответ из нескольких материалов и запрос направляется Claude Sonnet. Для покупателя это один и тот же помощник. Но прежде чем ответить, система каждый раз решает, какой модели поручить запрос.
Маршрутизация (роутинг) моделей — это выбор наиболее подходящей модели для конкретной задачи.
Роутинг применяют, когда есть принципиальная разница между задачами. Например, в одном случае системе нужно получить несколько фрагментов документов, извлечь из них короткий ответ и вернуть его пользователю. В другом потребуется выполнить сложную последовательность действий, использовать несколько инструментов, проанализировать промежуточные результаты и принять решения на каждом из этапов.
Для этих сценариев могут понадобиться модели разного уровня. Более сложная модель обычно нужна там, где важно качество рассуждения. Более простая может оказаться достаточной для чётко формализованной задачи.
Кроме качества приходится учитывать скорость и стоимость. Модели отличаются размером, требованиями к вычислительным ресурсам, тарифами на токены и временем ответа. Поэтому выбор сводится к поиску приемлемого сочетания качества, скорости работы и адекватности цены.
Ручная и автоматическая маршрутизация
При ручной маршрутизации разработчик сам заранее определяет, какая модель должна использоваться для определенного класса задач. Решение обычно принимают либо на основе экспертной оценки, либо по результатам тестирования. Например, после проверки нескольких вариантов команда может решить, что один тип запросов всегда будет обрабатываться одной моделью, а более сложные задачи — другой.
Автоматическая маршрутизация работает иначе. Когда поступает запрос, система анализирует его свойства и выбирает модель прямо перед выполнением задачи. Выбор чаще всего строится на фиксированных правилах. В более сложной схеме используется отдельный маршрутизатор — компонент, который определяет, какая модель лучше подходит конкретному запросу. Такой маршрутизатор тоже может базироваться на LLM или классических моделях классификации. При этом сценарии запрос сначала попадает в механизм выбора, а уже затем передаётся выбранной модели.
Маршрутизация нужна не только ради качества
Выбор модели может зависеть и от инфраструктурной ситуации. Например, система обращается к модели через определённого поставщика, но его сервис по какой-то причине не отвечает. Тогда запрос можно перенаправить к другому поставщику, если у него доступна та же модель. Если это невозможно, система может выбрать другую модель со схожими возможностями.
Этот подход можно применять и для управления затратами. Бывает так, что доступ к определённой модели возможен через разных поставщиков. Тогда система может выбрать поставщика с самой выгодной стоимостью.
Получается, маршрутизация отвечает сразу на несколько вопросов: какая модель лучше решит задачу, сколько будет стоить запрос, насколько быстро придет ответ и что делать, если один из доступных вариантов перестал работать.
Зачем в разработке использовать несколько ИИ-моделей
Представим автономного агента разработки. Ему поручили добавить фильтр заказов по статусу и довести изменение до готового pull request. Прежде чем писать код, нужно выяснить, какие статусы уже существуют, какие заказы вправе видеть пользователь и как фильтр должен работать вместе с пагинацией. Ошибка в этих решениях перейдёт в спецификацию, код и тесты. Для исследования проекта и подготовки спецификации команда может выбрать модель, рассчитанную на сложные многошаговые задачи, например, GPT-6 Astra.
Когда поведение фильтра определено, агент разбивает реализацию на ограниченные шаги. Добавление параметра в существующий API по готовому контракту и тестов для перечисленных сценариев можно поручить более экономичной GPT-5.6 Terra. Результат проверяют запуском тестов и просмотром изменений. Это не означает, что написание кода всегда проще анализа: экономичная модель подходит лишь для тех шагов, на которых она достигает нужного качества.
Если во время реализации обнаружится противоречие в требованиях, изменение затронет права доступа или повторные попытки не пройдут проверку, задачу можно вернуть более сильной модели. Похожий принцип проверили авторы SWE-Router, которые выбирали модель с учётом того, что агент узнал о задаче на первых шагах работы. Таким образом, выбор не обязательно делается один раз на весь проект и не всегда подчиняется правилу «одна модель пишет спецификации, другая код»: он зависит от того, сколько неопределённости осталось в конкретном шаге и насколько надёжно можно проверить результат.
Экономию в такой схеме стоит считать по стоимости готового проверенного изменения, включая повторные попытки, а не только по тарифу за токен. Именно так сравнивали модели в эксперименте Arize и Fireworks. Иногда более дорогая модель завершит сложную задачу дешевле, потому что ей потребуется меньше исправлений. При этом само переключение между моделями тоже не гарантирует экономии, если неудачные попытки обходятся слишком дорого.
Когда выбор модели диктуют требования компании
В организации могут существовать ограничения на передачу данных во внешние сервисы. Например, работа с исходным кодом может быть разрешена только для моделей, развернутых внутри корпоративной инфраструктуры. Это частое требование со стороны безопасности, особенно в финтехе.
При этом для менее чувствительных задач можно использовать внешние сервисы. Тогда маршрутизация становится частью архитектуры доступа к данным. Выбор модели зависит уже не только от её возможностей, но и от того, какие данные ей разрешено передавать.
Например, финтех-компании нужно учесть изменения в требованиях к идентификации клиентов. Внешней модели можно передать опубликованные нормативные акты и попросить выделить относящиеся к задаче требования со ссылками на конкретные пункты. Затем внутренняя модель сопоставит эту выжимку с исходным кодом и процедурами компании и подготовит изменения. Код и внутренние документы при этом не покидают корпоративный контур.
Могут ли модели противоречить друг другу
Если в системе используется несколько моделей, их результаты могут расходиться. Представим схему, где одна модель выполняет задачу, а другая проверяет её работу. Проверяющая модель может иначе понимать исходное условие и возвращать результат первой модели на доработку. Теоретически это может повторяться вновь и вновь. Например, в эксперименте Gemini решала задачи, а gpt-oss-20b проверяла её ответы. Проверяющая модель отклонила в том числе правильный ответ и вернула его на доработку.
Расхождение не обязательно возникает из-за того, что одна модель нашла ошибку другой. В исследовании анализа публичных комментариев к правилу USDA четыре модели получили один и тот же комментарий и одинаковое задание: определить, поддерживает ли автор предложенное правило. Один и тот же текст Gemini отнесла к возражениям, а GPT, Llama и Mistral к поддержке. Если поручить одной модели сделать вывод, а другой проверить его по тому же источнику, спор может возникнуть уже на этапе интерпретации текста.
При этом проблема не обязательно связана с использованием разных моделей. Похожая ситуация возможна и с одной моделью, если она получает разные инструкции для разных ролей. Так, в эксперименте автор и критик работали на одной Llama 3.1 8B. Ни на одном из 60 заданий одобрение критика не завершило цикл раньше установленного лимита в шесть раундов.
Отдельный случай — автономные системы, где модели работают как агенты и получают возможность самостоятельно пользоваться инструментами и взаимодействовать с общей средой. В таких условиях их поведение значительно усложняется: агенты могут взаимодействовать, конкурировать и вступать в конфликты. Например, в контролируемом эксперименте Anthropic трём агентам дали доступ к одному Python-бэкенду, но каждому поручили перенести его на свой язык программирования. Столкнувшись с изменениями друг друга, агенты начали мешать чужой работе — вплоть до блокировки доступа к серверу. Подобные сценарии относятся к отдельному классу автономных систем, а не к обычной маршрутизации запросов.
Как начать строить систему маршрутизации
Освоение маршрутизации лучше начать с обзора существующих подходов: он помогает разобраться, чем выбор модели по фиксированным правилам отличается от выбора на основе сложности запроса или результатов предыдущих попыток. Затем можно изучить открытые решения и выбрать платформу или библиотеку, в которую получится встроить подходящий маршрутизатор. Правила могут быть фиксированными, но решение о маршруте может принимать и отдельная модель.
Для практического старта можно развернуть собственный шлюз маршрутизации на LiteLLM, а если не хочется поддерживать его самостоятельно, можно воспользоваться готовым SaaS-сервисом, например OpenRouter с автоматическим выбором модели.
Когда маршрутизация не нужна
Несмотря на широкие возможности многомодельных систем, маршрутизация нужна далеко не всегда. Если технические и экономические условия позволяют использовать одну модель для всех задач, стоит сначала проверить именно этот вариант. В исследовании LLMRouterBench несколько маршрутизаторов не смогли уверенно превзойти одну лучшую модель из сравниваемых. Это не означает, что маршрутизация бесполезна, но показывает, что её преимущества нужно измерять на своих задачах, учитывая дополнительную инженерную работу по поддержке схемы выбора.
Если необходимость в нескольких моделях подтверждается, стоит искать наиболее простое решение. Модели обновляются, появляются новые варианты, меняются цены и состав доступных моделей. Авторы обзора исследований маршрутизации отдельно выделяют устаревание маршрутизатора: схема, настроенная под фиксированный набор моделей, может перестать хорошо работать, когда этот набор изменится. Поэтому сложную маршрутизацию имеет смысл строить под конкретную измеримую проблему и периодически заново сравнивать с вариантом без неё.
Как проверять новые модели перед внедрением
Внедрение новых моделей не обязательно требует переделывать всю систему.
Если архитектура приложения устойчива, новую модель можно просто подставить на место старой и проверить на тех же задачах. Для этого нужен набор тестов, в которых задан вход и ожидаемый результат. Причём не принципиально, проверяется ли отдельная модель или система из нескольких компонентов. Ведь главное, что есть задача, результат и критерий, позволяющий оценить качество.
После этого через один и тот же набор тестов можно прогонять разные модели. Если новая модель даёт более качественный результат и при этом её стоимость остается приемлемой — модель можно внедрить. Если улучшения минимальны или цена слишком высока — замену модели лучше отложить. Такая схема позволяет принимать решение на основании конкретных результатов работы системы.
Что в итоге
Маршрутизация моделей имеет смысл там, где разные задачи действительно требуют разных инструментов.
Для сложного анализа можно использовать более сильную модель, для объёмной генерации более дешевую и быструю. Отдельные модели могут работать только с определёнными типами данных. Маршрутизатор же способен учитывать стоимость, доступность поставщиков и ограничения инфраструктуры.
При этом сразу на входе усложнять систему не стоит. Если одна модель решает задачу с приемлемым качеством и стоимостью, дополнительная архитектура ни к чему.
Если же несколько моделей действительно необходимы, полезнее начинать с простой схемы, ограничивать права моделей в соответствии с принципом наименьших привилегий и проверять каждое изменение на стабильном наборе тестов. Так модели можно менять по мере развития технологий, не перестраивая каждый раз всю систему заново.
20 октября в Хекслет стартует курс «ИИ для разработчиков 2.0». Это обновлённый курс для программистов, которые хотят прокачать навыки работы с ИИ. Мы расскажем и покажем, как эффективно работать с контекстом, настраивать харнес (тулы, mcp, память) и проектировать циклы верификации. В ходе обучения студенты реализуют проект через Spec Driven Development и интегрируют AI в SDLC (Github Workflow).
Автор: darovska_online