
В вайбкодинге агент почти не читает документацию без ссылки: 57 файлов из 88 он не открыл ни разу
В вайбкодинге документацию первым читает агент, и открывает он почти только то, на что ему сослались. По журналам Claude Code одного моего проекта файлы без входящей ссылки агент открывал в среднем 1,2 раза, а 57 из 88 таких не открыл ни разу.
Раньше документацию писали в конце цикла, и читал её человек. В вайбкодинге код пишет агент, и получает он только то, что ему подали. Я посчитал по журналам за пять недель, какие markdown-файлы агент открывал. Точкой входа ниже называю то, чем агента запускают на задачу: файлы слеш-команд в .claude/commands и описания субагентов в .claude/agents. Документы, названные в точке входа, агент открывал в среднем 12,3 раза.
Как посчитать по журналам Claude Code, какие markdown-файлы открывал агент
Журналы лежат локально в ~/.claude/projects/ в jsonl, в них записан каждый вызов инструмента. За пять недель набралось 112 сессий и 472 запуска субагентов. Дальше запуском я называю любой из них, всего их 584.
Скрипт считает открытия .md через Read и через cat, head, tail, sed в Bash. Путь берётся от корня репозитория, чтобы одноимённые README.md из разных папок не слились в один счётчик. Список документов приходит из git ls-files. Файл попадает в группу со ссылкой, если точка входа упоминает его путь или имя. Ещё один случай — шаблон пути вроде guides/{тема}.md: тогда в эту группу идут все файлы папки. Сам CLAUDE.md в группы не входит, он грузится без ссылок.
import glob, json, os, re, subprocess
from collections import Counter

REPO = os.getcwd() + "/"
LOGS = os.path.expanduser("~/.claude/projects/" + re.sub(r"[^A-Za-z0-9]", "-", REPO.rstrip("/")))
SHELL_READ = re.compile(r"(?:cat|head|tail|sed -n S+)(?: -S+)*s+"?([^s"|;]+.md)")

reads = Counter()
for path in glob.glob(LOGS + "/**/*.jsonl", recursive=True):
    for line in open(path, errors="ignore"):
        if '"tool_use"' not in line:
            continue
        for b in json.loads(line).get("message", {}).get("content") or []:
            if not isinstance(b, dict) or b.get("type") != "tool_use":
                continue
            args = b.get("input", {})
            files = ([args.get("file_path", "")] if b["name"] == "Read"
                     else SHELL_READ.findall(args.get("command", "")) if b["name"] == "Bash" else [])
            for f in files:
                f = f if f.startswith("/") else REPO + f
                if f.startswith(REPO) and f.endswith(".md"):
                    reads[f[len(REPO):]] += 1

git = ["git", "-c", "core.quotePath=off", "ls-files", "-z", "*.md"]
docs = subprocess.run(git, capture_output=True, text=True).stdout.split("")[:-1]
entry = [d for d in docs if d.startswith((".claude/commands/", ".claude/agents/"))]
entry_text = "".join(open(d).read() for d in entry)
templates = re.findall(r"([w.-]+)/{[^}]+}.md", entry_text)   # guides/{тема}.md

def named_in(d, text):
    return d in text or os.path.basename(d) in text

linked = [d for d in docs if d not in entry + ["CLAUDE.md"] and (named_in(d, entry_text)
          or os.path.basename(os.path.dirname(d)) in templates)]
claude_md = open("CLAUDE.md").read() if os.path.exists("CLAUDE.md") else ""
toc_only = [d for d in docs if d not in entry + linked + ["CLAUDE.md"] and named_in(d, claude_md)]
orphans = [d for d in docs if d not in entry + linked + toc_only + ["CLAUDE.md"]]
for name, group in [("точки входа", entry), ("названы в точке входа", linked),
                    ("только в оглавлении CLAUDE.md", toc_only), ("без ссылки", orphans)]:
    avg = sum(reads[d] for d in group) / len(group) if group else 0
    print(name, len(group), "файлов, в среднем", round(avg, 1))
print("ни разу не открыты:", *[d for d in orphans if reads[d] == 0], sep="n  ")
Под git в проекте 162 markdown-файла, агент открывал их 898 раз.
Как часто агент открывал файл в зависимости от того, кто на него ссылается
Чаще всего агент открывал документы, названные в точке входа: таких 53, в среднем по 12,3 открытия. Сами файлы команд и субагентов, всего 15, он открывал по 7,2 раза. Пять файлов, на которые ссылается только оглавление в CLAUDE.md, набрали по 3,0. У файлов, на которые не ссылается никто, среднее 1,2.
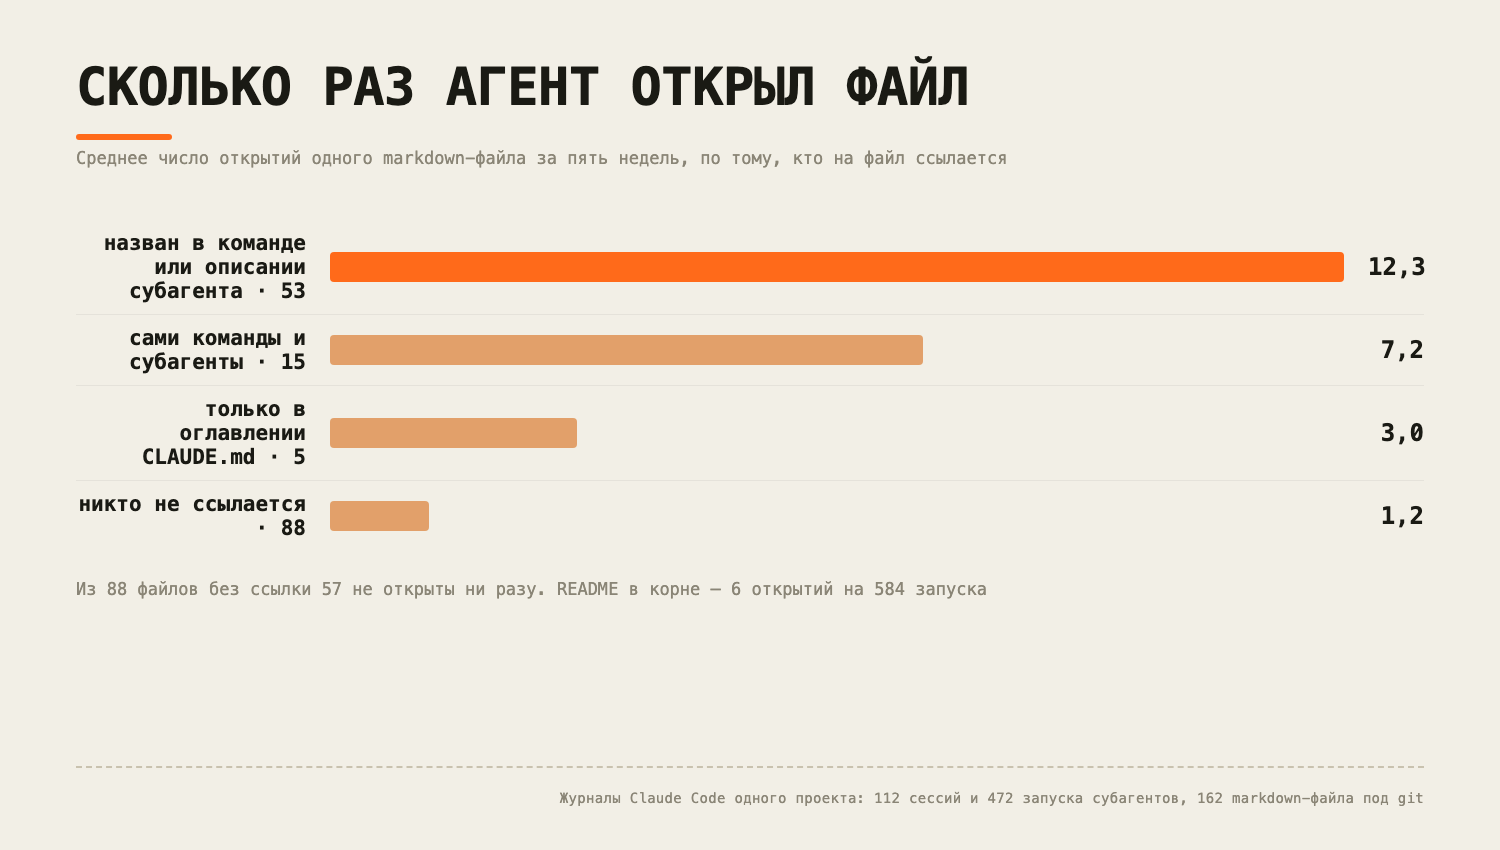
Ссылка из точки входа выглядит как обычная строка в файле слеш-команды, например: Перед стадией визуалов прочитай docs/visuals.md. Файлы, названные так, и дают те самые 12,3 открытия.
README.md в корне открыт 6 раз на 584 запуска. Он написан для человека с улицы, а агенту его никто не показал.
Среди файлов без ссылок нашлись исключения: один открыт 15 раз, ещё два по 11. Имена у всех трёх прямо про задачу. Возможно, агент находил их по имени, но в журналах этого не видно.
Человек читает документ, когда тот понадобился: на онбординге, при разборе бага. Агент каждый запуск начинает с чистого контекста и о проекте знает только то, что получил в этом запуске. Поэтому документирование переезжает из конца цикла в начало и становится настройкой входа: какие файлы агент увидит на старте, какие получит по ссылке, какие не получит совсем.
Что Claude Code кладёт в контекст сам, без ссылки
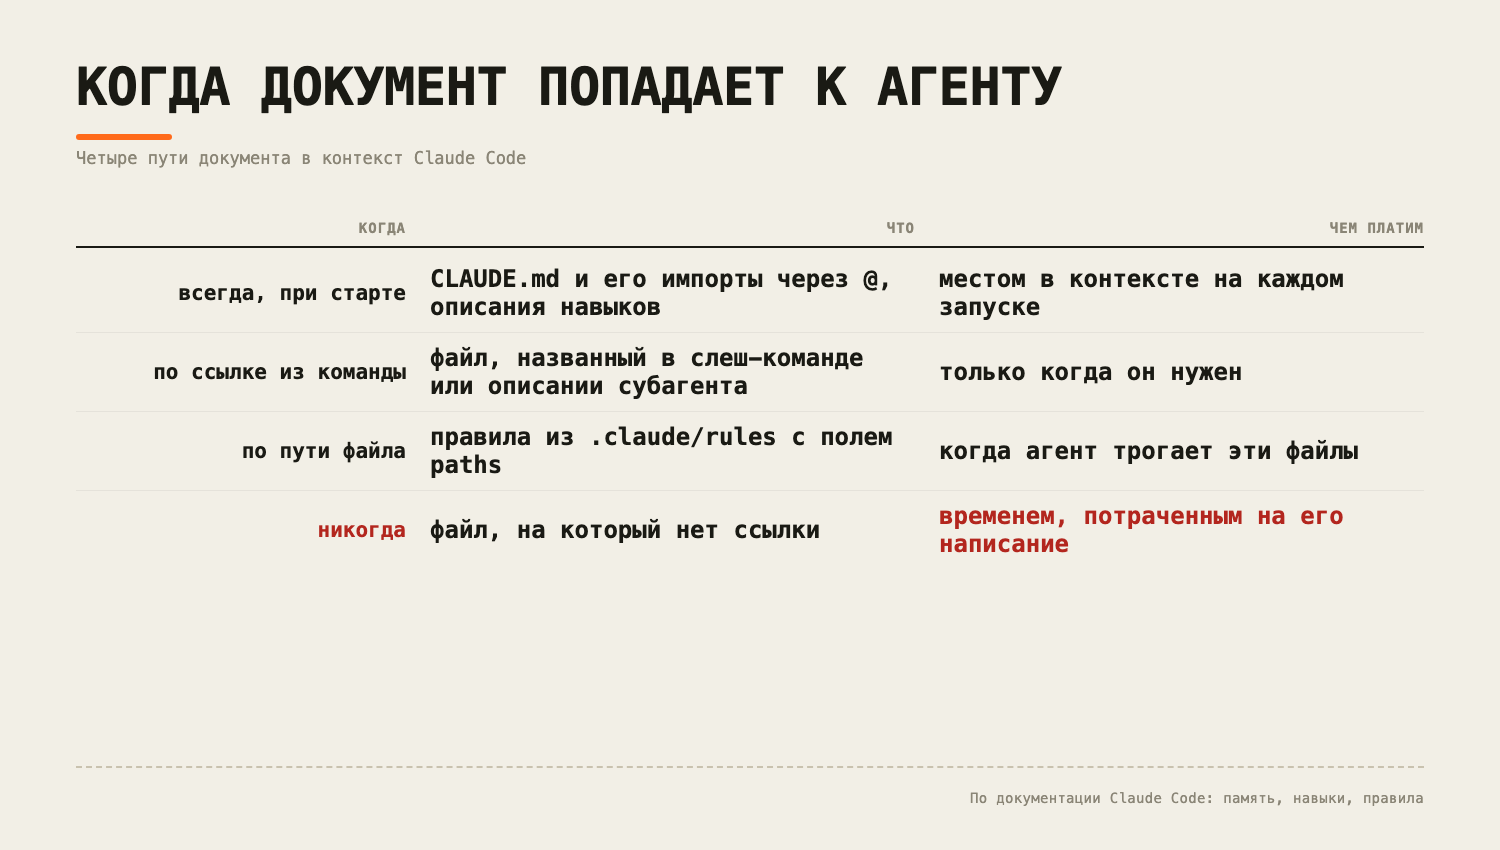
CLAUDE.md подгружается целиком в начале каждой сессии, импорты через @ приходят вместе с ним. Правила из .claude/rules с полем paths: подтягиваются, когда агент работает с подходящими файлами, а от навыка в контексте всегда висит только описание. Остальное агент читает, если его привели. У постоянной загрузки есть цена: ответ модели ухудшается по мере роста входа, так что лишний файл в CLAUDE.md мешает на каждом запуске.
Почему исследования про AGENTS.md расходятся в оценке пользы
Работа на 10 репозиториях нашла, что с AGENTS.md медианное время задачи ниже на 28,64%. ETH Zürich на другом наборе задач роста доли решённых не увидела, а стоимость вывода там выросла больше чем на 20%. Первая работа смотрела на скорость правок, вторая на то, решена ли задача. Сходятся они в одном: инструкции из файла агент выполняет, а обзор репозитория ему не помогает. Если использовать ИИ для документации так, как это делают чаще всего, и попросить модель описать репозиторий, получится как раз такой обзор.
Как решить, что из документации попадёт в контекст агента
-
Держите CLAUDE.md коротким: только то, без чего агент ошибётся. Anthropic советует до 200 строк. Мой разросся примерно до двух сотен, и сокращать его мне ещё предстоит.
-
Остальное отдавайте по ссылке в тот момент, когда оно нужно: из слеш-команды, описания субагента, навыка или правила с
paths:. Описание навыка пишите как условие срабатывания, ведь по нему агент решает, вызывать ли навык. -
Файл без входящей ссылки не удаляйте сразу, сначала посмотрите его по журналу. У меня три таких файла открыты 15, 11 и 11 раз, их правильнее привязать к команде.
-
Правило, которое нельзя забыть, переносите в хук: он проверяет каждый вызов инструмента. CLAUDE.md выполнение не гарантирует.
-
Раз в месяц прогоняйте скрипт выше: последней строкой он печатает файлы, которые агент ни разу не открыл. Месяц выбран не случайно: по умолчанию Claude Code хранит журналы 30 дней, это настройка
cleanupPeriodDays. -
Документацию внешних библиотек подавайте в момент вызова. Среди инструментов ИИ для вайбкодинга это делает Context7, а сайт библиотеки может отдать её модели в формате llms.txt.
Почему журналы одного проекта не доказывают, что работает сама ссылка
Это корреляция: в точке входа называют как раз те файлы, которые нужны для задачи, и часть разницы объясняется этим. Подсчёт через Bash ловит не все чтения, grep по файлу я не считал. Проект один, и агент тоже один.
Автор: sburyi