
Как мы 3+ года пытались подружить AI с разработкой: от провалов к Spec-Driven
Привет, Хабр! Меня зовут Родион, я руковожу отделом по анализу данных в Лаборатории данных компании «Синимекс».
В этой статье хочу поделиться нашим практическим опытом и эволюцией подходов применения различных сценариев использования LLM в нашей работе. Спойлер — не обошлось без набитых шишек)
В настоящий момент айтишечка переживает очевидный хайп вайб-кодинга и агентской разработки, термин “вайб-кодинг” появился в 2025, а наш первый основательный “подход к снаряду” датируется 2023 годом.
2023: пробуем метрики
Кейс 1. CDT
У нашей компании есть продукт CDT aka Cinimex Development Tool, представляющий из себя инструмент для оптимизации процессов разработки ПО. Он позволяет крупному бизнесу и ИТ-отделам сократить расходы на создание программных продуктов и ускорить вывод решений.
В 2023 году стали набирать популярность LLM и у нас появилась идея поискать сценарий использования LLM в нашем продукте
Начали обсуждать:
— Что именно можно сделать?
— Где искусственный интеллект действительно способен помочь?
Возникла гипотеза — у наших заказчиков огромное количество технических заданий. Документы бывают весьма объемными, написанными при этом в разных стилях и с разной структурой. Аналитикам приходится тратить часы на разбор текста с целью выделения требований, сущностей, зачастую из нескольких файлов.
Сейчас такого рода задачи решаются LLM “из коробки”, но в тот момент мы решили использовать NER подход (Named Entity Recognition), взять большую языковую модель и научить её автоматически разбирать технические задания:
-
выделять требования;
-
находить ключевые сущности;
-
помогать аналитикам и архитекторам.
Мы собрали достаточно большую выборку ТЗ — большие и маленькие; хорошо структурированные и с большим количеством “воды”. Провели разметку и некоторое количество десятков экспериментов.
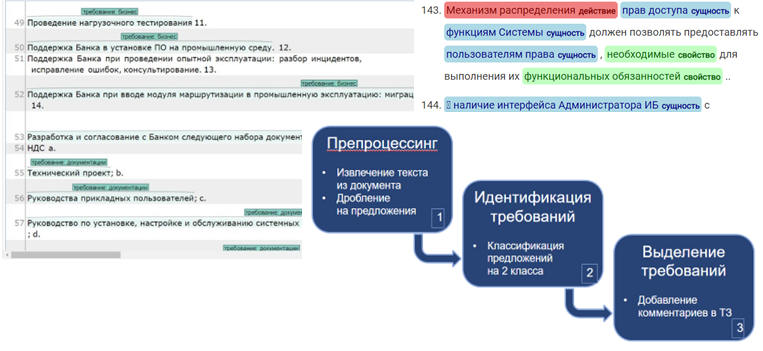
Внутренние тесты показали метрики ROC-AUC 0.7 и F1 0.61. Метрики не вау, но уже кое-что. «Неплохо» — подумали мы и пошли презентовать решение целевой аудитории пользователей фичи — аналитикам и архитекторам. Они посмотрели и охладили нас, сказав примерно следующее:
«Ребята, мы понимаем, что у вас хорошие метрики. Возможно, вы сможете сделать их ещё лучше. Но если система ошибается хотя бы в двадцати процентах случаев, нам всё равно приходится полностью перепроверять результат вручную. Если всё нужно проверять самостоятельно, то практической ценности почти нет.»
То есть с точки зрения исследователей всё развивалось успешно, а с точки зрения конечного пользователя — нет. Даже хорошие метрики не означали, что продукт действительно помогает людям работать быстрее.
Пользователи не пытались интерпретировать наши ML-метрики. Их критерий был проще: если результат нельзя принять без полной ручной перепроверки, инструмент не экономит время. Конечно, это было немного обидно, но именно тогда появился первый важный вывод:
Хорошие метрики модели еще не означают высокую ценность для бизнеса, а качество AI-функции нужно измерять не только качеством ответа модели, но и стоимостью проверки этого ответа человеком.
Кейс 2. CTT
После истории с CDT к другому нашему продукту CTT aka Cinimex Test Tool мы решили подходить уже с “генеративной” составляющей LLM и отталкиваться от прямого диалога с потенциальной целевой аудиторией — тестировщиками.
Мы провели брейнштормы, отобрали сценарии по критериям бизнес-ценности и реалистичности, сделали прототип на Open Source моделях и ChatGPT, подготовили документы на согласование. Дальше мы планировали подключить проектную Wiki и интегрировать модуль с CDT.
Прототип работал, тесты генерировались, но затраты на развитие решения перевесили ценность для бизнеса. Проект не получил развития.
Кейс 3. Ассистент по базе знаний
На этот раз мы работали с цифровым ассистентом для первой и второй линии поддержки банка из Топ-20 — эти линии тонули во внутренних регламентах. Начали с PoC: взяли нормативную документацию из открытых источников и проверили саму гипотезу — может ли нейросеть отвечать на вопросы по базе знаний. По сути, это классическая RAG-система еще до того, как такие решения стали массовыми.
Подход оказался жизнеспособным, и мы перешли к MVP на реальных данных банка: собрали внутренние инструкции и нормативные акты одного подразделения, дообучили модель на этом датасете и отдали сотрудникам на апробацию. Подразделение начало пользоваться системой, и инициатор проекта сказал: «работает». Однако попытка масштабировать решение на соседние подразделения восторга не вызвала: «Нам оно зачем?». Пилот не получил поддержки и остановился.
Подытог-2023. Мы оптимизировали модель, а нужно было оптимизировать работу человека
К концу 2023 года мы усвоили два правила:
-
хорошие метрики не равно ценность готового решения
-
успешный пилот — еще не доказательство масштабируемости сценария
2024: от локальных PoC к корпоративному использованию AI
Кейс 1. Нишевые языки
Мы решили поискать ценность со стороны разработки и сделать инструмент LLM-based, встроенный в IDE, для генерации кода на RPGLE и COBOL.
Проблема заключается в том, что специалистов по таким “нишевым” языкам становится всё меньше. Стек существует, как и немалое количество систем, на нем написанных. Они продолжают использоваться, но развивать и поддерживать их становится всё сложнее.
Идея состояла в разработке инструмента генерации кода, встроенного прямо в IDE. Чтобы разработчик мог получать:
-
автокомплит;
-
генерацию кода;
-
помощь при написании тестов;
-
возможность дообучать модель под особенности конкретного проекта.
Мы проанализировали актуальные на тот момент LLM, собрали датасет для дообучения (источниками выступили репозитории GitHub с RPGLE, датасеты The Stack v2, внутренние репозитории GitLab Cinimex) и отработали методику дообучения. И вот здесь впервые получили результат, которым действительно остались довольны. Получился полноценный Proof of Concept — модель была встроена в IDE и она действительно начала помогать разработчикам.
Кажется, тут случился наш первый успех в этом направлении. Доставка ценности состоялась)
Кейс 2. AI стратегия
В это же время LLM уже осуществлял ползучую экспансию в умы и повседневную жизнь не только разработчиков. Компания у нас большая, команд много, каждый начинает использовать AI по-своему. Кто-то работает с ChatGPT, кто-то пробует GitHub Copilot, кто-то использует локальные модели, кто-то вообще ничего не использует (вопиюще в эпоху AI Adoption).
Пока это эксперименты — не проблема. Но если учесть, что код наших проектов принадлежит заказчикам, а в репозиториях лежит коммерческая информация, то вести промышленную боевую разработку в публичных сервисах нельзя от слова совсем.
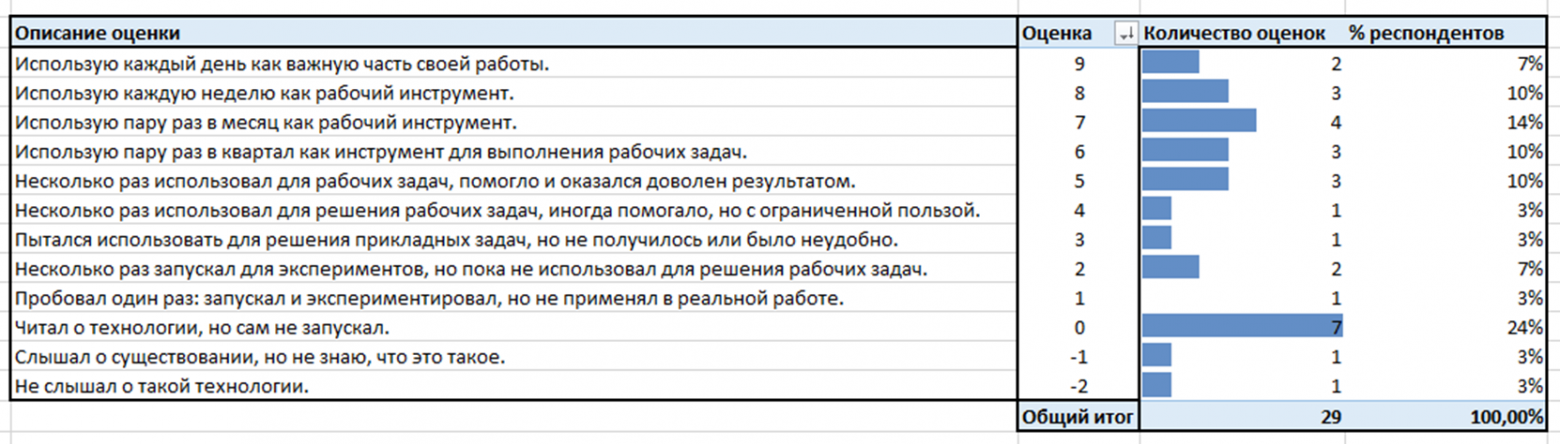
В компании был проведен большой внутренний опрос, ниже я приведу срез по нашему подразделению (Лаборатория Данных). Результаты оказались противоречивыми (см. рис. 2):
-
69% сотрудников видели пользу в LLM, причем 45% использовали LLM еженедельно.
-
Основные сценарии использования: копирайт, брейншторм, ресерч.
-
При этом совершенно неожиданно оказалось, что различные Code Assistants работают плохо. Усредненный опыт ограничивался формулой «попробовал несколько раз». Разработчики в целом сказали так: «Пишет код на уровне джуна. Мне проще самому написать этот кусок кода, чем потом разбираться, что сгенерировала модель».
Подытог-2024. AI стал полезным — и сразу возникла проблема масштаба
Команды уже использовали AI самостоятельно, но набор инструментов, сценарии и правила работы отличались. То есть adoption уже начался без централизованного управления.
2025: промпт-инжиниринг и контекст
Кейс 1. ИИ тренер для поддержки продаж
В 2025 году мы начали работать над прикладной задачей, далекой от кода — нужно было прокачивать коммуникативные навыки торговых представителей — людей, которые разговаривают с продавцами, рассказывают о брендах и работают с возражениями.
Мы разработали AI-тренера: виртуального клиента, который ведет диалог от приветствия до финальной договоренности, возражает, проверяет аргументы, а после разговора разбирает ошибки — что получилось, где провал, что подтянуть.
Продукт дошел до стадии MVP с измеримыми KPI: частота офферов у консультантов растет минимум на 15%, конверсия из оффера в пилот — минимум на 20%.
То есть мы впервые заговорили не о субъективном ощущении пользы, а о настоящих бизнес-метриках.
Конечно, на проекте не все шло гладко. Например, архитектуру пришлось переписывать несколько раз, потому что модели обновлялись быстрее, чем мы успевали собирать решение. Более того, когда отранжировали возникающие проблемы, вдруг выяснилось, что архитектура лишь на 3-м месте. RAG занял 2-е, а тюнинг промптов — 1-е.
Так мы пришли к выводу, что поменять модель или пересобрать архитектуру оказалось проще, чем точно сформулировать для нее задачу. То есть качество итогового диалога определяла не столько модель «под капотом», сколько точные описания в промптах роли тренера, правил возражений и формата разбора ошибок.
Spec-Driven все ближе и скоро нам представится случай проверить этот вывод еще раз, причем в одной из самых закрытых экосистем, а если кейс с ИИ тренером вас заинтересовал — подробности в публикации Вадима на хабре.
Кейс 2. 1С
Обычно агентская разработка ассоциируется с Python или JavaScript, но существуют не только нишевые языки программирования, о которых я рассказывал выше. Есть популярные в России экосистемы, кодовой базы которых вы не найдете в GitHub) В энтерпрайзе значительная часть бизнес-процессов автоматизирована на семействе 1С. Эта платформа не приветствует прямого вмешательства во внутреннее устройство, и я был немало удивлен наличию у 1С современных инструментов.
Появились:
-
механизм EDT (Enterprise Development Tools), который открывает агенту структуру проекта, исходный код и весь инженерный контекст,
-
интеграция через MCP, превращающая агента из чата в участника процесса разработки.
Если вам интересен симбиоз 1С и агентов рекомендую к прочтению статью коллеги.
Подытог-2025. Модель уже не главное
Генерация сама по себе перестала быть дефицитом. Ценность сместилась в качество постановки задачи, контекст и правила работы агента.
2026: Spec-Driven
К 2026 году AI эволюционировал из эксперимента в часть повседневной работы, приведу несколько свежих цитат от коллег, различных ролей и грейдов, все они из разряда “основано на реальных событиях”:
-
LLM обманщик, конечно, сильный, но и помогает хорошо, для опытного разработчика хороший помощник.
-
Задачи Системного аналитика, такие как написание ТЗ, подготовка High-level Design (HLD), формулирование требований, подготовка диаграмм итд, стали занимать гораздо меньше времени. Время на подготовку HLD для одной фичи снизилось в 1.5-2 раза. Роль СА всё больше смещается в сторону, когда самая сложная работа — это собрать правильный контекст у стейкхолдеров.
-
Применение LLM на ревью кода выявляет уязвимости и повышает качество кода. Существенно сократилось время код-ревью, а качество замечаний вполне адекватное.
-
Можно пилить небольшие проекты в соло
Мы не отрицаем сам подход вайб-кодинга и полет фантазии в парном программировании с ИИ, в чистом виде такой подход годится для прототипирования: там цена ошибки — переделка, в боевом проекте — несоразмерные издержки на дебаг и поддержку.
К 2026 году мы смогли сделать три вывода:
-
Результат зависит от точности постановки задачи — это показал ранжированный список проблем при разработке AI-тренера.
-
Агенту нужен контекст проекта, а не текстовое поле — это подтвердила практика коллег по 1С.
-
Массовое использование без общего инженерного контура оказалось фрагментарным и плохо масштабировалось — это мы поняли из ответов респондентов.
Все три вывода упираются в одну идею: постановка задачи, контекст и правила должны перестать быть одноразовыми промптами и стать артефактами проекта.
При таком положении вещей код перестает быть основным активом разработки. Чем дешевле становится его генерация и переработка, тем ценнее становятся формализованные требования, ограничения и архитектурные решения.
Спецификация становится единым контекстом и точкой синхронизации между человеком и AI: архитектура, спецификация и стратегия реализации остаются в зоне ответственности инженера, и генерация кода превращается в последний шаг, а не в отправную точку.
Про Spec-Driven достаточно много публикаций, и не претендуя на открытие Америки, приведу тезисный подход, а коллеги разовьют в следующих публикациях с примерами из боевых проектов.
Допустим, нужно реализовать сервис загрузки документов. В prompt-driven подходе разработчик пишет агенту задачу текстом. В Spec-Driven сначала фиксируются роли, ограничения, NFR (non-functional requirements — нефункциональные требования), интерфейсы и acceptance criteria, после чего агент работает уже внутри этого набора артефактов.
Ниже — список шагов, который мы применяем в работе: что делаем на каждом этапе этой цепочки, какие артефакты после него остаются и какие вопросы задаем себе перед переходом к следующему.
|
Шаг |
Что делаем |
Артефакты |
Ключевые вопросы |
|
1. Определить миссию |
Превращаем запрос в ТЗ(PRD). Формируем цели, пользователей, ограничения, риски |
ТЗ(PRD) в Markdown, диаграмма целей (PlantUML),
|
Кто потребляет результат? Какие бизнес-риски критичны? |
|
2. Сформулировать правила |
Создаем паспорт проекта: принципы, NFR, бизнес-правила |
таблица требований, список must-have |
Какие условия должны выполняться в любом варианте решения, независимо от способа реализации? |
|
3. Допущения и ограничения |
Исследуем инструменты, архитектуры, собираем контекст |
Таблица сравнения ( список рисков |
Какие технологии укладываются в ограничения (on-prem, NDA, 1С)? |
|
4. Пересмотр плана |
Архитектурный Review: стресс-тест допущений, поиск дыр в дизайне |
|
Какие сценарии нарушают спецификацию? |
|
5. Критика |
Ищем недостающие требования, уточняем метрики валидации |
список доработок |
Какие требования скрыты в бизнес-процессе? |
|
6. Генерация кода |
Передаем собранный контекст агенту/LLM |
Docker-образ,
|
Как убедиться, что код соответствует спецификации? |
Примечание. Наша цепочка — не единственно возможная: структура и состав этапов зависят от инструмента. Например, в открытом фреймворке Spec Kit та же логика упакована в команды:
-
/speckit-constitution— определить миссию; -
/speckit-specify— собрать структурированную спецификацию из словесного описания; -
/speckit-plan— построить план решения и провести исследования; -
/speckit-tasks— разбить план на задачи; -
/speckit-clarify— проанализировать документы на непротиворечивость, целостность и недоопределенность.
Шаги и артефакты могут быть своими — принцип один: сначала спецификация, потом код.
Итоги. Контекст становится частью проекта
Помните аналитиков, которые в 2023-м отказались проверять чужие ошибки? Вайб-кодинг без инженерного контура превращает каждого разработчика в такого аналитика : вместо написания кода он делает ревью сгенерированного, и отладка съедает больше времени, чем экономит генерация.
От подхода «а давайте добавим немного ML» в 2023-м мы дошли до процесса, в котором модель — исполнитель внутри описанных рамок.
То есть работает не столько модель, сколько контур вокруг нее.
Если у вас есть собственные истории приручения AI — удачные и не очень — расскажите в комментариях: наш чек-лист собран из граблей, и ваши могут его дополнить.
Автор: 0rbital