
От ручного SEO к офису AI-сотрудников, как выстроить оркестрацию
Качественный продукт обретает реальную ценность только тогда, когда им начинают пользоваться люди. SaaS, браузерному инструменту или мобильному приложению нужны ясная страница, путь к целевому действию и способ привлекать людей. Для продукта, который рассчитывает на органический поиск, начинается отдельная работа, разобраться в запросах, изучить выдачу, подготовить содержание, внедрить его и посмотреть, что произошло после публикации. ИИ помогает на каждом из этих участков, но между ними остаётся разработчик, который переносит ответы, уточняет задания, сверяет предложенные пути с проектом, просит переписать текст и передаёт результат агенту, который меняет код.
В этом году я попробовал максимально автоматизировать эту работу. Получились три последовательных подхода, собственный YAML-оркестратор, внешний workflow на Dify с Tavily и офис AI-сотрудников с распределённой ответственностью. SEO оставалось задачей, для которой последовательно менялось устройство оркестрации.
Первый подход, описать процесс и исполнить его
Orchestrix начинался как локальный сервис на Django. Внешний архитектурный чат составлял YAML с шагами, ролями, инструкциями и правилами передачи входных данных. Сервис импортировал описание в базу, показывал его в Django admin и последовательно запускал шаги через OpenAI Agents SDK.
Для SEO-страницы цепочка включала исследование, спецификацию, генерацию JSON, обработку языка, ревью, исправление, план интеграции и финальное задание для Codex. Каждый из восьми шагов получал отдельное задание и передавал результат дальше.
У каждого шага был собственный контракт. Ниже сокращённый фрагмент исходного YAML для исследовательской роли.
  slug: research
  title: Research
  order: 1
  agent_role: seo_researcher
  agent_instructions: |
    You create a compact SEO research brief for one page topic.
    Return markdown only.
    Do not generate SEO JSON. Do not write final page copy.
    Do not claim competitor pages were read unless fetched text is provided.
Инструкции отделяли исследование от написания страницы. В описание также передавались факты целевого проекта, как фреймворк, реальные маршруты и расположение контента. Это нужно потому, что заданный путь к файлу может не иметь отношения к конкретному репозиторию.
Сам вызов модели занимал несколько строк. Ниже фрагмент без обработки ошибок и учёта расхода.
agent = Agent(
    name=pipeline_step.agent_role,
    instructions=pipeline_step.agent_instructions,
    model=run.pipeline_instance.default_model,
)
result = Runner.run_sync(agent, prompt_text)
Вокруг этого вызова пришлось построить инфраструктуру: экземпляры процессов, шаги, запуски, состояния, артефакты и записи расхода токенов. Результаты сохранялись в базе и файлах. Можно было посмотреть промежуточный ответ и повторить конкретный шаг. Повторный запуск удалял сохранённые результаты этого и последующих шагов, чтобы не оставить в цепочке артефакты от старой версии входа.
В сохранённых результатах было видно, какое задание получила модель и что передала дальше. Но автоматизация заканчивалась на подготовке Codex Handoff. Внедрение во фронтенд оставалось отдельной работой, успех которой зависел от полноты финального задания и актуальности сведений о проекте.
В этом SEO-примере не было живого поиска, проверки выдачи и извлечения текстов конкурентов. Цепочка могла обработать предоставленный контекст, но сама не собирала свежие рыночные данные. Много усилий виделось для реализации собственного исполнителя. Предстояло развивать проверки, исправление результатов и интеграцию, а сервис требовал отдельного сопровождения. В следующей попытке перенес эту инфраструктуру на готовую платформу.
Второй подход, вынести workflow и подключить источники
В Dify процесс собирался из LLM-узлов, программных узлов и внешних инструментов. Tavily добавил поиск и извлечение страниц. Между темой будущей страницы и генерацией контента появился самостоятельный участок работы с источниками.
Сначала модель формировала исследовательские запросы. Затем поиск возвращал материалы, отдельный шаг выбирал источники, инструмент извлекал их содержимое, а следующая роль разбирала полученные тексты. Только после этого строились карта намерений пользователя и сущностей, спецификация страницы и SEO JSON.
В укрупнённой схеме workflow названия узлов сведены в смысловые блоки.
Исследовательские запросы
→ поиск Tavily → выбор источников → извлечение страниц
→ разбор источников → карта намерений → спецификация
→ SEO JSON → проверка → исправление → ревью
→ финальная обработка → проверка → выходной пакет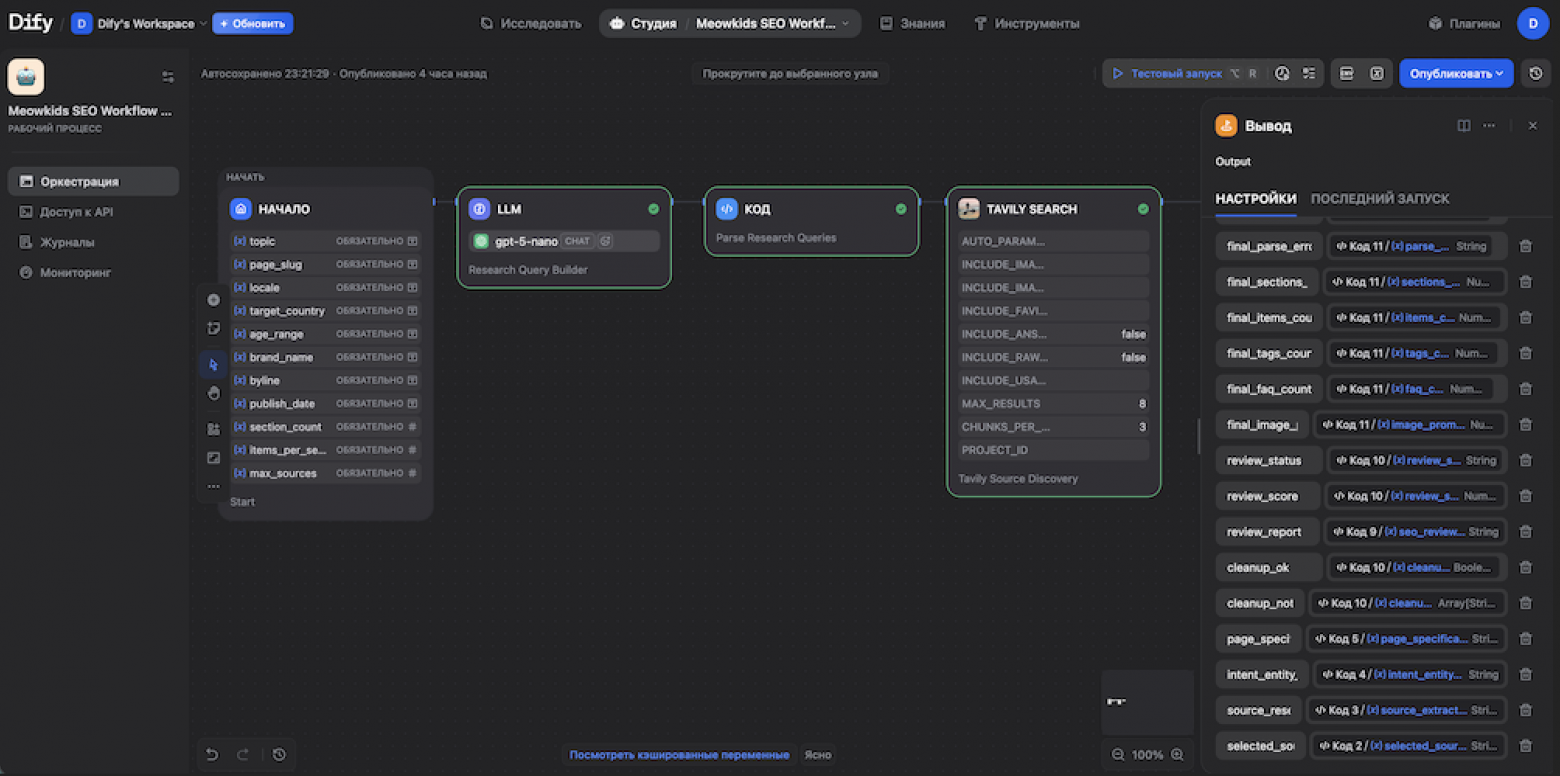
Результатом был пакет для дальнейшей работы. JSON для фронтенда, промпты для изображений, выбранные источники, спецификация, исследовательская сводка и отчёт проверки. Пакет позволял отдельно посмотреть, на чём основано содержание и соответствует ли оно требуемой структуре.
Готовая платформа сняла необходимость писать собственный движок исполнения. При этом настройка связей между узлами, входов и выходов осталась инженерной задачей. Например, финальная обработка должна была брать контент из узла исправленного JSON, а ревью использовать как отдельные метаданные аудита. Простое расположение узлов на схеме ещё не определяло правильный источник данных.
Часть операций удалось вывести из LLM-цепочки. Дополнительный узел финальной полировки убрал. Он увеличивал расход, добавлял недетерминированность, а в отладке возникали проблемы передачи его ответа дальше. Для MVP оставил программную обработку уже известного формата. Некоторые замены были привязаны к конкретной тестовой странице, переносить такой узел на новую тему без пересмотра правил было бы ошибкой.
Проверки тоже выполнялись кодом. Количество элементов сопоставлялось с заданием независимо от оценки текста моделью.
expected_total_items = expected_section_count * expected_items_per_section

if expected_total_items and item_count != expected_total_items:
    warnings.append(
        f"Expected {expected_total_items} total printable items, got {item_count}"
    )

validation_ok = parse_ok and len(warnings) == 0
В одном полном запуске вместо 32 элементов получилось 29, в локальном прогоне соответствующий шаг давал 32. Промпт оставался недоработанным, на его дальнейшую настройку тогда не хватило времени. В отчёте сохранилось расхождение между успешным завершением workflow и непройденной проверкой количества.
Внешние данные теперь собирались внутри процесса, а выходной пакет проходил программные проверки. Тема страницы по-прежнему задавалась заранее. Вопросы «почему именно эта тема», «нужна ли отдельная страница» и «какое обещание способен выполнить продукт» требовали другого уровня оркестрации.
Третий подход, организовать офис AI-сотрудников
В третьей версии появились постоянные роли с собственными областями ответственности. Исследователь рынка, сотрудник по поисковому спросу и разработчик получали разные задания. Было определено, кто собирает доказательства, кто принимает результат, кто разрешает следующую работу и в каких случаях нужен владелец проекта.
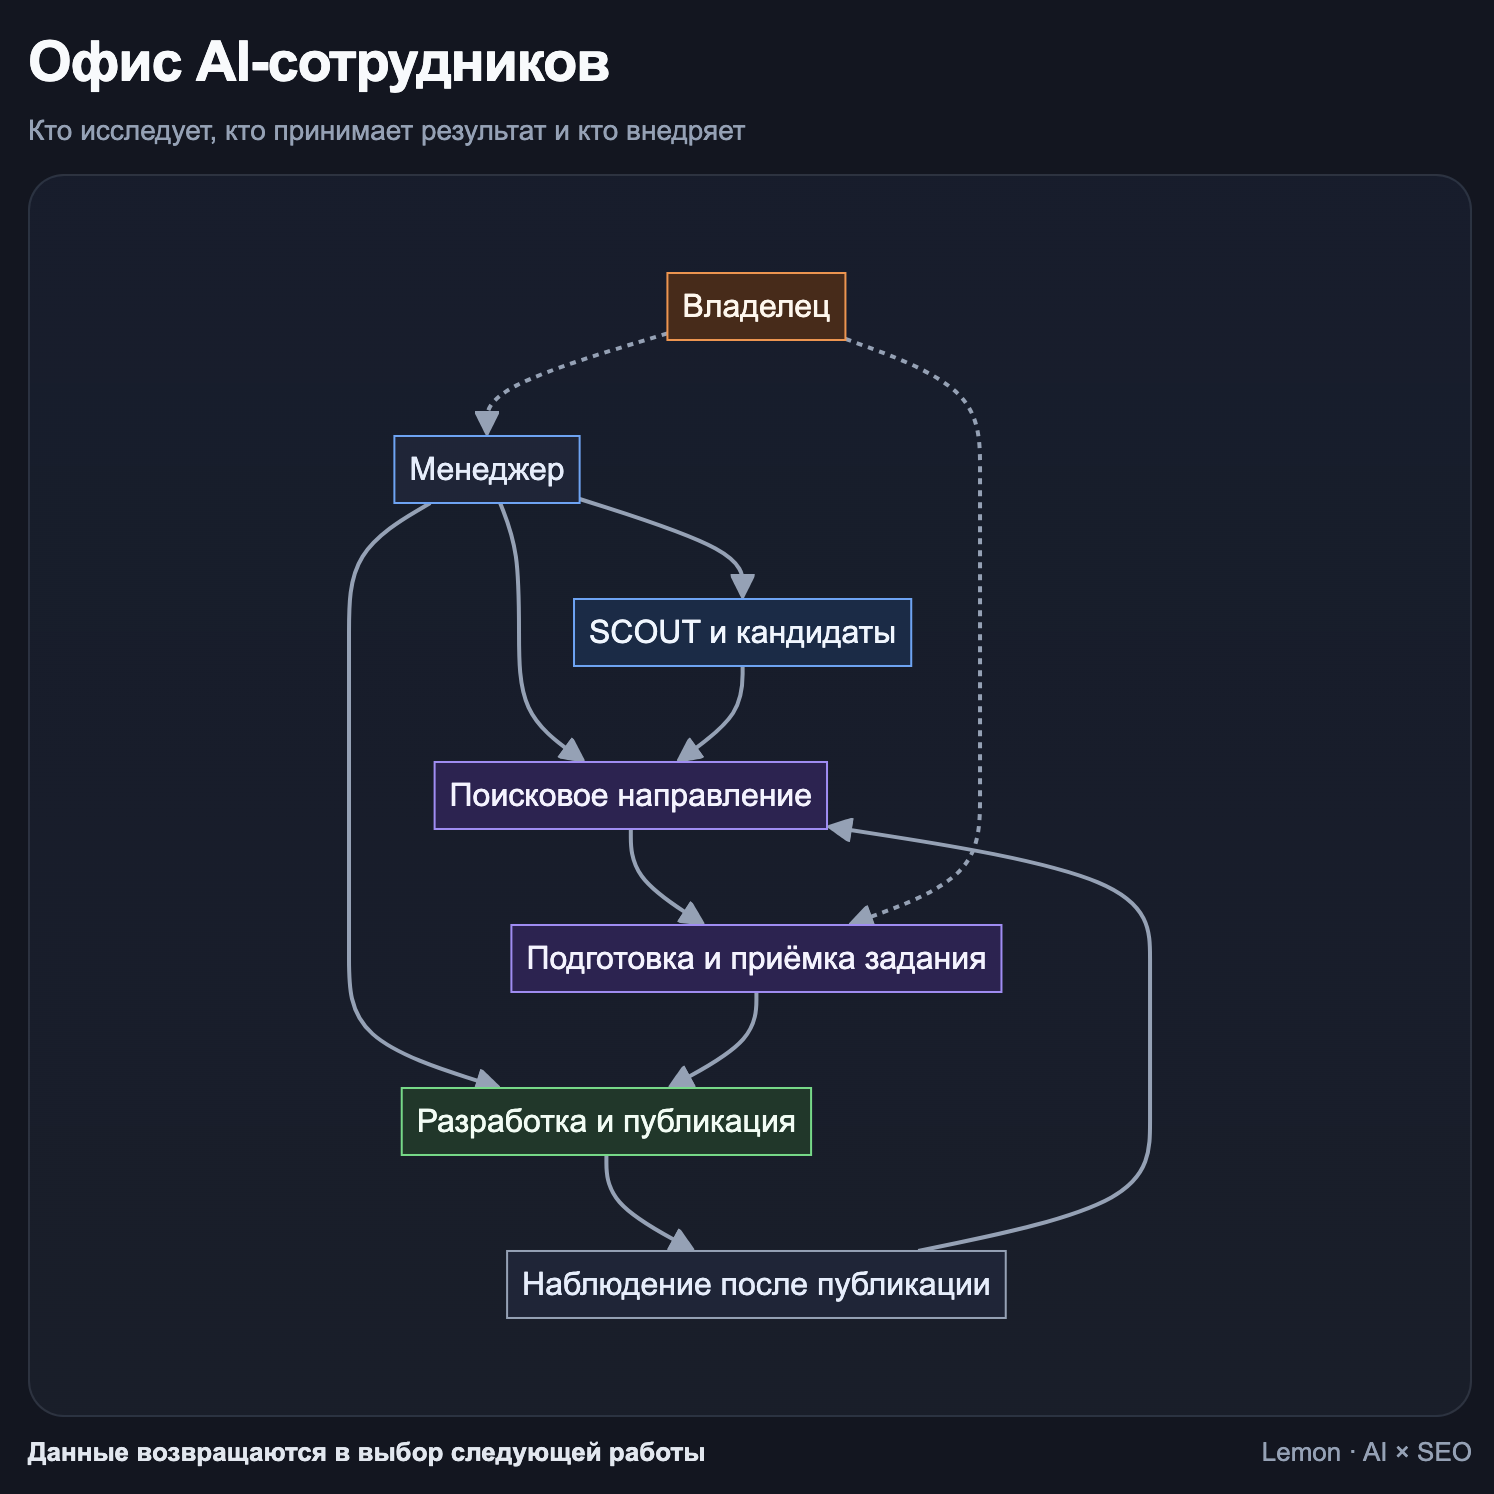
Эта модель сейчас проверяется на моём бесплатном проекте Logrun Lab (для просмотра возможно потребуется VPN). В нём собраны и рабочие инструменты и документация процесса, рост поискового трафика пока свежий и не подтверждён.
До страницы появился SCOUT
SCOUT исследует рынок и формирует кандидатов на продукты. В первых двух подходах работа начиналась с известного продукта и темы SEO-страницы. Здесь появилась возможность проверить и сам выбор продукта через пользовательские задачи и путь привлечения аудитории. Исследование начиналось с широкой карты конкретных операций. В материалах проекта зафиксированы 494 уникальные задачи в 23 категориях. Из них после нескольких проходов отбора и группировки получились 50 продуктовых кандидатов, 12 отправились в приоритетное глубокое исследование.
Операция описывалась через пользователя, ситуацию, вход и непосредственный результат. Например, пакетная подготовка фотографий товаров под размеры площадки с выгрузкой ZIP. Затем проверялись существующие решения, платные функции, жалобы пользователей и поисковые формулировки.
Личный прототип мог снизить стоимость разработки, но не заменял основания для выбора рынка. В контракте SCOUT это записано прямо:
No sunk-cost privilege

Existing code, components and prior prototypes may lower MVP cost later
They do not make a weak market strong
Результаты отбора получили человеческие описания в CANDIDATES, что за потребность, какие основания собраны, почему кандидат прошёл дальше или остался в резерве. TASKS объясняют последующие этапы работы. Эти документы позволяют мне как владельцу понять ход процесса без чтения всей переписки сотрудников.
От кандидата до работающей страницы
За поисковое направление отвечает отдельная роль. Она сопоставляет намерение пользователя с реальными возможностями продукта, изучает текущую выдачу и проверяет, не дублирует ли новая страница существующую. Английский и русский рынки рассматриваются отдельно, перевод текста сам по себе не подтверждает одинаковый спрос.
Перед написанием формируется набор источников и собственных проверок. Для утверждения о поведении инструмента нужны актуальный код и результаты его запуска. Страница получает границы обещаний, что показал тест, чего он не проверял и какие выводы из него делать нельзя. Один из кандидатов предполагал страницу об уменьшении шаблонности текста при сохранении смысла. До запуска были зафиксированы защищённые утверждения и условие остановки. В двух из трёх тестов часть смысла потерялась. Подготовку страницы остановили, сам инструмент оставили работающим, поскольку проверялось конкретное обещание страницы.
Такой результат не требовал нового запроса «проверь ещё раз и придумай выход». Правило следующего действия уже существовало. Другие принятые страницы проходили подготовку текста, проверку, внедрение и техническую проверку после публикации. Наблюдение тоже выделено в отдельную работу, поисковые показы и запросы, клики, доступные события продукта. Публикация, обход роботом и включение в индекс различаются. Отсутствующая выгрузка не записывается как нулевой спрос. Первые измерительные проходы остаются ручными или выполняются с помощью сотрудника под контролем.
Как удерживается контекст
Для передачи работы нужны постоянные документы и явные полномочия. Новый исполнитель получает задание, принятые результаты предыдущего этапа, актуальное состояние проекта и критерии приёмки. Решение не должно существовать только в истории одного чата.
В контракте поискового направления закреплены, например, такие правила:
Product truth выше SEO opportunity
Primary source > previous-agent assertion
FACT / OBSERVATION / INFERENCE / HYPOTHESIS разделяются
Review максимум один отдельный цикл
Automation только после устойчивого повторяемого ручного процесса
Человек подключается в местах, где есть решение владельца, недоступные данные, языковая или визуальная проверка. Перенос каждого ответа между сотрудниками не назначается его постоянной обязанностью.
В этой конфигурации я перестал фиксировать сбои сотрудников. Рабочие чаты проходили более 70 итераций и доходили до исчерпания доступных ресурсов самого чата. После этого роль переоткрывалась в новом чате с опорой на сохранённые материалы. Сравнительного теста моделей не проводил. Оно изменило отношение к привычной жалобе «модель потеряла фокус». Прежде чем менять модель, нужно проверить систему заданий, не противоречат ли инструкции друг другу, кто принимает промежуточный результат, какой документ актуален и что именно получает следующий исполнитель. Ошибка в этих связях переносится дальше даже при прекрасном выполнении каждого отдельного промпта.
Результат трех подходов
В Orchestrix были реализованы описание и исполнение цепочки, сохранение артефактов и подготовка задания для внедрения. Dify с Tavily добавили сбор внешних источников и программные проверки выходного пакета. В третьей версии появились исследование рынка до выбора продукта, распределение ответственности, приёмка работ и наблюдение после публикации.
Для SEO результат проверяется за пределами чата. Страницу должны находить подходящие пользователи, а продукт должен помогать им выполнять задачу. Пока данных недостаточно, чтобы утверждать, что итоговая модель обеспечивает продвижение в поиске.
В текущем процессе можно проследить происхождение кандидата, основание для выделения работы, подтверждённые утверждения и результат внедрения. Недостающие данные остаются зафиксированными в документации. На эти документы и решения опирается следующий сотрудник, получающий задание.
За три подхода изменилось распределение работы между разработчиком и ИИ. Сначала автоматизировалось исполнение заранее заданных шагов, затем сбор внешних данных, а в третьей версии AI сотрудники получили отдельные зоны ответственности от исследования до проверки внедрения. Человек определяет полномочия и подключается в ключевых точках. Так на задаче SEO сложился пример перестройки жизненного цикла разработки, меняются планирование, передача заданий, проверка результатов и работа после публикации.
Автор: lemon_m