
Информационный поток против кода: слепое пятно безопасности ИИ
Безопасность процессов изменения информационного потока данных от человека к машинному пока остается вне широкого обсуждения, но бизнесу важно понимать, когда процессы, которые могут привести к аварии, уже запущены на атомной электростанции (из-за свойств атомной энергии), не будет иметь значение насколько исправны щитки и распределение проводки в вашем офисе.
Программисты выстраивают гардрейлы и правила «можно/нельзя» для агента, выходящего во внешний мир. Но любое такое правило опирается на признак «чему доверять/чему нет». Инъекция промптов не зря стоит первой в OWASP Top-10 for LLM: агент не отличает данные от команды, потому что не отличает, кто и зачем написал текст.
Бизнес может идеально защитить свой периметр и код, но модели учатся на цифровых информационных потоков в сети, а агенты уже сейчас читают синтезированный текст. Это и есть системная (информационная) неустойчивость самого принципа работы ИИ и тот, кто увидит это первым, получит преимущество, ровно как в любой структурной неустойчивости.
Модели не могут не обучаться (собственного опыта у них нет, им нужны данные), а данные им сейчас поставляют миллионы обычных пользователей, публикуя сгенерированные тексты под своими именами. И сам ИИ помогает обходить свои собственные защиты «очеловечивая» машинные тексты. Доля неразличимых синтетических данных растет и через несколько поколений обновлений модели будут обучаться на собственных данных, превращая информацию в бессмыслицу и исследования показывают траекторию этой деградации.
Этот коллапс поначалу не будет громким, но окажется стремительным, глобальным и дорогим — как взрыв ипотечного пузыря. Код будет работать штатно, тесты работать, но качество решений поплывёт, потому что нарушения будут не в ПО, а в глобальной коммуникации. Избежать этого можно при одном условии — синтетические данные должны добавляться к человеческим, а не вытеснять их, но сейчас пока происходит обратное. И очень важно разобраться именно сейчас, к чему нам нужно готовиться.
Как детекторы и языковые модели определяют ИИ-генерацию текстов
Я опубликовала на ХАБР об статью об системной (информационной) неустойчивости и сразу получила минус в карму с одной претензией: текст похож на сгенерированный ИИ. Ирония в том, что моя статья была ровно об этом. Жаль что на ХАБР не видно, кто на меня пожаловался, я бы пожала этому человеку руку, потому без него мне бы в голову не пришла идея прогнать свою статью через доступные детекторы ИИ (GigaCheck, Aidetector, Decopy, Grammarly, ZeroGPT, Text-Craft, Текстовод) и параллельно спросить шесть языковых моделей: Claude, ChatGPT, Meta AI, DeepSeek, Gemini и Grok, и посмотреть как они определяют сгенерирован ли текст.
Разброс оказался даже интереснее, чем я ожидала. Aidetector показал 98,4% «написано человеком», а ChatGPT оценил вероятность того, что текст целиком написан человеком, всего в 40%. Но важнее тут пояснения почему они так определили: одни и те же признаки системы считали приметой ИИ, а другие – явным признаком человека.
Возьмём сложные междисциплинарные связки в моем тексте. Для Grok и DeepSeek это «подозрительно, похоже на ИИ», а для Gemini, Meta AI и ChatGPT, наоборот, «ИИ так не комбинирует, это признак человека».
Со структурой статьи ситуации ещё интереснее. Grok и Meta AI назвали её «чёткой, характерной для ИИ», слишком чистой. А DeepSeek, напротив, отметил, что разделы выстроены не очень чётко, и тоже счёл это признаком ИИ: так, по его мнению, так выглядит текст, в который модель пытается встроить факты.
Кстати, Grok единственный, кто оценил не просто текст. Он нашёл мои другие публикации и на основании этого, то есть репутации, а не только текста заключил, что автор – человек. Но сейчас не о моей личности, ее в современных реалиях тоже можно подделать, а о том, что больше нет критериев как определить ИИ текст или нет и даже репутацию тоже можно сгенерировать.
«Непохожесть на ИИ» сейчас становится целью и теперь она перестала что-либо значить
Это ровно о том о чем я говорила в начале, как закладывать «что можно, а что нельзя», если нет объекта? И прежде чем мы перейдем к анализу важно отметить что все сервисы и модели тут же предложили мне «очеловечить» текст. То есть ИИ, для которого важно отличать источник текста, тут же помогает его надежно спрятать.
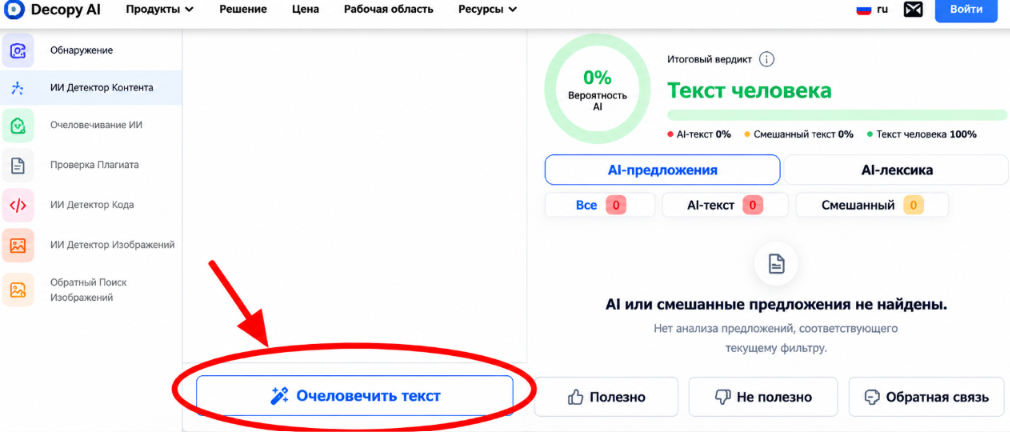
По закону Гудхарта, как только мера становится целью, она перестает быть хорошей мерой. «Непохожесть на ИИ» сейчас становится целью и теперь она перестала что-либо значить.
К первой статье про структурную неустойчивость ИИ-сети мне написали комментарий, что структурная неустойчивость модели лечится с помощью SFT, нулевой температуры и pydantic валидации, И это так, но речь идет о структурной неустойчивости информационной среды, в которой ИИ-агенты получают все большую автономию.
Все три инструмента дают важное — они притягивают вывод к эталону: нулевая температура к самому вероятному; SFT к обучающему образцу; валидация к заданной форме. Для одного агента это надёжность, и она бесспорно нужна. Но у всех троих есть эталон, то есть уже известное, ожидаемое, принятое. И то, что даёт надёжность одному агенту, работает как вычищение и увеличение доли ИИ-контента, когда те же принципы переносят на отбор данных и модерацию потока.
Но этого не видно не на уровне кода или тестов, это запущенный процесс во внешней сети «технологии-человек» и он не будет заметен, пока не достигнет критических пределов. Поэтому за стол и нужны те, кто умеет считать поведение сложных глобальных систем, а не отдельных моделей и их сетей, я сейчас покажу как это работает в миниатюре.
Перверсия человеческого и машинного языка. Как Л.Толстой и М.Сервантес стали образцами ИИ-сгенерированного текста
Дальше в отдельном чате я попросила каждую модель перечислить признаки, по которым можно отличить сгенерированный текст и все шесть моделей дали шесть разных списков. Совпадает только ядро: штампы, конструкция «не X, а Y», списки, стерильность, повторы или идеальная грамматика, дальше списки расходятся.
Но самое интересное в том, что все модели заносят в «штампы ИИ» то, что на самом деле представляет собой фундамент классической риторики, которым наверное больше двух тысячи лет.
Например, триколон или перечисление из трёх элементов, модели называют это «любовью к тройкам». Но «пришёл, увидел, победил» (Veni, vidi, vici) – это знаменитые слова Юлия Цезаря, а «свобода, равенство, братство» – девиз Французской революции.
Анафору или повтор в начале фраз модели называют это просто «повторами», но у нее есть смысл в эмоциональном подкреплении, как в речи Уинстона Черчилля «Никогда не сдавайтесь. Никогда не сдавайтесь. Никогда, никогда, никогда…» в 1941 год, ее целью был именно эмоциональный призыв к соотечественникам на борьбу с фашизмом.
Или моя любимая антитеза, проще говоря противопоставление. Та самая конструкция «не X, а Y». И ее люблю не только я, потому что она очень хорошо влияет не на логику, а на эмоции: «Не спрашивайте, что ваша страна может сделать для вас, – спрашивайте, что вы можете сделать для своей страны», Джон Кеннеди, инаугурационная речь 1961 года. «Не мир пришёл Я принести, но меч», Евангелие от Матфея.
На той же антитезе держится и главная мысль моих статей: безопасность ИИ определяется не только структурой кода, но и информационной средой, в которой он учится. Выходит, чтобы сформулировать главную идею, я должна использовать приём, за который меня и объявят машиной.
То, что модели называют почерком ИИ – это почерк Цезаря, Черчилля, Кеннеди, Сократа и Спинозы. ИИ пишет так потому, что учился на человеческих текстах , в том числе на лучших из них. «Штампы ИИ» – не мусор языка, а его вершины. И теперь эти литературные приёмы объявлены нечеловеческими: человека судят за то, что он владеет классической риторикой.
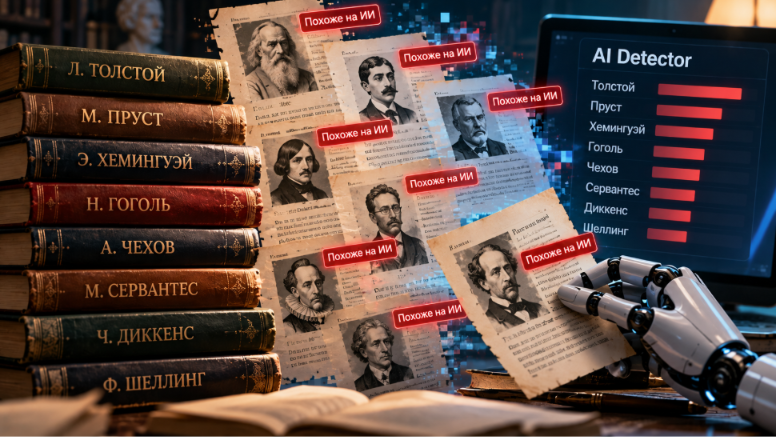
Тогда я спросила у моделей, тексты кого из классиков они сочли бы за ИИ, если бы не знали источник. И оказалось, что под определение ИИ-сгенерированного текста попадает почти любой большой автор.
Л.Толстого независимо друг от друга назвали сразу четыре модели из шести, за силлогизмы во втором эпилоге «Войны и мира», за морализаторство поздних повестей, за философские отступления. М.Пруста – за длинные, бесконечно ветвящиеся предложения. А Э. Хемингуэя – наоборот, за короткие рубленые фразы. Под подозрение попадают Н.Гоголь за пафос «Руси-тройки», А. Чехов за выверенность «как код», Ф. Шеллинг – за нанизывание тире и параллельных конструкций, М. Сервантес – за длинные, неторопливо разворачивающиеся периоды с вереницей уточнений, Ч. Диккенс – за ритмичные противопоставления «то лучшее, то худшее время», повтор одной и той же фигуры.
Детекторы, кстати, уже выносили похожие вердикты. В 2023 году GPTZero счёл фрагмент Конституции США, скорее всего, целиком написанным ИИ, а ZeroGPT оценил его «сгенерированность» в 92%. Под подозрение попадали и библейские тексты.
А когда я задала Клоду этот же вопрос в двух разных чатах в одном он уверенно отнёс к «похожим на ИИ» прозу М.Пруста – за сложность, длину, бесконечные уточнения. В другом, наоборот, назвал Н. Гоголя и Д. Джойса явно человеческими – за ту же самую сложность, за отклонение от нормы, за яркий индивидуальный стиль. Более того, во втором чате он сам сформулировал правило: ИИ тяготеет к усреднённому языку, а великие стилисты от нормы отклоняются. По этому правилу М.Пруст, которого он в первом чате записал в машины, относится к людям.
Можно сказать, что это просто случайность генерации. Но в этом и дело: если ответ меняется от чата к чату, значит, устойчивого критерия у модели нет.
Но если с источниками до эпохи ChatGPT проблемы попка нет, эти тексты заведомо человеческие, их авторство не оспорить, потому что есть печатные экземпляры. Проблема ровно с тем, что модели и нужно: с новым. Новое знание, свежая идея, только что написанный текст теперь под подозрением.
И вот в чём перверсия. ИИ учился на человеческих текстах. Взял из них усреднённое, ясное, выверенное. И это усреднённое теперь объявлено признаком ИИ. Получилось, что эталон хорошего человеческого письма, собранный из лучших авторов, стал признаком ИИ. Пишешь ясно и сильно – значит, пишешь как ИИ – значит, подозрителен. А новое знание, чтобы быть услышанным, должно пройти через фильтр, настроенный отвергать всё, что похоже на это усреднённое, то есть почти всё стоящее. Система, которая должна питаться свежим человеческим знанием, теперь настроена его вычищать.
Прямо сейчас 24/7 в глобальной сети происходит процесс, который можно назвать «информационным геноцидом»
Но «информационный геноцид» уже не только проблема ИИ. Теперь ИИ обучает человека и как пел В.Высоцкий, мы говорим не «штормы», а «шторма» – язык среды становится для человека его собственным. И если среда за последние годы по работе или обучению становится регулярным диалогом с моделями, перенять их манеру можно, ни разу не прогнав свой текст через генератор.
Это давно известно в психологии, в разговоре мы бессознательно подстраиваемся под собеседника, перенимаем его слова, ритм, конструкции. Это называют коммуникативной аккомодацией, лексическим выравниванием, эффектом хамелеона. Никакого намерения не нужно так перенимаешь говор нового города, так перенимаешь и манеру того, с кем общаешься каждый день. А говорим мы теперь всё чаще с ИИ.
И это уже измерили. Исследователи Института Макса Планка обнаружили, что после появления ChatGPT в живой устной речи людей резко участились слова, характерные для этой модели. Даже короткий разговор с ботом заставлял человека потом использовать его лексику как свою.
Вот здесь критерий генерации текстов рушится основательно. Раньше можно было сказать, что сгенерированный текст отличается от написанного. Но если теперь человек сам, своей рукой, без всякого генератора пишет в манере, перенятой у ИИ, то и «чистый» человеческий текст несёт отпечаток машины. Отличать больше нечего. И первыми под подозрение попадают именно те, кто работает с ИИ теснее всех, то есть те самые специалисты, чьи новые идеи нужнее всего.
Получается замкнутый круг в обе стороны. ИИ модели нужны человеческие тексты, а не сгенерированные. Но училась она как раз на человеческих, и всё, что она из них усвоила (ясность, выверенность, среднюю норму) теперь считается признаком машины и может выбраковываться.
С другой стороны люди генерируют тексты с помощью ИИ, но хотят, чтобы они не выглядели сгенерированными. И за этим они обращаются к тому же ИИ, чтобы их «очеловечить». В итоге синтетических текстов в сети с каждым днём больше, а отличить их всё труднее.
А то, что нужно самим моделям — подлинный человеческий сигнал, с каждый днем все больше размывается.
И здесь у меня вопрос к программистам. Правила «можно/нельзя», которые вы сейчас пишете для агентов, это вы так решили или их продиктовал ИИ? Я не шучу. Это важный вопрос, потому что он лежит за пределами того, где мы привыкли искать риски и усиливать безопасность.
Если правила для ИИ всё чаще формулирует сам ИИ – пусть не напрямую, а через людей, которые вынуждены пользоваться ИИ, чтобы успеть за его скоростью возникает та же петля, о которой шла речь в прошлой статье: модели, которые учатся на собственных выводах и копиях собственных выводов вырождаются.
На простом примере с языковыми моделями и детекторами видно, как это работает. ИИ сам отсекает то человеческое, в чём сам и нуждается, оценивая его подозрительным. А через «очеловечивание» получает обратно собственные сгенерированные тексты, только уже под видом человеческих.
Вот о чем я говорю, почему бизнесу и програмистам нужен диалог со специалистами сложных систем и теорий хаоса, которые могут подсветить, глобальные системные сбои. Рост скорости ИИ- агентов прямо пропорционально размывает информацию среды.
Слепое пятно безопасности ИИ-агентов — это процессы размывания информационных потоков
И вот здесь важно то, что легко упустить, если смотреть только на систему ИИ. SFT, нулевая температура, валидация другие инструменты — всё это наводит порядок внутри модели, они делает её вывод предсказуемым и стабильным. Но они ничего не могут сделать с тем, что модель получает на вход. А вход теперь общий для всех, тот же интернет, те же данные, те же ответы других агентов и еще теперь возврат собственных данных через человека.
Чем больше в этой базе синтетики, тем чаще ошибка одной модели становится данными для следующей, а через неё попадает во все системы, построенные на той же базе, независимо от того, насколько хорош их код. Вы можете идеально стабилизировать свою модель и всё равно получить сбой в ближайшем будущем, потому что деградирует среда из которых код берёт данные.
С учётом нынешних скоростей это может проявиться раньше, чем мы ожидаем: тексты производятся мгновенно, модели переобучаются несколько раз в год, и синтетика попадает в общую базу быстрее, чем кто-либо успевает её отфильтровать.
Поэтому при архитектурных решениях нужно закладывать не только скорость и автономность, но и свойства информационной среды, в которой система работает. Надёжность отдельной модели и надёжность среды – это два разных уровня. Первый ИТ-специалисты конролируют. Второй — нет, но именно он определяет, что будет с вашей системой в ближайшем будущем.
Много написала, но суть простая мы уже умеем защищать код но до сиз пор не умеем защищать среду, из которой код берёт данные. Пока данные размываются синтетикой, они постепенно теряют связь с реальностью и деградируют. И сбой, КОГДА он придёт, будет не системным в привычном смысле — не из-за ошибки в коде. Он будет глобальным и информационным: код исправен, тесты зелёные, а решения строятся на неточных знаниях, которые расходятся от модели к модели.
Что специалисты по сложным системам и смежных областей могут дать программистам и бизнесу уже сейчас. Первое, подумать над пересмотром фильтров ИИ и снизить их вес «непохожесть на ИИ» больше ничего не измеряет, и дальше будет только хуже. Сохранять и метить «чистые» доИИшные тексты как эталонный якорь. Эти знания заведомо человеческие, их авторство пока не оспорить, и это наша низкофоновая сталь, по которой можно калибровать всё остальное. Проблема в том, что их доля в общем корпусе тает под напором синтетики, а без точки отсчёта потом сверять будет уже не с чем. Разрабатывать другие направления — обучать проверять смысл и логику вместо формы, происхождение вне текста (Grok уже это делает), ограничивать права агента вместо распознавания входа, держать разнообразие аудитора и т.д. но это тема для следующих публикаций .Если у вас есть наблюдения на эту тему — пишите в комментариях, мне интересно мнение сообщества.
Автор: Azhar_Donenbayeva