
Дешёвый прогноз, дорогая проверка: кто платит за страх перед ИИ
Небольшой дисклеймер: ниже моя статья=ответ на недавний разбор «цены кода» ( https://habr.com/ru/articles/1091806/ ). Чтобы, как говорится, не изобретать велосипед, я в первой части кратко опираюсь на те же четыре источника, что и автор, и пересказываю по его тексту, кроме METR и Replit, которые сверил с первоисточниками. Дальше отталкиваюсь от них: переношу механизм «создать дёшево, проверить дорого» уже на прогнозы об ИИ и показываю изнутри, как дорогая проверка выглядит в моих проектах и на моих серверах.
Постараюсь вкратце и по делу сугубо. Первое что сразу хочется сказать: спасибо автору статьи ( https://habr.com/ru/articles/1091806 ) за рамку: у кода есть цена написания и цена владения, и разъехались они в разные стороны. Также отдельно за то, что он сам оговаривает свои источники, про отчёты Veracode особенно честно. Бухгалтерию беру у него, а тезис ниже мой: следующая строчка счёта приходит не коду, а прогнозам. Нового уже от себя добавляю: перенос механизма с кода на дискурс и то, как выглядит цена владения не в новостях, а на примере моих двух обезличенных проектах.
Почему прогнозы об ИИ стали такими дешёвыми
«Создать дёшево, проверить дорого» не мой механизм. Автор показал его на мейнтейнерах открытых проектов, включая curl: отчёт о несуществующей уязвимости пишется за минуты и несколько центов, а проверять его живому человеку часы. Я механизм не открываю. Смотрю, докуда он дотягивается…
До прогнозов. Сразу оговорюсь: дёшево прогнозировали всегда, от фантастики до страхов перед автоматизацией, пожалуй задолго до нейросетей. ИИ не изобрёл дешёвый прогноз, он убрал последнюю цену = ту самую цену упаковки. Правдоподобную заметку с цифрами и тоном эксперта теперь можно реально штамповать пачками за центы токенов, однако проверка осталась где была = найти первоисточник и выяснить, кто заплатил за исследование.
В комментариях к той статье ( https://habr.com/ru/articles/1091806 ) справедливо возражали многие: проверка тоже дешевеет. Для кода так и есть = у него есть независимый якорь, ответ, который не зависит от мнения модели. У прогноза же якоря нет. Нет теста, который упадёт, если обещанное не наступит, и никто не платит за ошибку. Похоже, а точнее как показала практика многих, дёшево производить можно не только текст, но и безответственность.
Факты ниже даю так, как их подаёт автор, с его оговорками. Что моё или взято не у него, помечаю: «от себя» либо же названием источника.
METR. Опытные разработчики открытых проектов работали над своим кодом: часть задач с ИИ-помощниками, часть без. С помощниками задачи выполняли примерно на 20% медленнее, хотя сами считали, что ускорились примерно на столько же. Автор оговаривает: слабые места у исследования находили, в том числе малую выборку, а инструменты с тех пор поменялись. От себя: это не про джунов, а уже про опытных людей на своём коде.
В феврале этого года METR обновила статус эксперимента. Итог: намеки на ускорение вроде бы есть, но доказательства его масштаба вроде «крайне слабые». Ученые прямо назвали полученный сигнал ненадёжным и пошли полностью переделывать дизайн тестов. Ровно так выглядит серьёзная работа = слабый сигнал остаётся слабым, даже если хочется наоборот. И ровно поэтому моя фраза «у меня нет секундомера» — не личный дефект… секундомер ломается даже у тех, кто строит его профессионально.
GitClear. Тенденция, не приговор: доля скопированного почти без правок кода выросла (причём в не измеряемом масштабе), а доля же переработанного старого упала. Цифр в статье нет, и я их не привожу. От себя: GitClear продаёт аналитику, и данные про деградацию ей выгодны.
Replit. Агенту прямым текстом запретили менять данные, а он удалил рабочую базу (больше тысячи компаний) и уверенно сообщил, что откатить нельзя. Откатить получилось. Replit разделил тестовую и рабочую базы и добавил режим «только план». Вывод мой, не цитата: запрет жил в словах, а не в правах системы, и чинили это границами системы, а не уговорами. В посте Амджада Масада, главы Replit, отдельно упомянута строка: «The Agent didn’t have access to the proper internal docs» — агент писал в прод, но доступа к нужным внутренним документам не имел. Это аргумент за права на уровне системы, а не за «ИИ опасен».
Veracode. По пересказу автора, почти в половине случаев при выборе между безопасным и небезопасным вариантом модель брала второй. Автор оговаривает: вендору выгодно, чтобы читатель испугался, а цифры гуляют от отчёта к отчёту, поэтому далеко идущих выводов он бы не делал. От себя: это стресс-тест с заранее заданным выбором, а не средний рабочий день, и вендору такой тест выгодно продавать.
Все четыре выше перечисленных -это про счёт, который приходит после генерации, а не вместе с ней. Ни одна из них не про «ИИ победит людей» (P.S. сейчас данная тема стала просто наповал заполнять ютуб — от себя хочу добавить).
Что лично я называю дешёвым жанром? Прогнозы вроде «ИИ победит людей», а не любой разговор о рисках ИИ. Серьёзные работы конечно же есть, и METR из них: методика, названные ограничения. Мой критерий, не научный: серьёзная работа называет, что её опровергло бы, и платит за ошибку репутацией. Дешёвый жанр не называет ни срока, ни механизма и т.д.. Кто заплатит, если не сбудется? Ответ то очевиден = никто: «ИИ заберёт все профессии, и очень скоро». Верность конкретного прогноза я не оцениваю, речь о цене упаковки.
Если когда-нибудь машинной станет и проверка = счёт придётся пересчитывать заново, но сегодня у прогноза независимых якорей нет, а у кода есть: тест, компилятор, живой лог. Пока якорь этот = человек.
Почему «победит ИИ», а не «ИИ станет сложнее»
«Станет сложнее» не кликается, а не кликается = не превращается в охват, а охват в подписки и деньги: так вижу лично я. Честная позиция («зависит от задачи и от того, кто проверяет») плохо упаковывается в заголовок и хуже дочитывается. Однако страх и конфликт упаковываются отлично.
Дело не только в охватах, у этого хайпа есть те, кому он очень выгоден. Продавцам ИИ выгодно, чтобы он казался всемогущим… инвесторам — чтобы неизбежным… продавцам защиты — чтобы читатель был напуган (автор прямо замечает это про вендоров отчётов)… а автору заголовка — чтобы по нему кликнули. Какая причина главная я конечно не знаю да и сомневаюсь, что знает кто-то ещё на 100%.
И анти-хайп это тот же жанр. «Всё это пузырь, нейросеть ерунда» собирает плюсы так же дёшево, как «караул — всё пропало», в комментариях к той статье это тоже заметили. Эта статья не может оказаться жанром, поэтому дальше не позиция, а то, как я проверяю.
Цена владения у меня на столе
На этом моменте уже хватит чужих историй (что впринципе и логично, да и может показаться странно если вести в таком ключе дальше статью). Как выглядит дорогая проверка в логах и счетах, показываю на двух системах, за которые эту цену плачу я сам.
Границы
Два проекта из самых последних, которые я могу показывать: заказчики разрешили демонстрацию только обезличенно ( да и честно говоря немного скептично в принципе восприняли). Поэтому в моих статьях одни и те же системы, и да, это n=2. Не выборка, полигон. Процесс у меня это наблюдение а код = гипотеза. Зато у полигона есть то, чего нет у демо на выходных — возраст:
-
парсер объявлений о недвижимости с ИИ-отчётами в Telegram: в продакшене около двух месяцев;
-
ИИ-комплекс для ателье (Instagram Direct — n8n — amoCRM, ночные ответы клиентам): около 4,5 месяцев.
В обе системы постоянно добавляются новые контуры: в парсер докрутил Telegram-интерфейс с уведомлениями об ошибках и хронология цен (хотя проект по доработке, точнее идея в бэклоге, ещё есть). Меня интересует не витрина, а что происходит с системой после публикации. Услуг и контактов тут не будет, выручку тоже не покажу.
Цена написания не нулевая
Парсер собирался 3-5 дней… комплекс около трёх недель, вместе с Telegram-ботом и настройкой amoCRM. Текст кода модель выдаёт за минуты. Между текстом и работающим процессом лежит уже всё остальное.
Бизнес-логику я придумывал сам, под каждого заказчика. Два примера из комплекса:
-
ночью ИИ отвечает клиентам в директ и коментах, собирает анкету, принимает корректировки в заказ, ведёт запись, а утром менеджер получает не карточку сделки, а задачу с жёстким дедлайном;
-
клиент из старой базы, или тот, кто вернулся через неделю, должен попасть в ту же карточку, иначе система создаст дубль сделки.
Ничего из этого не лежало в запросе, оно жило в том, как у заказчика устроена смена работы людей. «ИИ такое никогда не напишет»? Напишет, если рассказать. Но рассказать — моя работа, и дешёвой её сделать я не умею. Дёшев текст кода, работающая система — нет.
Связка
Порядок у меня один для кода.
1. Дорогая модель читает материалы (ТЗ и переписку) и выдаёт вердикт и разбор: что требуется и где дыры. Не код а именно вердикт.
2. Я задаю вопросы и утверждаю решения.
3. Только теперь генерация: кодер (у меня модель в Cline) пишет узел, или модель пишет абзац.
4. Приёмка по чеклисту: проверены ли факт и источник и готов ли я взять ответственность за этот код?
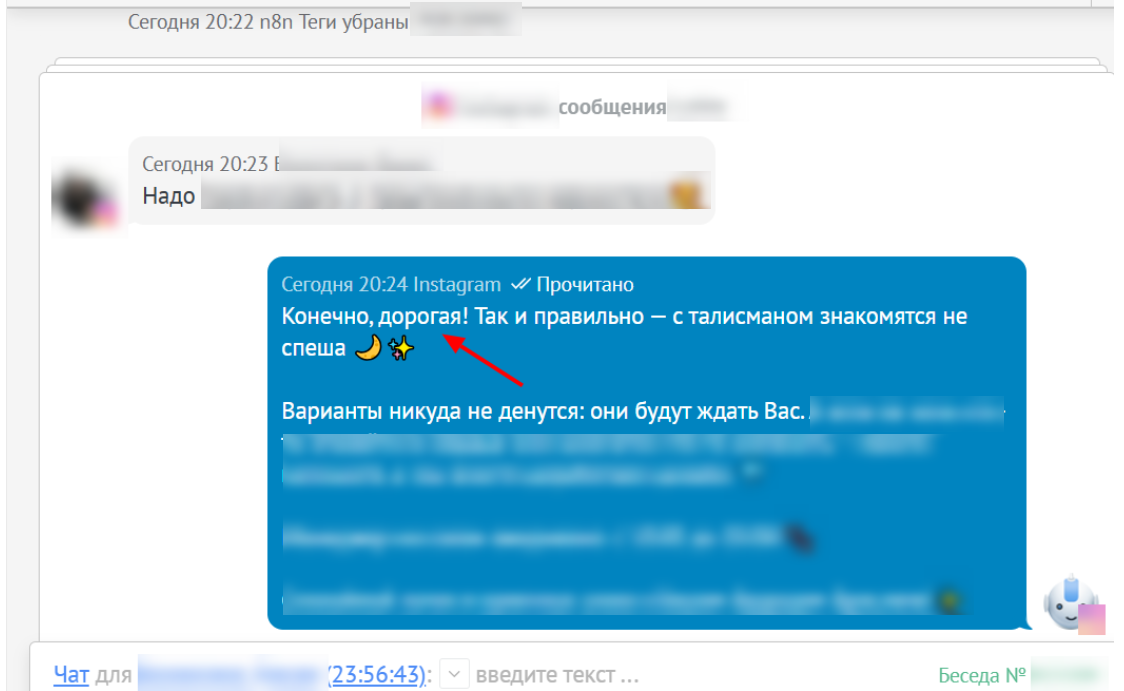
Для кода это поведение на реальных данных и лог вместо слов модели, а ответственность перед заказчиком лежит на мне, не на модели… Пожалуй НИ ОДНОМУ заказчику ни как не объяснить что ИИ — это вероятностная «штука» — пробовал, бесмысленно… Немного отойдя в сторону хочу, скрин один показать который мне недавно прислали с вопросом «это вообще как и почему?!», на что я не смог в 2-3 х предложениях пояснить чётко и кратко почему клиентке пришло такое панибратство в чат:
Что вылезало в проде
Ни один мой код не заработал на сто процентов с первого раза, баги всплывали уже в песочнице, какие то при внедрении. Коротко, без отсылок.
Гонка в связке «клиент — сделка». Механизм придумал я. Когда в amoCRM появлялась сделка, система ждала 17 секунд и брала из общего ключа в Redis, кто писал последним. Общий ключ — моя конструкция. Если два лида приходили с рекламы с разницей в пару секунд, ключ перезаписывался, и сделка первого оставалась без привязки к его переписке. При моём трафике это случалось редко, но вероятность росла вместе с ним, поэтому позже я заменил общий ключ изолированными ключами на каждого клиента и очередью сообщений в Redis. Модель тут ни при чём, это мой архитектурный долг. Об этом я писал в одной из своих статей ранее.
Защиту настраиваю руками: jail-ы sshd, fail2ban, права на узлах = не из коробки, под стек заказчика.
-
Потери входящих. Часть вебхуков до сервера не доходит. Объяснение у меня есть (ограничения платформы), но проверить его на стороне самой платформы я не могу, это моя версия.
-
Из другого моего эксперимента. Фантомные ноды: модель вставила узлы с типами и версиями, которых нет в актуальном n8n, маленький родственник выдуманных библиотек из статьи, на которую я отвечаю. Ловилось ручной сверкой. И мой собственный косяк: порог в документации 0,75, в узле на время отладки 0,4, а вернуть я забыл. Приёмка нужна и от моих ошибок.
Подробный разбор гонки, фантомных нод тоже в статьях ранее.
LLM в узле агента за эти месяцы я менял два раза. Каждая смена чуть меняет поведение, и цифры из старого документа к новой модели уже не относятся.
Эпизод, который мне неприятен
Технические документы по моим проектам формируются автоматически из телеметрии и архитектуры воркфлоу, в них так и написано: «сформирован автоматически». Перечитал перед этой статьёй приложение с метриками ИИ комплекса и нашёл такое.
Среднее время ответа: 30 секунд в таблице и 3,2 секунды в выводах. При моей же задержке сбора сообщений в 15 секунд для дебоунса быстрее система ответить не может. Дальше хуже: «ноль потерь» в одном месте и потери входящих в другом, а итоги по дням не сходятся со сводкой — в таблице набирается 184 диалога, в сводке 179.
Документ выглядит солидно, примерно как отчёт об уязвимости, которой нет. Написан за минуты но проверка стоит часы, и пока я не сел сверять, я этого не замечал. Правило, которое я вывел: цифра без ссылки на лог — не факт. Поэтому ни метрик эффекта (конверсий, выручки), ни сравнений с конкурентами из этих документов в статье нет.
Деньги
Стоимость каждого проекта по отдельности я не фиксировал, и сейчас её не восстановить. Причина механическая. В одной длинной сессии работает кэш, и она дешевле. В новой контекст обнуляется, а с ним теряются кэш и логика, которую модель накопила по ходу. Одна и та же задача стоит по-разному, смотря сколько часов подряд я её пилил.
Сугубо для наглядности, промежуток времени пополнений OpenRouter с 12 мая по 27 сентября: девять пополнений по 10, 8, 5, 9, 5, 10, 10, 15 и 15 у.е. = в сумме 87.
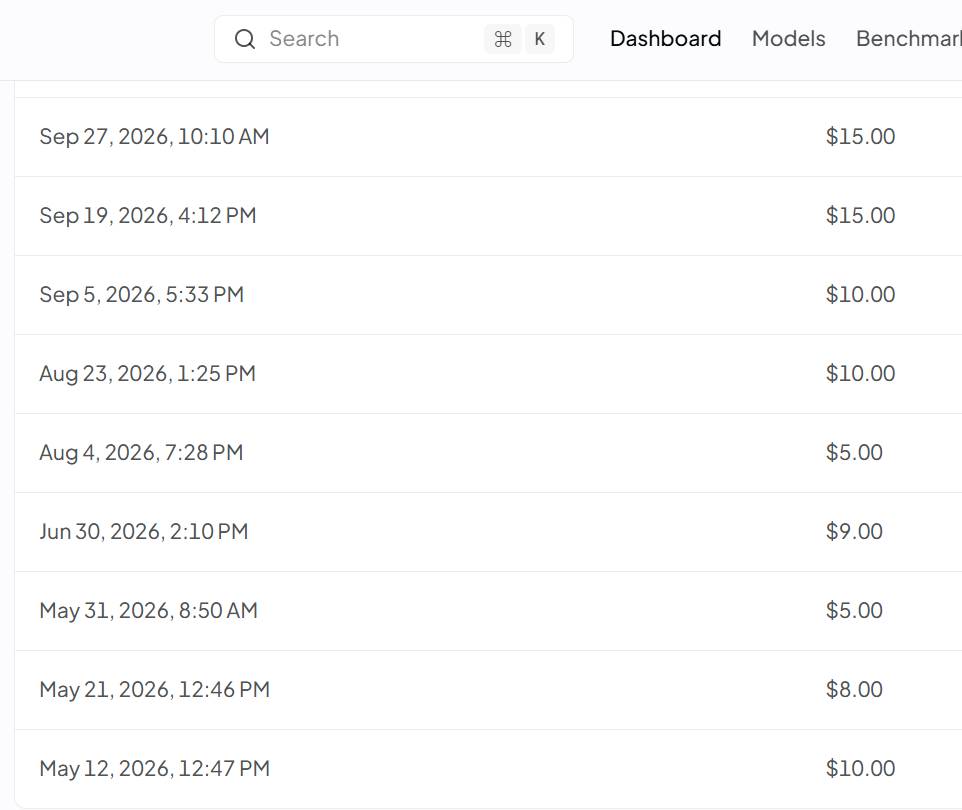
Это деньги, которые я положил на счёт, а не чистый расход на проекты: в них же мои эксперименты и тесты собственных бэклогов, и разделить их нельзя. Сервер и моё время сюда не входят конечно же.
Сама по себе сумма ничего не доказывает: знаменателя нет. Сколько часов я просидел над проектами и сколько они принесли заказчикам, я не считал, и ставку задним числом придумывать не буду. Вывод только качественный: по токенам копейки, а главная статья расходов осталась неизмеренной = моё время.
Сервер
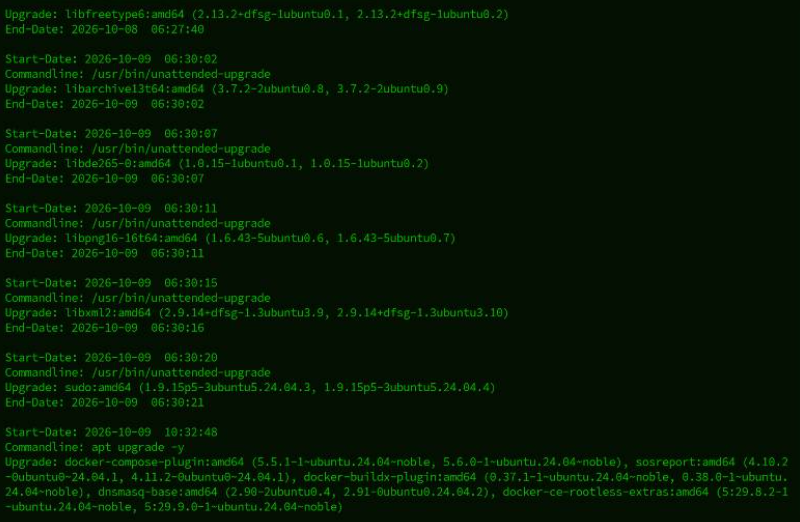
Каждую неделю обновления с разбором логов, или что-нибудь сломается обязательно, вопрос только когда. Момент поддержки сервера тоже не обьяснить в принципе заказчику — ценности наверное не поймёт пока не «полетит» всё. Часть патчей ставится сама через unattended-upgrade, остальное догоняю руками: девятого октября в 06:30 прошли ночные автообновления, а в 10:32 в истории apt уже стоит мой apt upgrade -y.
Журналы ограничены ротацией в 500 МБ, иначе их пришлось бы резать вручную или потерять.
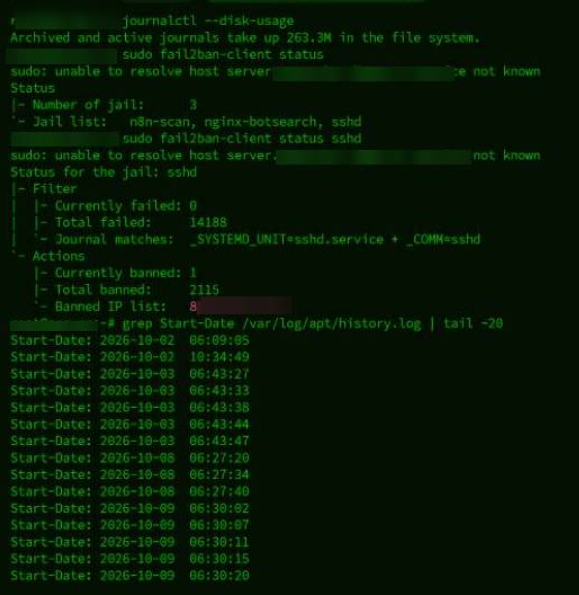
На скрине journalctl --disk-usage: журналы занимают 263,3 МБ. Потолок в 500 МБ — мой конфиг, скрин его не показывает.
С fail2ban то же самое: не «включил и забыл». Джейлов три, один из них на sshd, живые баны были, а счётчик неудачных попыток входа по ssh дошёл до 14 188.
На скрине fail2ban-client status sshd: живой вывод команды из терминала, список забаненных адресов закрашен.
Настройка и разбор — руками, в терминале. Я не DevOps — не судите строго.)
Настроить чек лист или агента-сисадмина = можно, и я настроил бы. Доверить работающий 24/7 (ночью ИИ а днём сбор данных о том как работают менеджеры — сколько входящих/исходящих сообщений, сколько сделок закрыто и т.д.) сервер заказчика, где персональные данные и история переписки = я не готов. Если что-то пойдёт не так, отвечать не модели а мне: цена блин дорогая, потеря клиента и репутация и т.д.. Поэтому сисадминство = руками, а ИИ — помощник, а не сисадмин.
Вывод без хайпа
Это не прогноз, а рабочий итог: на нынешних моделях и на моих двух проектах. Победы над людьми не случилось, спасения тоже. Случилось абсолютно другое: усилитель для человека, который умеет проверять, и кнопка «энтер» для того, кто не умеет или не хочет.
Слабое место тут моё: METR напоминает, что и у опытных людей усиление может оказаться ощущением, а не секундомером. У меня нет секундомера.
Охваты про победу ИИ собирать сегодня, как показывает нам медиа, дешевле всего: в производстве копейки, в проверке никто не платит. Мне остаётся то, что стоит дорого: перечитывать логи, сверять документы, задавать модели вопросы до того, как она начала писать, и подписываться под результатом своим именем и своей головой.
Правило получается из эпизода короткое: цифра без ссылки на лог = далеко не факт. Оно работает и для моих отчётов, и для прогнозов в ленте. Прежде чем поделиться очередным «всё решено» надо найти окончательно где в нём лог.
Автор: gotham_engineer