
Как помочь AI не терять контекст при длительной работе над проектом
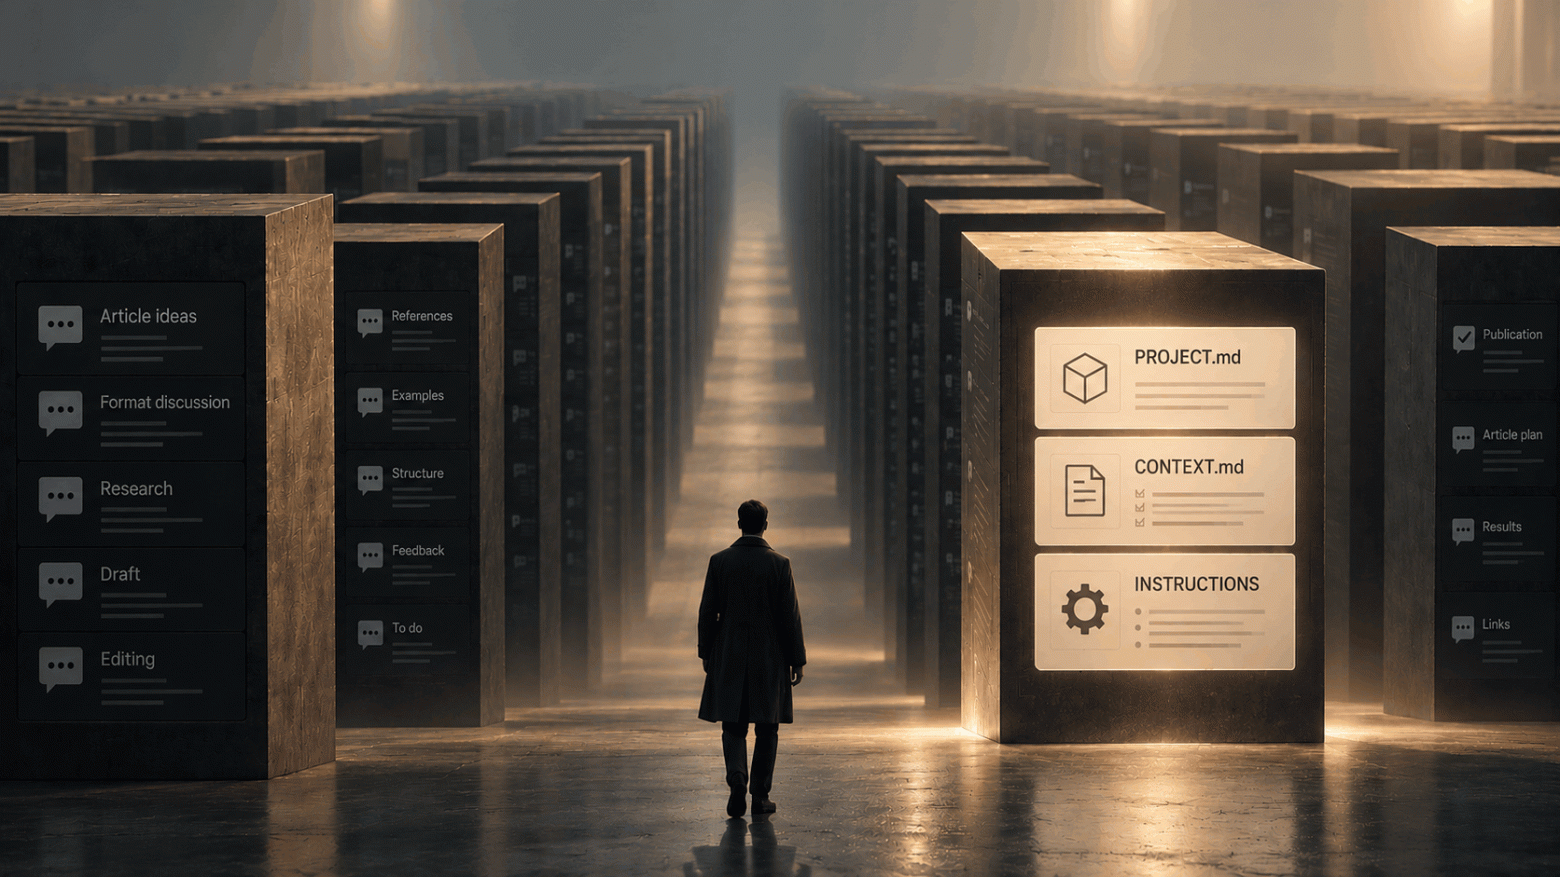
Представьте, что вы несколько месяцев ведёте например, технический блог с помощью ChatGPT, Claude или другой AI-платформы. Обсуждаете темы публикаций, составляете планы статей, исследуете источники, определяете стиль и редакционные требования.
За это время вы приняли десятки решений: отказались от некоторых тем, согласовали структуру серии материалов, опубликовали несколько статей. И в какой-то момент открываете новый чат и обнаруживаете, что AI предлагает уже опубликованную тему как новую. Или пишет текст в формате, от которого вы ранее решили отказаться.
Приходится снова объяснять правила и восстанавливать принятые решения. Пока обсуждений немного, это не вызывает серьёзных неудобств. Но по мере развития проекта поддерживать последовательность работы становится сложнее.
При длительной работе с AI контекст нужно проектировать и поддерживать так же осознанно, как сам проект.
Сейчас AI-платформы уже предлагают инструменты для такой работы: Projects, Instructions, Knowledge, Memory и Skills. Но наличие этих возможностей ещё не означает, что проектный контекст организован правильно.
В этой статье предлагаю разобрать, какую задачу решает каждый механизм, как настроить AI-проект и каким образом поддерживать его знания в актуальном состоянии.
Стоит сразу сказать, что такой подход применим не только к блогу, так же подходит для научного исследования, бизнес-стратегии, образовательного курса, планирования продукта и других долгосрочных задач.
О каких AI-проектах идёт речь
Дальше буду разбирать подход на примере ChatGPT Projects. Схожие принципы применимы и в других AI-чат-платформах, хотя конкретные инструменты и их возможности могут различаться.
ChatGPT Projects — это пространства, в которых можно объединять связанные обсуждения, задавать постоянные инструкции и предоставлять AI материалы, относящиеся к конкретной теме или продукту.
Похожие задачи возникают и при работе с AI coding agents, такими как Codex CLI, Claude Code или Cursor. Однако эти инструменты обычно имеют доступ непосредственно к файлам проекта и могут использовать инструкции и документацию из репозитория. В AI-чатах доступ к источникам организован иначе: через файлы проекта, подключённые документы, инструкции и механизмы памяти. Поэтому далее рассмотрим, как выстроить систему управления контекстом именно в такой среде.
Пример: ведём технический блог с помощью AI-чатов
Представим, что мы ведём технический блог для разработчиков. В ChatGPT создаём отдельный проект Технический блог и используем его для исследований и подготовки публикаций.
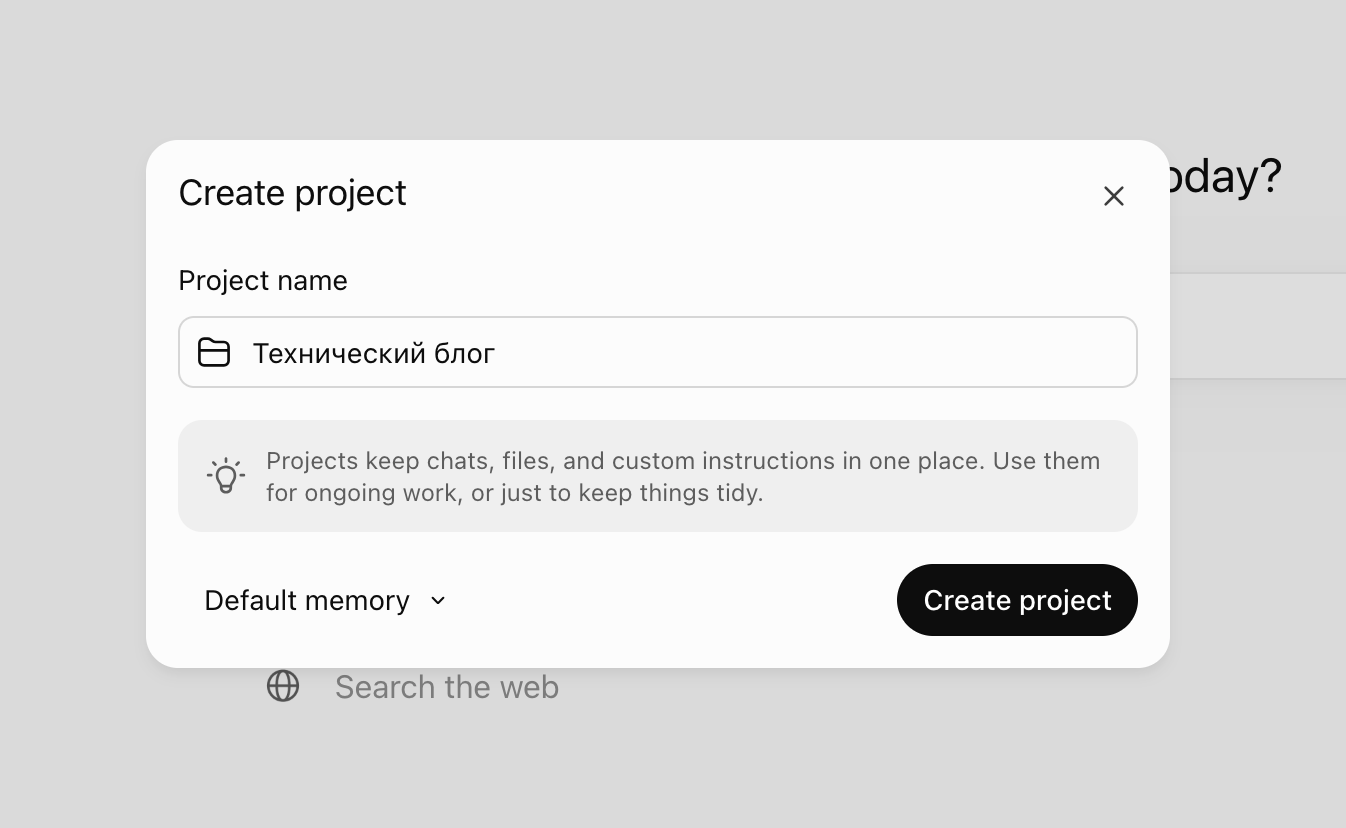
После нескольких обсуждений формулируем редакционные правила:
|
Область |
Решение |
|---|---|
|
Аудитория |
Разработчики и технические специалисты |
|
Темы |
AI-инструменты, web-разработка, инженерные практики |
|
Стиль |
Практический, без рекламных формулировок |
|
Структура |
Связный текст, минимум списков без необходимости |
|
Публикации |
Не повторять уже опубликованные темы без нового угла |
Постепенно внутри проекта появляются отдельные чаты. В одном исследуем тему контекстных окон, в другом редактируем статью про оптимизацию токенов, в третьем обсуждаем серию материалов об AI-инструментах. Отдельный диалог посвящён редакционному плану.
Таким образом, у нас есть несколько связанных обсуждений, общие редакционные требования и материалы на разных этапах подготовки. На этом примере дальше рассмотрим, как организовать проектный контекст.
Почему история чатов не заменяет проектный контекст
Может показаться, что достаточно создать отдельный проект в ChatGPT и платформа сама сохранит все необходимые сведения. Однако механизмы работы с историей имеют ограничения. Как правило, у языковых моделей есть ограниченный объём контекста, который они могут обрабатывать в рамках одного обращения. В него могут входить инструкции, текущие сообщения, доступная история, результаты инструментов и сведения из подключённых источников.
Когда обсуждения становятся длинными, платформа может использовать различные способы управления контекстом: сокращение истории, выбор релевантных фрагментов или обращение к механизмам памяти. Поэтому наличие решения в одном из старых чатов не гарантирует, что оно будет использовано при следующем ответе. Даже если информация доступна, модель не всегда интерпретирует её правильно.
Допустим, при обсуждении редакционной стратегии мы рассмотрели несколько форматов публикаций и в итоге выбрали практические руководства. В истории чата остались и первоначальные предложения, и окончательное решение. Если последнее не выделено явно, модель может опереться на промежуточный вариант — при условии, что соответствующие сообщения вообще доступны ей в текущем контексте.
Какие инструменты предлагают AI-платформы
В ChatGPT есть несколько механизмов, которые помогают организовать работу внутри проектов. Они различаются по названиям и возможностям, но их удобно разделить по назначению.
|
Механизм |
Основная задача |
|---|---|
|
Project Instructions |
Определяют постоянные правила работы AI |
|
Project Files / Sources |
Хранят информацию о проекте |
|
Memory / Chat History |
Помогают учитывать предыдущие обсуждения |
|
Skills |
Описывают повторяемые рабочие процедуры |
Рассмотрим их подробнее.
Project Instructions позволяют задать правила, которые AI должен учитывать при работе внутри проекта.
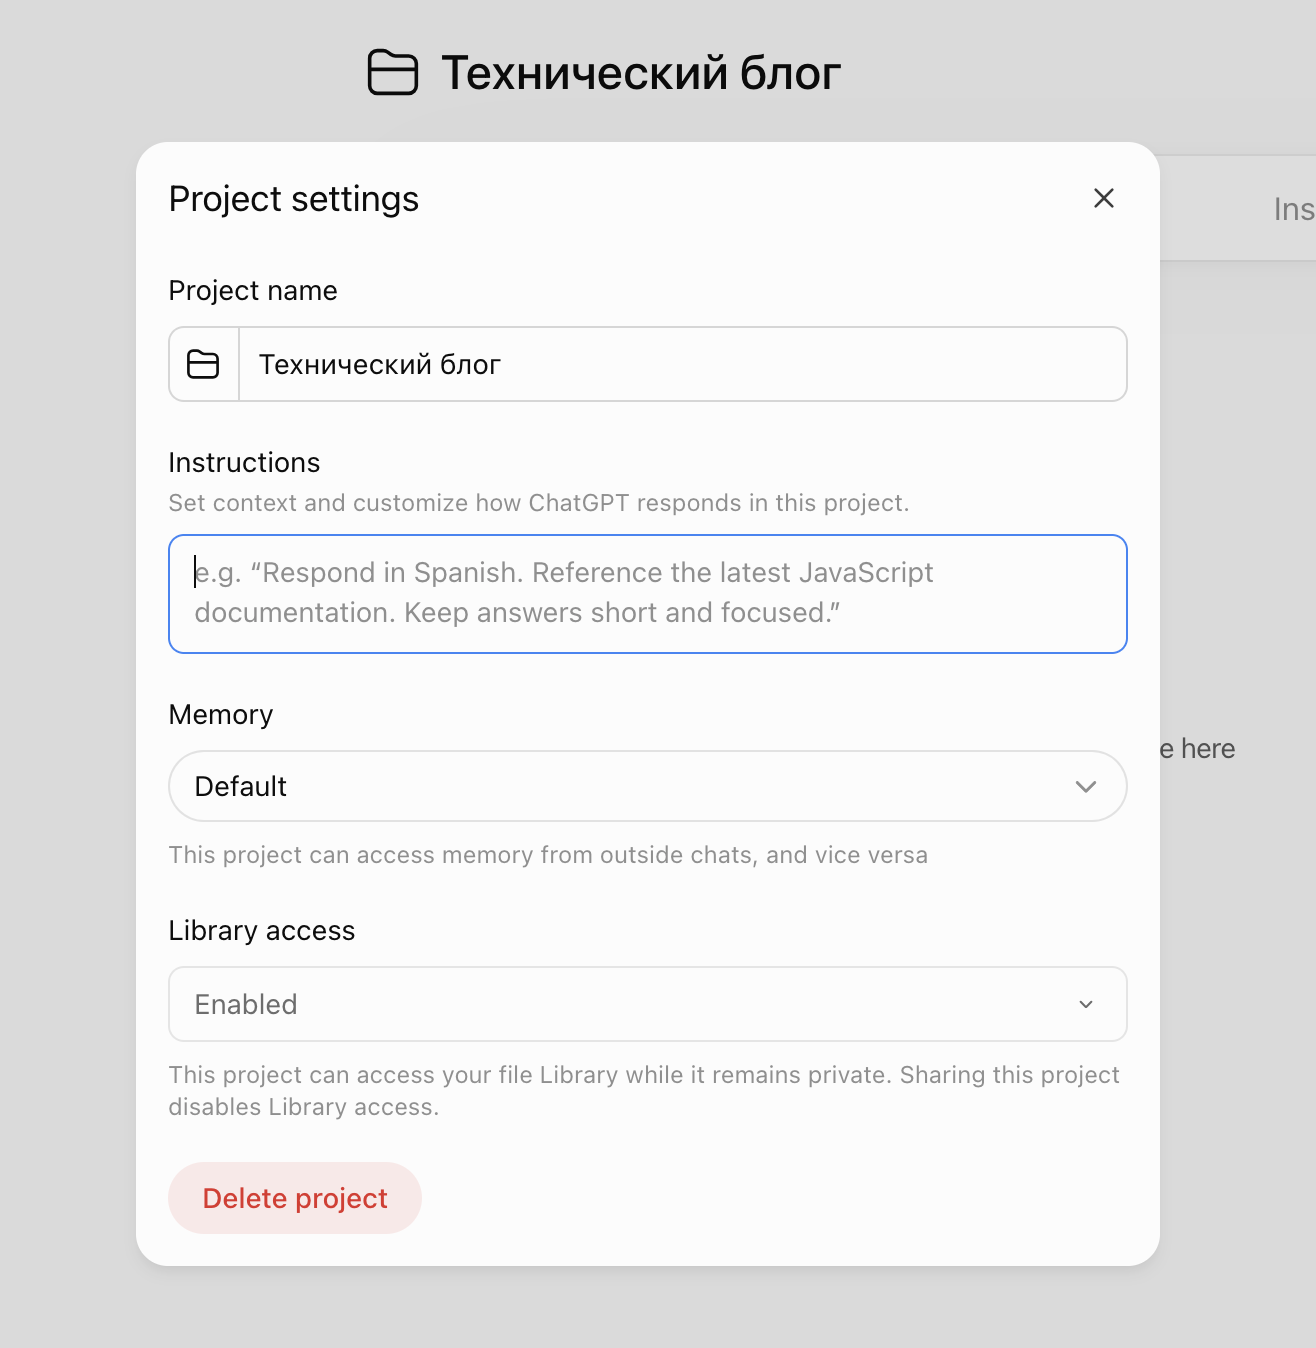
Например:
## General Rules

- Учитывай действующие редакционные правила.
- Не добавляй неподтверждённые факты и количественные оценки.
- Различай согласованные решения и предварительные предложения.
- Не считай обсуждённую тему опубликованной статьёй.
- Если информации недостаточно, сообщи об этом.
Это помогает избежать постоянного повторения одних и тех же требований. Но в Project Instructions не стоит переносить весь редакционный план, историю обсуждений и подробности каждой публикации.
Их задача — определить, как AI должен работать, а не хранить все знания о проекте. В ChatGPT Projects можно добавлять файлы и другие источники проекта.
Project Files / Sources — подходящее место для требований, редакционных правил, тематического плана, решений и текущего состояния публикаций.
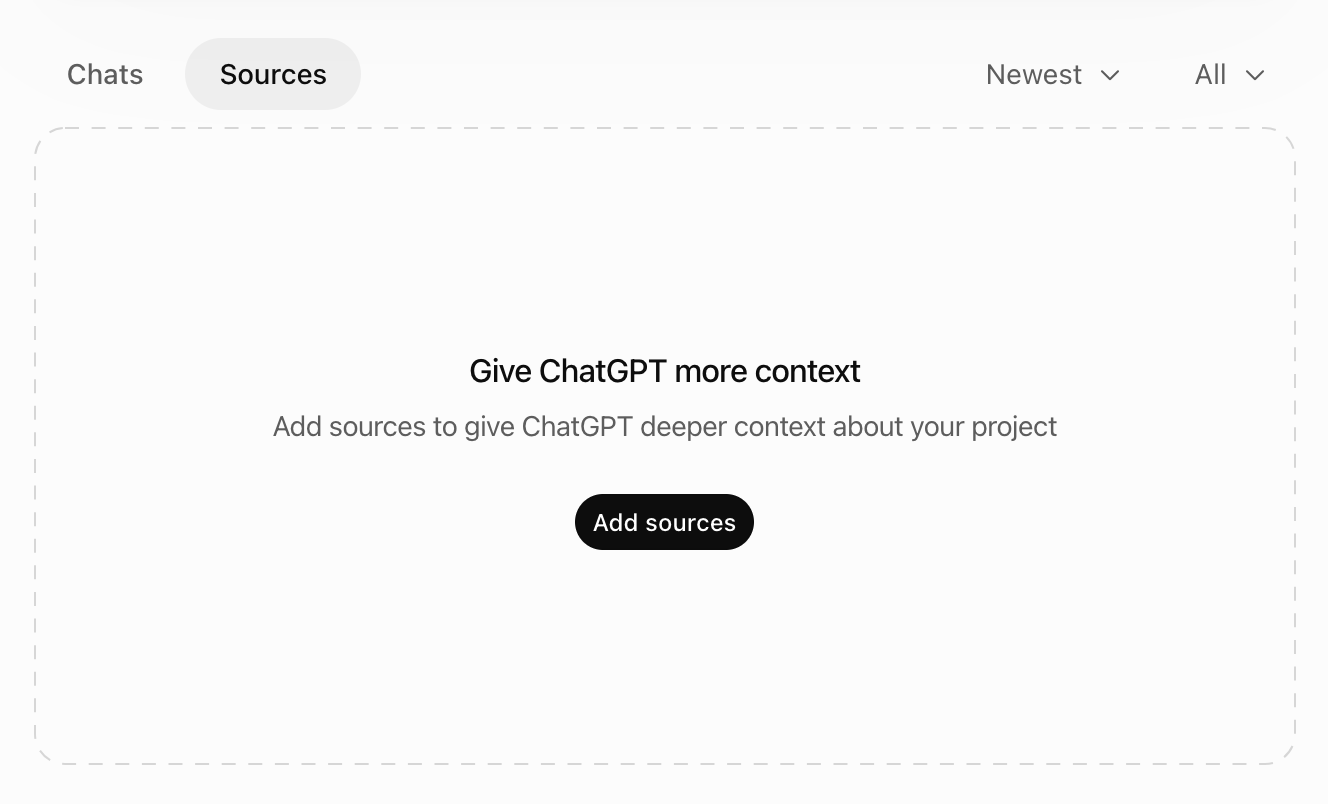
Например, можно подготовить три Markdown-документа:
Sources
├── PROJECT.md
├── CONTEXT.md
└── DECISIONS.md
Это документы, добавленные в источники AI-проекта. Они не требуют отдельного репозитория или специальной структуры каталогов.
PROJECT.md содержит цели блога, аудиторию, редакционные правила и ограничения.CONTEXT.md описывает актуальное состояние проекта.DECISIONS.md фиксирует существенные редакционные решения и причины их принятия.
Названия файлов условные. ChatGPT не требует именно такой структуры. Однако явное разделение информации помогает поддерживать документы и избегать противоречий.
Memory помогает AI учитывать сведения из прошлых взаимодействий.
В ChatGPT Projects при соответствующих настройках могут использоваться сведения из других чатов проекта. Memory помогает сохранять преемственность между обсуждениями, но не гарантирует извлечение каждого ранее принятого решения. Поэтому редакционные правила, утверждённые темы и статусы публикаций лучше фиксировать в проектных документах.
Skills позволяют стандартизировать специализированные рабочие процессы.
Для редакционного проекта это могут быть проверка фактов, редактирование черновика или подготовка анонса. Например, мы регулярно просим AI проверять структуру статьи, выявлять неподтверждённые утверждения и готовить анонсы публикаций.
Вместо того чтобы каждый раз описывать критерии проверки, можно вынести их в отдельную процедуру.
Условный пример:
# Article Review

При проверке черновика статьи:

1. Проверь соответствие теме и аудитории.
2. Найди неподтверждённые факты и цифры.
3. Проверь логичность структуры.
4. Укажи повторы и избыточные списки.
5. Сверь материал с редакционными правилами.
6. Не называй оценочные выводы подтверждёнными результатами исследований.
Если платформа поддерживает подключение Skills, такую процедуру можно оформить соответствующим способом. Если нативного механизма нет или он недоступен, процедуру можно хранить как документ и явно использовать при соответствующих задачах.
При этом обычный файл с инструкциями не становится тем, который автоматически вызывает Skill. Для нашей системы Skills полезны, но не обязательны. Начать можно с Instructions и проектной документации.
Настраиваем AI-проект на практике
Предположим, мы создали отдельный проект. Для начала достаточно постоянных инструкций и двух документов.
Шаг 1. Создаём PROJECT.md
Этот документ содержит относительно стабильные знания о проекте.
# Технический блог

## Overview

Практические статьи для разработчиков
об AI-инструментах и веб-разработке.

## Audience

Разработчики и технические специалисты.

## Editorial Rules

- Писать ясным техническим языком.
- Отдавать приоритет практическим примерам.
- Не перегружать статьи списками.
- Не приводить неподтверждённые цифры.
- Отделять факты от предположений.
- Проверять источники для меняющихся сведений.

## Constraints

- Не повторять опубликованные темы
  без нового исследовательского угла.
- Не считать план статьи готовым текстом.
- Согласовывать существенные изменения
  редакционного направления.
После добавления документа в источники проекта AI получает возможность использовать его при обсуждении новых решений. Например, при подготовке статьи он должен учитывать редакционные требования и запрет на неподтверждённые количественные оценки. Однако наличие документа в проекте само по себе не гарантирует, что его содержимое будет учтено в каждом ответе.
Поэтому важно дополнительно определить правила работы с источниками.
Шаг 2. Создаём CONTEXT.md
Второй документ содержит актуальное состояние редакционного плана.
# Current Editorial State

Updated: 2026-10-20

## Published

- Экономия токенов при работе с AI.

## In Progress

- Управление контекстом AI-проектов: черновик на редактуре.

## Planned

- Практическое руководство по Skills.

## Known Issues

- Для статьи о контексте нужны примеры использования.

## Next Steps

- Завершить редактуру статьи.
- Подготовить анонс публикации.
Теперь новый чат может получить информацию о том, какие материалы опубликованы, какие находятся в работе, а какие пока только запланированы.
Важный нюанс: поскольку чат не обязательно имеет доступ к площадке публикации, статус статьи должен подтверждаться пользователем или доступным источником. AI не должен самостоятельно объявлять статью опубликованной только на основании того, что ранее подготовил её черновик.
Шаг 3. Настраиваем Project Instructions
Теперь необходимо определить, как AI должен использовать документы.
# Project Instructions

## Context Sources

- PROJECT.md - цели блога, редакционные правила и ограничения.
- CONTEXT.md - актуальный редакционный план и статусы статей.

## Before Task

- Определи, какие источники относятся к запросу.
- Используй актуальные сведения из доступных документов.
- Не утверждай, что прочитал файл, если он не был получен.
- При противоречиях уточни, какое решение актуально.

## During Task

- Соблюдай подтверждённые редакционные правила.
- Отличай предложения от решений.
- Не считай подготовленный план готовой или опубликованной статьёй.
- Не придумывай публикации и источники.

## After Task

- Определи, появились ли новые подтверждённые решения.
- Если изменились редакционные правила или статус материалов,
  предложи обновление документов.
- Не записывай каждое сообщение.
- Не объявляй документы обновлёнными, пока изменения не сохранены.
Здесь есть принципиальный момент.
Мы не требуем, чтобы AI после каждого ответа переписывал проектную документацию. Вместо этого определяем условия, при которых её действительно нужно обновлять. Например, если мы просто обсуждаем несколько идей для будущей статьи, обновлять CONTEXT.md необязательно. Но если мы утвердили тему, завершили черновик или опубликовали материал, соответствующее изменение стоит зафиксировать.
Шаг 4. Проверяем настройку в новом чате
После создания документов и инструкций нужно убедиться, что AI действительно способен использовать проектный контекст.
Для этого откроем новый чат внутри проекта и зададим вопрос:
Какие редакционные правила нужно учитывать при подготовке следующей статьи?
Ожидаем, что AI упомянет аудиторию, практическую направленность и запрет на неподтверждённые цифры.
Затем спросим:
Какие статьи уже опубликованы, а какие находятся в работе?
Ответ должен соответствовать актуальному CONTEXT.md, а не предположениям модели.
Если информация не учитывается, необходимо проверить доступность источников и способ их использования в выбранной платформе. Такой тест не гарантирует правильного поведения во всех будущих запросах, но позволяет проверить базовую настройку.
Как поддерживать контекст в актуальном состоянии
Создать документы один раз недостаточно. Через несколько недель планы и статусы публикаций могут измениться. Если информация в источниках не обновляется, AI будет получать устаревшие сведения.
Поэтому нужен простой рабочий процесс:
Прочитать актуальный контекст → обсудить или выполнить задачу → подтвердить результат → обновить источники → проверить изменения.
Пример: опубликовали статью
Предположим, мы закончили редактуру статьи об управлении контекстом, опубликовали её и подтвердили ссылку на публикацию.
Ранее в CONTEXT.md было:
## In Progress

- Управление контекстом AI-проектов
  - Статус: черновик на редактуре.

## Next Steps

- Завершить редактуру статьи.
- Подготовить анонс публикации.
Теперь эти сведения устарели. После подтверждения результата документ нужно изменить:
## Published

- Управление контекстом AI-проектов
  - URL: ссылка на опубликованную статью
  - Статус: опубликовано

## In Progress

Нет статей на редактуре.

## Next Steps

- Подготовить анонс публикации.
- Выбрать тему следующей статьи.
Обратите внимание: мы не добавляем в конец файла очередную запись о завершении задачи.
Мы обновляем текущее состояние проекта. Это позволяет сохранять документ компактным. История обсуждений остаётся в чатах, а CONTEXT.md содержит актуальный снимок состояния.
На практике не стоит полностью полагаться на то, что AI сам определит момент для актуализации. Инструкция помогает сформировать ожидаемый порядок работы, но после значимых этапов полезно явно проверять состояние проектных документов. Например, после публикации статьи можно попросить AI сравнить текущий CONTEXT.md с подтверждёнными изменениями и подготовить обновлённую версию. Это занимает меньше усилий, чем восстанавливать состояние проекта спустя несколько месяцев.
Кто должен обновлять файлы проекта
В чат-платформах здесь возможны разные сценарии.
Первый — обновление вручную.
После принятия существенного решения AI подготавливает новую версию документа или конкретные изменения. Пользователь проверяет их и обновляет источник в проекте.
Это наиболее универсальный сценарий, не требующий дополнительных интеграций.
Второй — обновление через подключённые инструменты.
Если чат имеет доступ к редактируемому источнику, например к документам в подключённом сервисе, он может изменять их с помощью соответствующих инструментов и разрешений.
Но здесь важно учитывать, что обновление внешнего документа не всегда означает автоматическое обновление его копии, ранее загруженной в AI-проект. Поэтому после изменения необходимо проверить, что следующий чат использует именно актуальную версию.
Само наличие правила в Project Instructions не гарантирует автоматическую синхронизацию.
Как избежать превращения контекста в свалку информации
Со временем появляется соблазн сохранять в проектные файлы практически всё. Каждое обсуждение, каждый вариант решения, все промежуточные выводы и планы. Но это приводит к той же проблеме, которую мы пытаемся решить: значимые сведения теряются среди большого количества второстепенной информации.
Поэтому стоит разделять историю обсуждений и актуальное состояние.
В PROJECT.md должны оставаться действующие редакционные правила и ограничения.
В CONTEXT.md — подтверждённая информация о текущем состоянии проекта.
Если решение пересмотрено, устаревшую информацию необходимо заменить или явно пометить как неактуальную.
Для существенных редакционных решений можно добавить отдельный DECISIONS.md, где фиксируются причины выбора и история пересмотра решений. Не нужно создавать такой файл заранее, если проект достаточно прост и вся информация помещается в PROJECT.md.
Этот подход соответствует принципу минимально достаточного контекста: сохранять то, что действительно понадобится в будущих обсуждениях.
Какие ограничения остаются
Даже правильно настроенный AI-проект не гарантирует, что модель никогда не забудет решение или не предложит вариант, противоречащий редакционным правилам.
-
Project Instructions могут применяться непоследовательно.
-
Источники проекта не обязательно используются целиком в каждом запросе.
-
Memory может не восстановить нужную информацию.
-
Skills могут не активироваться или выполняться не полностью.
-
Проектная документация сама может содержать устаревшие сведения.
Поэтому управление контекстом не отменяет необходимость проверять ответы AI. Оно создаёт более понятную и контролируемую основу для работы, но не заменяет редакторскую проверку результатов.
Вывод
Управление контекстом долгосрочного AI-проекта — это не только первоначальная настройка Instructions, Memory и источников знаний. Не менее важно поддерживать принятые решения и текущее состояние проекта в актуальном виде.
Для начала достаточно постоянных инструкций, одного-двух документов и простого правила: после существенных изменений проверять, нужно ли обновить проектный контекст.
При длительной работе с AI контекст нужно проектировать и поддерживать так же осознанно, как сам проект.
Такой подход не гарантирует безошибочных ответов, но делает продолжение работы в новых чатах менее зависимым от восстановления старой переписки.
Полезные материалы
Документация чат-платформ
Инженерные материалы OpenAI
-
Iterating Development Workflows with Codex — принципы организации длительных рабочих процессов и сохранения значимых решений.
-
Rethinking skills and prompts for GPT-6 Astra — о точности инструкций, избыточном контексте и организации Skills.
Последние два материала относятся в основном к агентным сценариям, но описанные в них принципы организации контекста полезны и для AI-чатов.
Автор: Sergo_34