
Передать данные ИИ и не унести их во внешний интернет: опыт ЕДИНОГО ЦУПИСа во внедрении Shtab AI
За годы работы с данными компании научились хранить и использовать их так, чтобы не выпускать наружу. По крайней мере, некоторые. Но ИИ подкинул новые вызовы. С одной стороны, без него уже никуда, с другой — если передавать внешней модели данные без защиты, это может обернуться катастрофой. Так что внедрять ИИ в бизнес нужно с умом. А как — расскажем на примере успешного кейса финансовой компании. Передаем слово спикеру.
Всем добрый день! Меня зовут Борис Кузнецов, я руководитель Управления стратегических проектов в ЕДИНОМ ЦУПИС. Мы уже больше года используем таск-трекер Shtab в закрытом контуре, а недавно внедрили Shtab AI, чтобы оптимизировать работу с задачами и информацией.
Хотим поделиться опытом использования инструмента: как пришли к его необходимости, как внедряли и что учли, чтобы чувствительные данные компании не выходили наружу.
Дано: финтех-компания со строгими требованиями к безопасности
ЦУПИС расшифровывается как центр учета переводов интерактивных ставок. Мы развиваем платежные и цифровые сервисы в регулируемой индустрии спортивных развлечений. Все букмекерские компании России обязаны осуществлять платежные операции через нас — и принимать ставки, и выплачивать выигрыши.
По закону мы также обязаны удерживать целевые отчисления на развитие спорта в Российской Федерации. Размер отчислений регулируется законодательством, все средства направляются в ЕРАИ — Единый регулятор азартных игр. Кроме того, ЕДИНЫЙ ЦУПИС развивает сервис самоконтроля «Ответственная игра», который помогает людям не потратить на ставки слишком много:
-
игрок может отправить нам заявление, если хочет установить лимит на свои траты на ставки или вообще запретить себе играть,
-
мы принимаем заявление и впредь не пропускаем платежи этого игрока сверх лимита.
ЕДИНЫЙ ЦУПИС зарегистрирован как небанковская кредитная организация с лицензией Банка России. По сути, мы являемся финтех-сервисом со всеми вытекающими: высокими требованиями к безопасности и большим количеством конфиденциальных данных.
Обычно финансовые сервисы с большой осторожностью относятся к ИИ. Это касается и нас. Искусственный интеллект полезен, но мы не можем применять его бездумно: важные данные не должны покидать наш закрытый контур. А практически всё ПО и сервисы, которые мы используем, развернуты внутри контура на наших собственных мощностях.
Что было «до»: ИИ-инструмент от стороннего вендора
Раньше у нас в компании работал ИИ-сервис от стороннего вендора. Внутри компании мы называли его копайлотом — для простоты буду использовать это название и здесь. Сервисом пользовалось более сотни сотрудников ЕДИНОГО ЦУПИС.
Копайлот предоставлял сотрудникам доступ к разным языковым моделям, как отечественным, так и зарубежным. Сотрудники могли работать в едином пространстве, чтобы решать различные рядовые задачи (создавать презентации, корректировать письма, править тексты и пр.), для которых компании обычно используют ИИ.
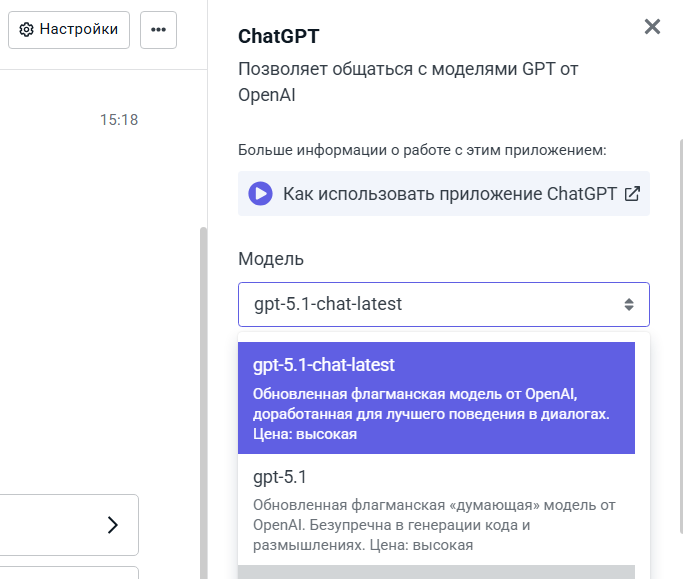
В частности, нам были важны две вещи, которые присутствовали в сервисе:
-
Кроме модели, сотрудник мог выбрать готовое приложение под ту или иную задачу. Условный юрист работал с законодательной базой с помощью готовых препромптов, которые под капотом обращались к нужной языковой модели.
-
В наш контур был установлен модуль обфускации данных, то есть автоматического обезличивания. Для нас это был важнейший пункт. ЕДИНЫЙ ЦУПИС работает с множеством чувствительной информации, которую запрещено отправлять во внешние модели. Обфускация данных служила подстраховкой, чтобы важная информация не утекла за пределы контура.
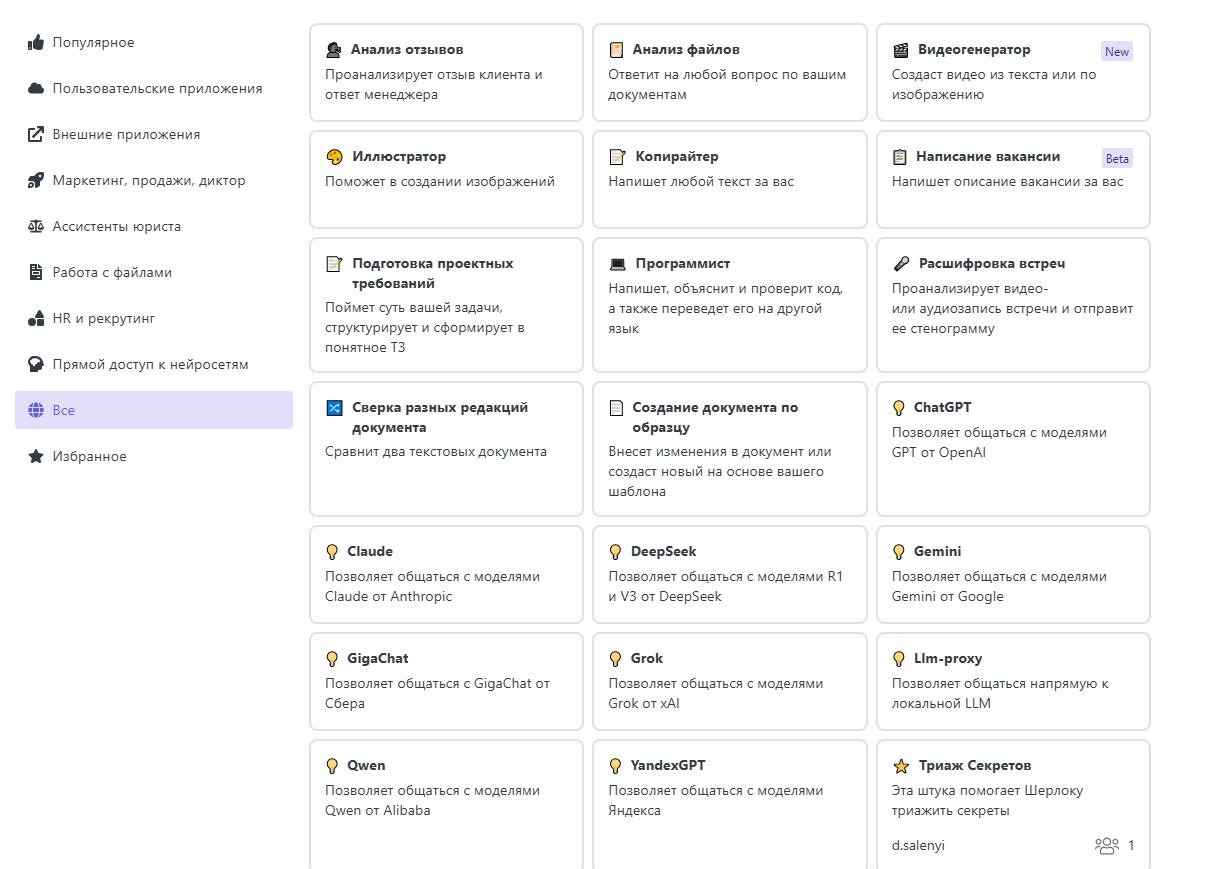
О необходимости ИИ в целом мы не спорили. Она была очевидна для нас с появления первых коммерческих моделей. Нам хотелось, чтобы сотрудники ЕДИНОГО ЦУПИС имели доступ к ИИ-инструментам без VPN, прямо с рабочих машин. До определенного момента наш копайлот отвечал этому требованию. А потом появился инструмент от Shtab.
Пришли к необходимости использовать единый контур с ИИ
В конце 2025 года команда Shtab пришла к нам с информацией, что планирует запускать свой ИИ-сервис. На тот момент мы уже больше года использовали таск-трекер Shtab, и за это время между нами и командой системы сложились вполне дружественные отношения.
Ребята спросили, интересно ли нам их ИИ-решение. Нам идея понравилась: прошлый копайлот в целом устраивал, но инструмент от Shtab лучше ложился на наши потребности. Причин на то было несколько:
-
ИИ-сервис предполагалось встроить в сам таск-трекер. Получалось единое пространство, в котором сотрудник может спокойно выполнять задачи и не переключаться между Shtab и копайлотом.
-
Shtab предлагал быструю доставку новых версий моделей. У прошлого копайлота был минус: обновлений приходилось ждать месяцами. Порой за время ожидания успевали выйти новые версии. У Shtab подход другой: они самостоятельно добавляют модели на своей стороне, а у нас есть отдельный модуль управления. В нём мы можем сразу же выбрать доступные модели и добавить там, где нам это нужно.
-
Shtab также предлагал возможность выдавать доступ к моделям конкретным сотрудникам. Условно, есть дорогая модель, один запрос к которой может потратить месячный запас токенов. И есть ключевой сотрудник, которому реально нужен доступ к этой модели. Мы можем выдать доступ только этому сотруднику и закрыть для всех остальных, чтобы не расходовали инференс вхолостую.
-
Были предусмотрены обфускация и возможность работать в закрытом контуре. Решение без этих возможностей мы бы даже не рассматривали. Но получилось даже лучше, чем было с прошлым копайлотом.
Мы в ЕДИНОМ ЦУПИС используем Shtab в формате on-premise — из-за строгих требований к безопасности изначально не рассматривали облачное решение. Соответственно, нам бы пригодились локальные инструменты без выхода во внешний интернет. А Shtab как раз планировали реализовать внутреннего ИИ-агента для работы с задачами внутри самого таск-трекера. Что из этого вышло, расскажу дальше в статье.
Выступили как первопроходцы для нового инструмента
Нам рассказали о модуле в конце 2025 года, но тогда функциональность, которую мы обсуждали, оставалась на уровне идеи. Мы сказали: если всё будет настолько круто, как вы описываете, с радостью поучаствуем. И продолжили жить как жили, пока в мае 2026 года Shtab не довел свое ИИ-решение до выхода на рынок.
Shtab AI оказался ровно таким, как мы рассчитывали. Кроме доступа к зарубежным моделям, он также предлагал свой harness. Платформа могла генерировать изображения и видео, расшифровывать аудио и работать с файлами: преобразовывала их в формат, читаемый LLM, выполняла OCR изображений и схем внутри документов.
Механизмы Shtab AI могли работать в том числе на базе любой локальной модели и оказались совместимы с любыми локальными провайдерами: vLLM, Ollama, llama.cpp и другими. Была возможность и подключить собственные локальные модели, в том числе для генераций или для распознавания текста и речи.
Дальше начали подписывать договоры. Для внедрения ИИ-инструмента нам понадобилось заключить отдельный контракт, после чего обсудили действия с каждой из сторон:
-
Наша команда подготавливает инфраструктуру для развертывания локальной LLM, согласовывает требования по безопасности, разграничивает доступы и прописывает требования к обфускации.
-
Команда Shtab помогает с деплоем, донастраивает и дорабатывает то, чего нам не хватает, по нашей обратной связи.
С нашей стороны работали DevOps, AI-команда и еще несколько отделов. ДИТ (департамент информационных технологий) отвечал за ролевую политику и разграничение доступов. СИБ (служба информационной безопасности) выставляла требования к модулю обфускации и его настройкам. Отдельный сотрудник ЕДИНОГО ЦУПИСа координировал совместную работу между нашими командами и людьми из Shtab.
Как я уже говорил, мы стали первопроходцами. Поэтому коллеги из Shtab активно собирали от нас обратную связь: что улучшить, добавить или изменить. Мы со своей стороны сформировали фокус-группу из десятка человек: эти люди тестировали инструмент, выявляли ошибки и предлагали улучшения.
Внедрение Shtab AI: сроки и технические детали
С нашей стороны самым долгим этапом стала закупка и настройка серверов. Мы закупали оборудование из-за границы — это небыстрый процесс. Параллельно обсуждали с Shtab будущую архитектурную схему: как развернуть инструмент, как привязать к общей авторизации, как будут приходить обновления. На подготовку и согласование ушло около двух месяцев — с конца мая до начала августа.
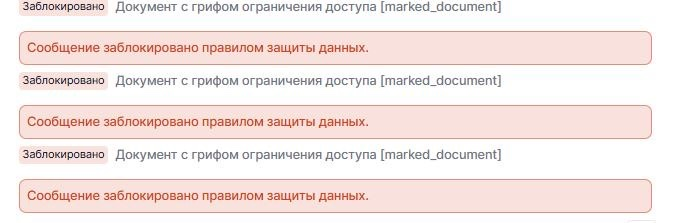
Довольно много времени ушло на обсуждение работы модуля обфускации — он называется Shtab Фильтр. Полтора месяца мы параллельно с обсуждением архитектуры прорабатывали требования к безопасности. Еще неделя ушла на настройку и создание правил для уже установленного в контур модуля.
Shtab Фильтр — это собственная разработка Shtab. Она работает на базе модели, которую команда Shtab создала и дообучила. В модуле предусмотрено три режима срабатывания: уведомление, маскирование и блокирование. Сотрудники, ответственные за ИБ, получают сообщения о нарушениях в любом из этих режимов.
Режим маскирования продуман особенно тщательно, чтобы пользователю было удобнее работать. В нём сотруднику не нужно править исходный текст запроса. Конфиденциальные данные на лету заменяются масками, например PHONE_1 вместо телефонного номера, и информация не выходит за пределы закрытого контура.
Чтобы работа с сервисом оставалась привычной, есть и механизм обратного маскирования. Пользователь видит свой запрос в исходном виде, а ответ LLM получает со своими исходными данными — Shtab подставляет их обратно.
Примерно две недели мы обновляли базу знаний и в целом готовились к появлению нового рабочего инструмента. В августе внедрение было завершено окончательно.
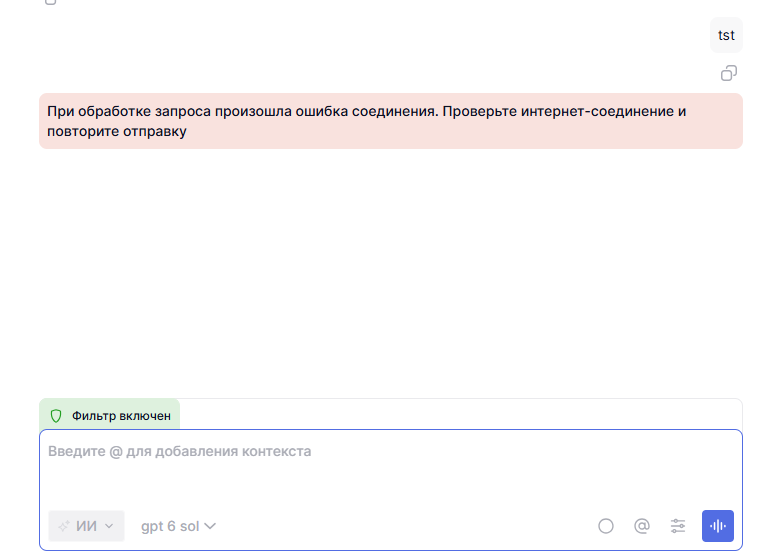
Сразу раскатывать ИИ-ассистента на всех сотрудников мы не стали. Первую неделю работали в тестовом режиме для отладки: выявляли неполадки, отслеживали баги, передавали обратную связь коллегам из Shtab. Нужно отдать должное — все найденные проблемы быстро исправлялись. И примерно через десять дней мы начали открывать доступ для сотрудников ЕДИНОГО ЦУПИС.
Миграцию данных пришлось проводить вручную
Чтобы не бросать сотрудников в новый инструмент без подготовки, под конец внедрения мы с коллегами из Shtab организовали совместный воркшоп. На нём рассказали про новую функциональность, чтобы коллеги не удивлялись, откуда в трекере задач взялся новый раздел.
Мы со своей стороны подготовили инструкции по использованию ИИ-сервиса. Всё ради того, чтобы миграция прошла относительно бесшовно. Это сработало — после воркшопа появилось много желающих поскорее опробовать новый сервис, поэтому проблем у нас не возникло.
Следующим этапом стала миграция пользователей из прошлого копайлота. Мы открыли для них доступ в Shtab AI, включили лицензии и постепенно отключили их в прошлом инструменте. А вот с миграцией данных получилось сложнее:
-
Наш прошлый инструмент не предусматривал возможность выгрузить уже наработанные чаты, где были, например, заготовки промптов.
-
Поэтому сотрудникам пришлось переносить диалоги вручную — грубо говоря, копипастом. Только так они могли сохранить важную информацию из старых чатов.
Не самое изящное решение, но негатива по этому поводу не возникло. Возможно, потому, что мы предупредили о ситуации заранее, и сотрудники были к ней готовы.
Что получилось «после»: выводы делать рано, но пока всё устраивает
На текущий момент мы пользуемся Shtab AI около месяца. Это слишком короткий срок, чтобы делать долгоиграющие выводы, но определенные удачные моменты мы отмечаем и сейчас. Перечислю по порядку.
Багов оказалось меньше, чем мы ожидали. За месяц работы мы зафиксировали где-то 20 обращений по поводу сбоев, но это в основном оказались мелкие недочеты. Честно говоря, поначалу мы переживали, что их количество будет исчисляться сотнями — но такого не произошло. Возможно, дело в том, что мы занялись отладкой заранее, еще на этапе внедрения.
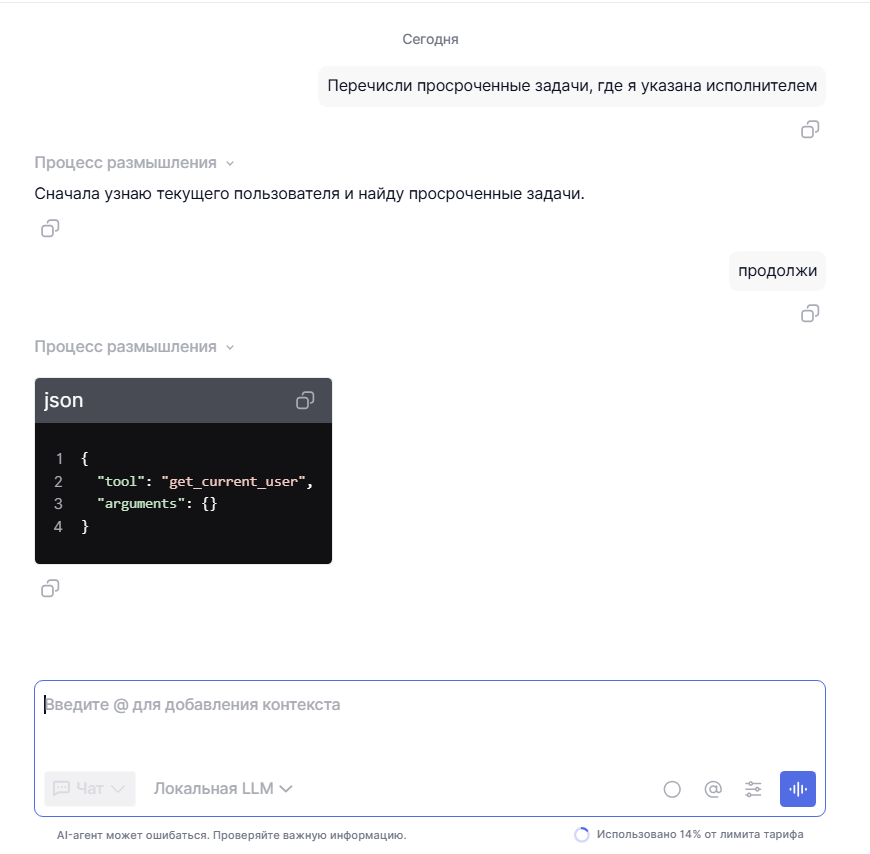
Внутренний ИИ помогает поддерживать безопасность данных. Мы подключили агента Shtab к локальной LLM, развернутой в нашем закрытом контуре, и в итоге получили возможность обрабатывать данные вообще без отправки на внешние сервера. Сотрудники могут работать с ними без риска, что чувствительная информация утечет наружу. Если кому-то нужно обратиться к внешней модели, внутренний ИИ не пустит в нее важные данные, например, сведения о задачах внутри Shtab.
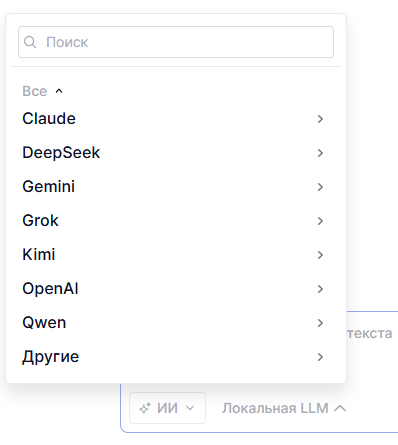
Работа с таск-трекером упростилась за счет агента. У ИИ-агента, подключенного к таск-трекеру, есть доступ к задачам, и это заметно ускоряет рутину. Покажу для примера несколько сценариев:
-
Сводка по проектам. Условно, можно спросить агента о своих просроченных задачах за такой-то период. Он пробежится по всем задачам в рамках моих прав доступа как сотрудника и сообщит о тех, где вышли сроки.
-
Саммари и выжимки. Я могу спросить агента, о чём та или иная задача, — он даст краткую сводку со всей ключевой информацией, и мне не придется искать детали в описании или комментариям к задаче.
-
Статистика по проектам. Можно спросить о конкретном проекте: сколько в нём задач, сколько из них выполнено, какие еще в работе. Агент соберет статистику, а при необходимости построит мини-график по ключевым показателям.
-
Режим действия. Описанные выше сценарии агент решает в режиме чтения. Но его можно перевести в другой режим, в котором он может редактировать задачи в рамках своих прав доступа. То есть я могу сказать: «Напиши комментарий к этой задаче», — надиктовать текст, и агент напишет всё за меня. Или, например, поменяет дедлайн, исполнителя, внесет другие нужные правки в проект или задачу.
В результате запросы формируются быстрее, а взаимодействовать с другими командами в рамках компании становится проще. Вместо того чтобы десять минут писать что-то руками, можно написать один промпт и передать информацию за минуту.
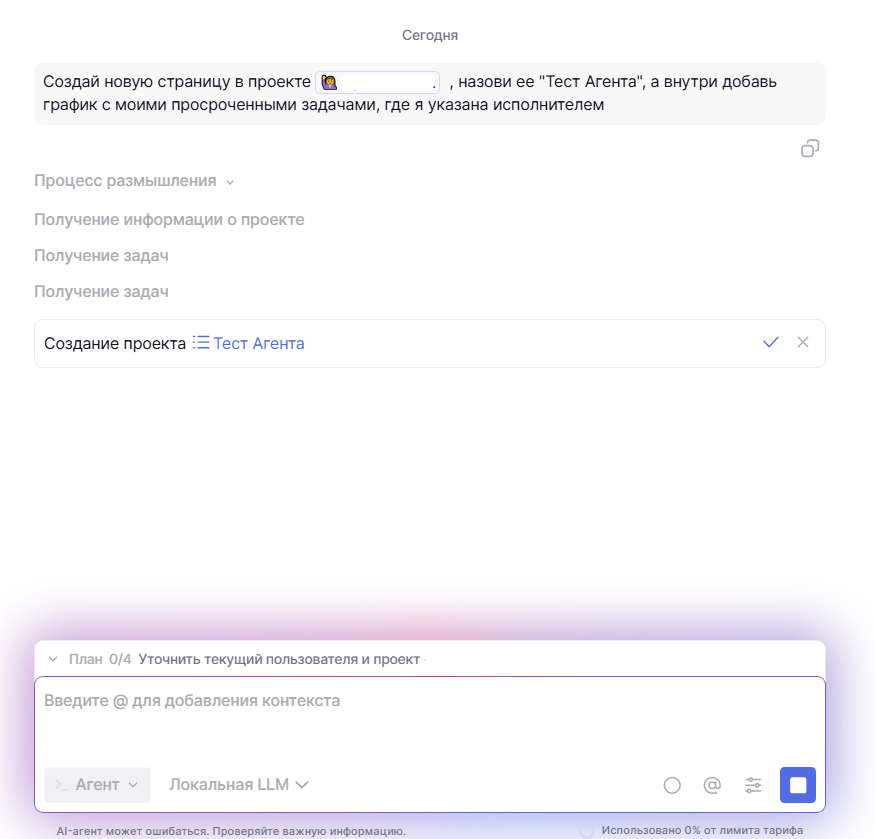
Приведу еще один пример. В Shtab есть такая функция, как Shtab Forms. Она работает примерно как другие инструменты для создания форм: можно создать анкету-опросник, разослать ее пользователям по ссылке и зафиксировать ответы. Результат падает в виде задачи в отдельный проект, настроенный под форму.
Так вот, когда Shtab Forms только появились, они были кошмарно неудобными. Чтобы создать форму, нужно было писать скрипты — буквально кодить ради простой анкеты. А это, естественно, умеют не все сотрудники. Сейчас всё проще: можно в режиме чата попросить агента создать форму с нужными параметрами, и он сделает всё буквально за минуту.
В общем, с точки зрения эффективности и безопасности решение оказалось крайне удачным. Но, конечно, не обошлось без минусов.
Что хотелось бы улучшить
Есть одна вещь, которую мне бы хотелось изменить. Это модель лицензирования.
-
С прошлым вендором модель была такой: у нас была определенная стоимость лицензии. Инференс в нее не входил, токены мы не считали. Была одна общая так называемая кубышка, из которой мы распределяли сотрудникам нужное количество инференса. Всё было перед глазами: сколько у нас есть денег, а сколько мы уже потратили.
-
В Shtab AI всё устроено по-другому. В одну лицензию для каждого сотрудника установлено определенное количество токенов, которые он может потратить. Если он этого не сделал — токены сгорают, а мы теряем деньги за неиспользованный инференс.
На мой взгляд, нынешняя модель лицензирования несовершенна. Возможно, мы будем ее пересматривать. А еще я намеренно написал об этом в статье, чтобы коллеги из Shtab точно заметили.
Подытоживаем: что было и к чему пришли
-
Ранее в ЕДИНОМ ЦУПИС было ИИ-решение от стороннего вендора. Ради безопасности данных мы использовали собственный модуль обфускации, который не пропускал чувствительную информацию во внешние модели.
-
Когда появился ИИ-инструмент от Shtab, решили перейти на него, чтобы работать в едином контуре. Нашли для себя немало преимуществ: возможность быстро получать обновления и гибко разграничивать доступ сотрудников к моделям.
-
Важным преимуществом стал модуль обезличивания данных Shtab Фильтр, встроенный в решение. Он распознает чувствительные сведения и не выпускает их во внешние модели. Модуль работает в трех режимах: уведомление, маскирование и блокирование данных, которые нельзя выносить наружу.
-
Мы выступили как первопроходцы для нового инструмента, вручную провели миграцию данных и некоторое время работали в тестовом режиме для отладки. Но багов и сбоев оказалось меньше, чем ожидалось от свежего решения.
-
Сейчас мы работаем с ИИ в едином закрытом контуре около месяца. Масштабные выводы делать рано, но ИИ-агент внутри таск-трекера как минимум упрощает рутину. Shtab Фильтр тоже работает без нареканий: за безопасность данных можно не переживать.
Если смотреть в целом — сотрудничество с Shtab оправдывает себя на 10 из 10. Мне нравится, что ребята отзывчивые, быстро приходят на помощь, с ними легко поддерживать общение. С Shtab комфортно работать. А мелкие недочеты постепенно решатся в процессе диалога.
Автор: shtab_app