
Как я за сутки восстановил свою соцсеть после того, как хостинг обнулил мой сервер
TL;DR. 2 ноября сервер моей соцсети «Агора» на Beget перестал отвечать. 3 ноября хостинг подтвердил: данные VPS обнулены, бинарные бэкапы потеряны. Меня спасли три вещи: зашифрованные офсайт-бэкапы базы, которые я настроил за день до аварии; escrow-ключ для личных сообщений, заложенный в схему ещё раньше; и скрипты переезда, которые я успел написать в репозитории. Агора открылась на новом сервере примерно через 3 часа после того, как Beget подтвердил потерю. Цена: примерно сутки данных и несколько граблей, о которых расскажу ниже. Главная моя ошибка: мастер-ключ шифрования лежал только в окружении серверного процесса и в бэкап не входил.
Коротко для тех, кто не читал прошлые статьи
Я Арсений, мне 15 лет, единственный разработчик «Агоры», российской соцсети для учеников, учителей и студентов. В первой статье я рассказывал, как написал её с нуля, во второй разбирал комментарии и то, что изменилось за три месяца. Сейчас пользователей около 200, и всё так же без единого рубля на рекламу.
Стек, чтобы было понятно, что именно падало:
-
React + TypeScript + Vite, статика сайта лежит на обычном хостинге (jino);
-
self-hosted Supabase (Postgres 17) в Docker, рядом Bun-сервисы под PM2 и Caddy в Docker;
-
личные сообщения с E2E-шифрованием;
-
Android-приложение на Expo / React Native;
-
медиа в Яндекс Object Storage.
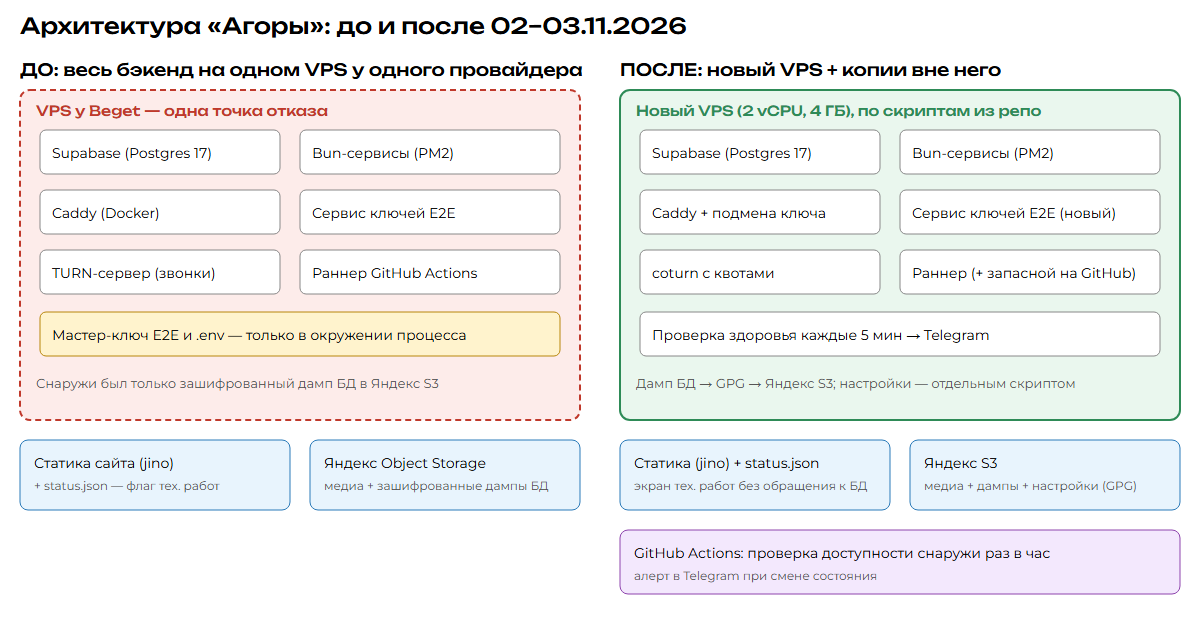
Весь бэкенд жил на одном VPS у Beget. Спойлер: это была главная архитектурная ошибка, и в выводах я к ней вернусь.
Хронология
-
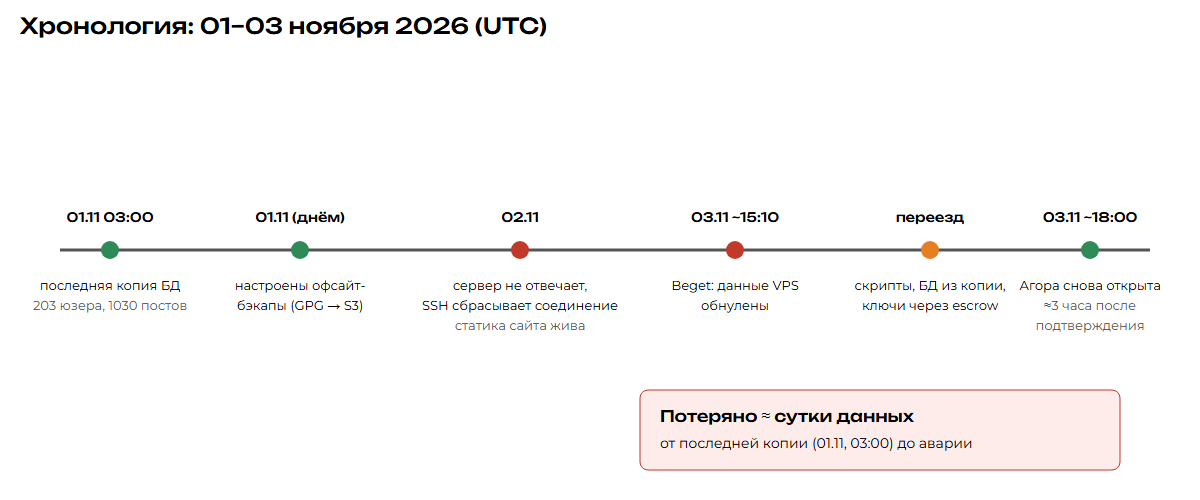
01.11: днём я настроил офсайт-бэкапы базы:
pg_dump→ GPG-шифрование → Яндекс S3, недельные и месячные копии. Последняя копия сделана 01.11 в 03:00 UTC. -
02.11: сервер перестал отвечать: SSH сбрасывает соединение, API молчит. Статика сайта на другом хостинге жива. Позже выяснилось, что это кибератака на Beget (новость на Хабре).
-
03.11, около 15:10 UTC: Beget подтвердил, что данные VPS, S3 и K8s обнулены, бинарные бэкапы VPS потеряны, остались только файловые. Совет один: сменить все ключи.
-
03.11, около 18:00 UTC: Агора снова открыта на новом сервере.
В копии, с которой я поднимался: 203 пользователя, 1030 постов и около 1800 личных сообщений. Всё, что случилось после 03:00 UTC 01.11, потеряно, то есть примерно сутки.
Бэкап базы: настроил за день до аварии (повезло)
Я давно знал, что копия «на том же сервере» на самом деле не копия. Скрипт после ночного дампа шифрует его GPG (на сервере лежит только открытый ключ, закрытый у меня) и кладёт в Яндекс S3: воскресные копии храню 4 недели, копии первого числа 6 месяцев.
Тогда же я проверил весь путь: скачал, расшифровал, развернул, посмотрел, что таблицы на месте. Без такой проверки дамп ещё не бэкап: о проблемах узнаёшь в самый плохой день.
А вот настройки сервера в бэкап не входили. Ни .env, ни конфиги Caddy, ни compose-файлы. Это оказалось самым болезненным, об этом дальше.
Мастер-ключ потерян, личные сообщения нечитаемы
Личные сообщения в Агоре шифруются сквозным шифрованием. Приватные ключи пользователей хранятся на сервере, но зашифрованными мастер-ключом отдельного сервиса ключей. Этот мастер-ключ лежал только в окружении серверного процесса. В бэкап он не входил, офлайн-копии у меня не нашлось.
В итоге база есть, а все приватные ключи превратились в набор нечитаемых байтов. Вся старая переписка нечитаема. Это моя ошибка.
Выручило то, что в схему заранее был заложен escrow: к каждому зашифрованному сообщению прилагается копия, которую открывает ключ оператора. Этот ключ хранился у меня локально, отдельно от сервера. Это был «план Б», в который я, честно говоря, не очень верил.
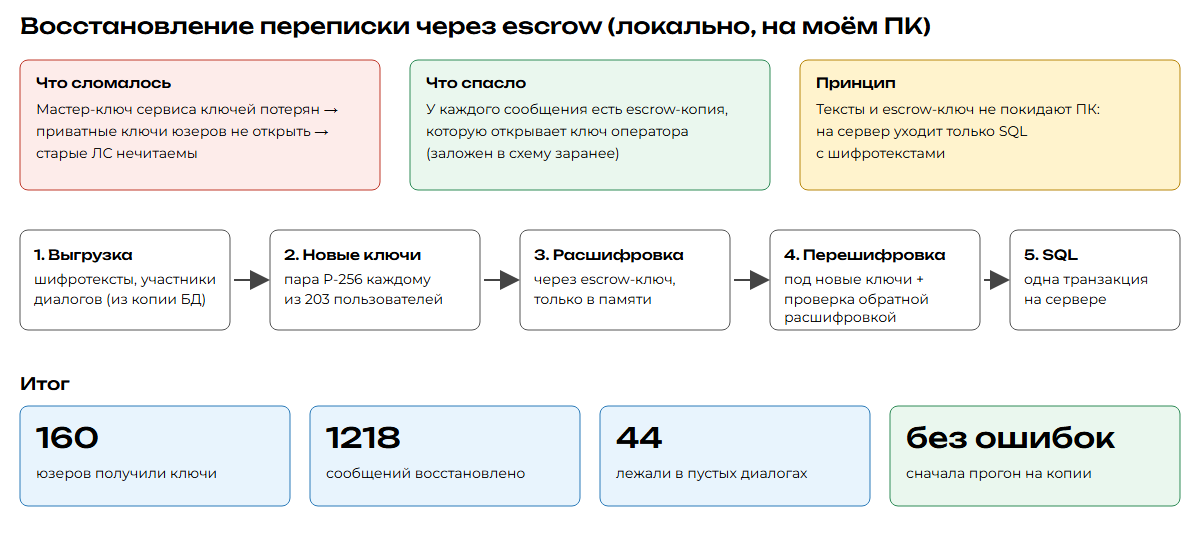
Я написал скрипт, который работает целиком на моём компьютере (ни тексты сообщений, ни escrow-ключ никуда не уходят):
-
читает выгрузку шифротекстов и состав диалогов из копии базы;
-
генерирует новую пару ключей каждому из 203 пользователей, приватную часть оборачивает новым мастер-ключом;
-
расшифровывает каждое сообщение через escrow;
-
шифрует заново: если в диалоге двое, то обычным форматом на пару ключей; если остался один, то на его ключ; если никого, то не трогает;
-
каждое новое сообщение проверяет обратной расшифровкой;
-
пишет SQL одной транзакцией, который я применяю на сервере до запуска сервиса ключей с новым мастер-ключом.
Спойлер: Упрощённая логика скрипта (без ключей)
for (const msg of data.messages) {
  const text = await decryptEscrow(msg.escrow_content);   // ключ оператора, только в памяти
  const members = membersOf[msg.conversation_id];

  if (members.length === 2) {
    content = await encryptForPair(text, sender, peer);    // на пару ключей
    assert(await decryptAsPeer(content) === text);        // проверка с обеих сторон
    assert(await decryptAsSender(content) === text);
  } else if (members.length === 1) {
    content = await encryptForOne(text, members[0]);      // на ключ единственного участника
    assert(await decryptAsOwner(content) === text);
  } else continue;                                        // диалог без участников

  sql.push(updateMessage(msg.id, content));
}
Сначала я полностью прогнал скрипт на копии базы: ошибок не было. Только после этого пошёл боевой прогон.
Результат: новые ключи получили 160 пользователей, восстановлено 1218 сообщений, ещё 44 лежали в пустых диалогах (из них не осталось ни одного участника), ошибок 0. Клиенты сами замечают новый публичный ключ в профиле и забирают новый приватный из сервиса ключей.
Раз я писал про E2E в прошлых статьях, скажу про escrow отдельно. Escrow это компромисс, и делать вид, что его нет, я не буду. Он ослабляет идею «сервер ничего не может прочитать», зато именно он вернул людям переписку. Если у вас так не устроено, храните мастер-ключ хотя бы в нескольких местах офлайн.
Новый сервер: переехал по скриптам из репозитория
Я арендовал VPS в Санкт-Петербурге: 2 vCPU, 4 ГБ, 50 ГБ. План переезда и скрипты я написал ещё 02.11, пока ждал ответа от Beget, поэтому разворачивание шло по списку:
|
Шаг |
Что делает |
|---|---|
|
bootstrap |
система, SSH только по ключам, firewall, Docker, Bun, PM2 |
|
setup-supabase |
ключи, |
|
restore-db |
заливка дампа |
|
make-env |
|
|
ecosystem (PM2) |
запуск сервисов |
|
Caddyfile |
HTTPS и домены |
Все ключи Supabase (JWT-секрет, anon- и service-ключи, пароль базы) пришлось сделать новыми: старые значения лежали на уничтоженном сервере. Из-за этого появилась первая проблема.
Старые сборки приложения получали 401, починил в Caddy
Публичный anon-ключ был вшит в уже вышедшие сборки Android-приложения и в другие мои проекты. JWT-секрет утерян, ключ теперь новый, и старые клиенты получали 401. За первые три часа набралось 106 неудачных входов по OTP. Обновление по воздуху (OTA) до людей со старыми сборками не доходило.
Решение: Caddy подменяет старый ключ на новый в заголовках apikey и Authorization и в query-параметре (так подключаются websocket-ы Supabase Realtime):
@old_apikey header apikey {$OLD_ANON_KEY}
request_header @old_apikey apikey {$ANON_KEY}

@old_bearer header Authorization "Bearer {$OLD_ANON_KEY}"
request_header @old_bearer Authorization "Bearer {$ANON_KEY}"

@old_ws query apikey={$OLD_ANON_KEY}
uri @old_ws query apikey {$ANON_KEY}
Значения подставляются из окружения Caddy. Это безопасно, потому что anon-ключ публичный и даёт права только гостя. Заодно заработали сайты и приложения, которые я не успевал пересобрать.
Веб-пуши умерли, Android-пуши отправил вручную
Новые VAPID-ключи значит старые подписки мертвы, браузеры переподписываются при следующем входе. Пуши в Android я разослал прямо с сервера по токенам устройств из офсайт-копии (Expo-токены от наших ключей не зависят).
Экран «технические работы» не показывался (завис ≠ упал)
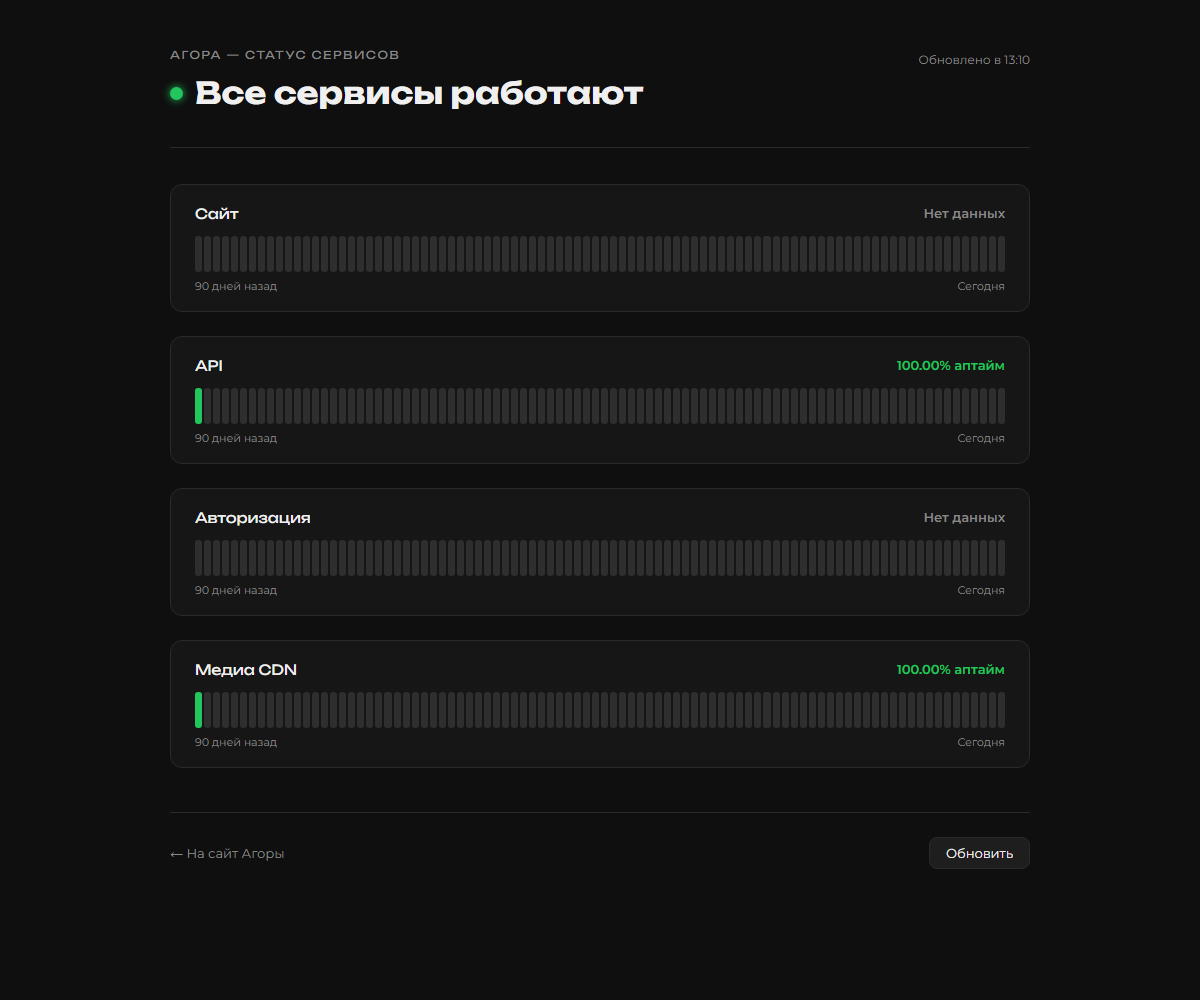
Флаг тех. работ лежит отдельно, как status.json на статик-хостинге, и задумано это было ровно на такой случай. Но экран не показывался. Причина в том, что сервер не упал, а завис. Запрос в базу без таймаута держал загрузку минутами, а флаг проверялся вместе с этим запросом.
Исправил так: AbortSignal на 8 секунд на запрос в базу, а если во флаге enabled: true, экран показывается сразу, не дожидаясь базы. Вывод: таймауты нужны везде, особенно в проверках «всё ли в порядке».
Мониторинг дважды промолчал
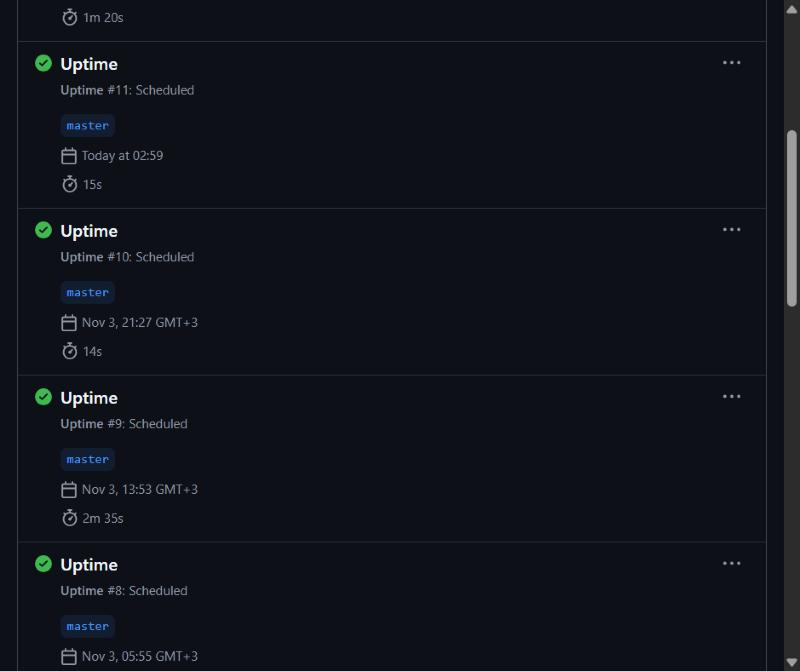
У меня была внешняя проверка доступности в GitHub Actions раз в час. Во время аварии она дважды не прислала алерт:
-
code=$(curl ...)подbash -eпадал на таймауте (код 28), и шаг умирал вместо отправки уведомления. Лечится|| true; -
четыре проверки с повторами не влезали в
timeout-minutes.
Исправленный кусок:
check() {
  for i in 1 2; do
    # || true: при таймауте curl выходит с ошибкой, и без этого
    # bash -e ронял весь шаг вместо уведомления
    code=$(curl -s -m 10 --connect-timeout 8 -o /dev/null -w '%{http_code}' "$2" || true)
    [ "$code" -ge 200 ] && [ "$code" -lt 500 ] && return
    sleep 10
  done
  echo "• $1 (код $code)" >> problems.txt
}
Ещё заметил, что GitHub-cron срабатывал заметно реже, чем раз в час. Как единственная защита этого мало, но как внешняя проверка лучше, чем ничего.
Деплой не работал, потому что раннер стоял на упавшем сервере
Деплой шёл через self-hosted раннер GitHub Actions, который стоял на самом сервере. Сервер лёг, и деплоить стало нечем. Я добавил в deploy.yml входной параметр runner: по умолчанию self-hosted, но в аварию можно запустить на ubuntu-latest. Заливка с GitHub-раннеров по FTP ловила таймауты хостинга, поэтому для неё я заменил FTP-экшен на lftp mirror (заливка занимает около 15 минут).
Звонки: TURN-сервер тоже был на Beget
Звонки 1-на-1 (WebRTC) требуют TURN-сервера для пользователей за NAT. Мой TURN тоже стоял на Beget и тоже был уничтожен. Какое-то время при нажатии на звонок показывалось сообщение «временно не работают» (флаг лежит в базе, чтобы клиенты не пытались соединяться зря).
Потом я поднял coturn на основном сервере. Раз он теперь делит машину с Supabase, ограничений пришлось добавить побольше:
-
слушает только публичный IP;
-
квоты на сессии и ограничение скорости;
-
запрещён relay на приватные и служебные диапазоны (защита от SSRF через TURN и от доступа к docker-сетям Supabase);
-
без TCP-relay и без CLI;
-
ограниченный диапазон relay-портов.
Креды выдаются по схеме TURN REST: временное имя <время жизни>:<id пользователя> и пароль как HMAC от него. Эндпоинт сначала проверяет токен пользователя. Проверка через релей между разными сетями: около 115 пакетов в секунду в каждую сторону.
Ещё одна ловушка: TTL кредов я поднял до 8 часов, иначе звонок через релей обрывается, когда протухают креды.
Telegram-алерты с нового сервера: IPv6 не доступен, HTTP/2 виснет
С нового сервера Telegram по IPv6 недоступен, а POST по HTTP/2 просто висел. Помогло curl -4 --http1.1. Сами алерты это скрипт, который каждые 5 минут проверяет диск, память, PM2, контейнеры, API и свежесть бэкапа и пишет сообщение только при смене состояния.
Мелочи, которые вылезли позже
-
Ссылки на старый CDN-домен в базе (в постах, комментариях, группах) переписал на новый, остатков не осталось.
-
Модель NSFW-проверки лежала только на старом сервере. После переезда проверка загрузок молча не работала: ни ошибки, ни предупреждения. Скачал модель заново, и сервис написал «модель загружена». Тихие отказы самые неприятные.
-
Платёжный магазин в ЮKassa оказался другим, чем в моих старых записях: на «старых» данных приходил 401. Разобрался, и платежи заработали.
Выводы
-
Ключи шифрования и
.envнадо класть в зашифрованный офсайт-бэкап, а не держать только в окружении процесса. Теперь отдельный скрипт собирает все.env, конфиги Caddy и compose-файлы в GPG-архив и отправляет в облако. -
Бэкап, который не проверяли восстановлением, не бэкап. Мне повезло, что я успел проверить хотя бы базу. Но проверял только её, а про мастер-ключ так и не спросил себя «а что, если его нет?».
-
Скрипты переезда надо хранить в репозитории. Не «я помню, как это делается», а
bootstrap.shи README с порядком шагов и списком подводных камней. Например, подсеть Docker для Supabase пришлось создавать вручную с конкретным диапазоном: триггеры в базе шлют вебхуки на фиксированный адрес шлюза. -
Мониторинг не должен жить на том же хосте, что и проверяемое. Раннер, алерты, проверки здоровья должны переживать падение основного сервера.
-
Таймауты везде: запросы к базе,
curl, джобы Actions. Зависший сервер хуже упавшего. -
Один провайдер это одна точка отказа. Это известная истина, но «хостинг большой, с бэкапами» оказался слабым аргументом: бинарные бэкапы VPS пропали вместе с самим VPS.
-
У E2E должен быть «план Б» (escrow или несколько офлайн-копий мастер-ключа), иначе одна потерянная переменная окружения стоит всей переписки.
Цифры на сегодня
-
~3 часа от подтверждения потери данных до открытой Агоры;
-
~сутки данных потеряно (копия от 01.11, 03:00 UTC);
-
203 пользователя, 1030 постов в копии;
-
1218 личных сообщений восстановлено, 0 ошибок;
-
106 неудачных OTP-входов со старых сборок за первые три часа.
Что дальше
Осталось много уборки: часть настроек (например, конфиг coturn) всё ещё не входит в автоматический бэкап, и при следующем переезде мне придётся воссоздавать его по заметкам. TLS для TURN не настроен, клиенты откатываются на обычный порт. И я хочу, наконец, вынести мониторинг на отдельный сервер, чтобы он не падал вместе с остальным.
Половина проблем возникла из-за моих же решений (ключ только в окружении, раннер на том же сервере, забытые таймауты). Но три вещи, сделанные заранее, помогли: вместо катастрофы вышел просто очень тяжёлый день.
Как и в прошлый раз, пишу, чтобы зафиксировать опыт. Если у вас есть вопросы по конкретным решениям или идеи, как сделать лучше, пишите в комментариях, буду рад разобрать.
Ссылка на проект, социальную сеть для учеников, учителей и студентов: agorasocial.ru.
Автор: ars_stu