
Впихнуть невпихуемое: что теряет Claude Code при сжатии контекста
Когда контекст у Claude Code заканчивается, модель пересказывает разговор, и дальше агент работает с пересказом. Это и есть сжатие. Я был уверен, что после него половина обсужденного пропадает: агент забывает, какой файл мы правим, на какой коммит смотрели и о чем договорились. Мы в Lamantin AI делаем kaeru — память для агентов, которая как раз должна подхватывать такое после сжатия. Поэтому сначала я решил проверить, что именно теряется.
Я разобрал 99 сжатий из своих логов Claude Code и Codex. Договоренности из последних реплик и номера мерж-реквестов почти всегда переживают сжатие, хэши коммитов — в девяти случаях из десяти. А вот среди путей к файлам, ссылок и номеров задач, к которым агент возвращался после сжатия, примерно четыре из десяти я в переданном ему контексте не нашел.
По цифрам:
-
Договоренности из последних реплик: 243 из 265 оказались в выжимке целиком, еще 19 — частично.
-
Номера мерж-реквестов и хэши: нашлись все 14 номеров, но потерялись 7 из 66 хэшей.
-
Пути, ссылки и номера задач: не нашлись 172 из 426.
Оказалось, что полученные цифры врали. Далее — расследование, кто на самом деле виноват, и что я сделал с полученной информацией.
Что агент получает после сжатия
Пересказ — это не единственное, что достается агенту. По логам Claude Code после сжатия у него есть:
-
выжимка — цель, что сделали, какие файлы трогали, на чем остановились;
-
несколько последних сообщений дословно;
-
недавно прочитанные файлы — Claude Code прикладывает их следом.
Если детали нет ни в одном из этих мест, агенту нужно искать ее заново, вспоминать по косвенным признакам или доставать из памяти, если таковая имеется. Вопрос в том, чего там нет.
Claude Code пишет все это в JSONL-логи, и сжатие видно в них отдельной записью. У Codex выжимка зашифрована, поэтому ее содержимое я проверял на Claude Code: 67 сжатий с июня по октябрь.
Все пропало!
Первый подсчет был простой и до ужаса примитивный. Взять все пути, ссылки, хэши и номера, которые встречались и до сжатия, и после, и проверить, есть ли они в выжимке и сохраненных сообщениях. Не нашлись 955 из 1 330. Итог — 72% потерь.
Алярм! Лично Дарио настроил харнесс так, чтобы перерасходовать токены!
Но в эту кучу попало много мусора. Путь из стектрейса мог мелькнуть в выводе команды и до сжатия, и после, хотя агенту он был не нужен. А часть «потерь» на самом деле лежала в выжимке.
Самый показательный случай — самый обычный файл конфига. До сжатия Claude Code правил этот файл, а после сжатия пошел читать его заново, по полному пути, как в первый раз. Скрипт записал файл в потери, и выглядело это подозрительно: агент забыл, с каким файлом работал. Я открыл выжимку. Файл был там, прямо в строке «Edited src/config.rs: added CommandSpec struct». Ошибся не агент, а скрипт: регулярное выражение пропускало короткие пути.
Поэтому я сузил вопрос. Считаю только то, что встречалось до сжатия и что агент сам написал после, в команде или в ответе. Так хотя бы видно, что деталь пришлась к месту. И переписал скрипт так, чтобы он узнавал короткие пути.
Что теряется на самом деле
После этого осталось 506 таких деталей:
-
300 (59%) нашлись в выжимке или сохраненных сообщениях;
-
27 (5%) — в приложенных файлах;
-
179 (35%) в переданном контексте не нашлись.
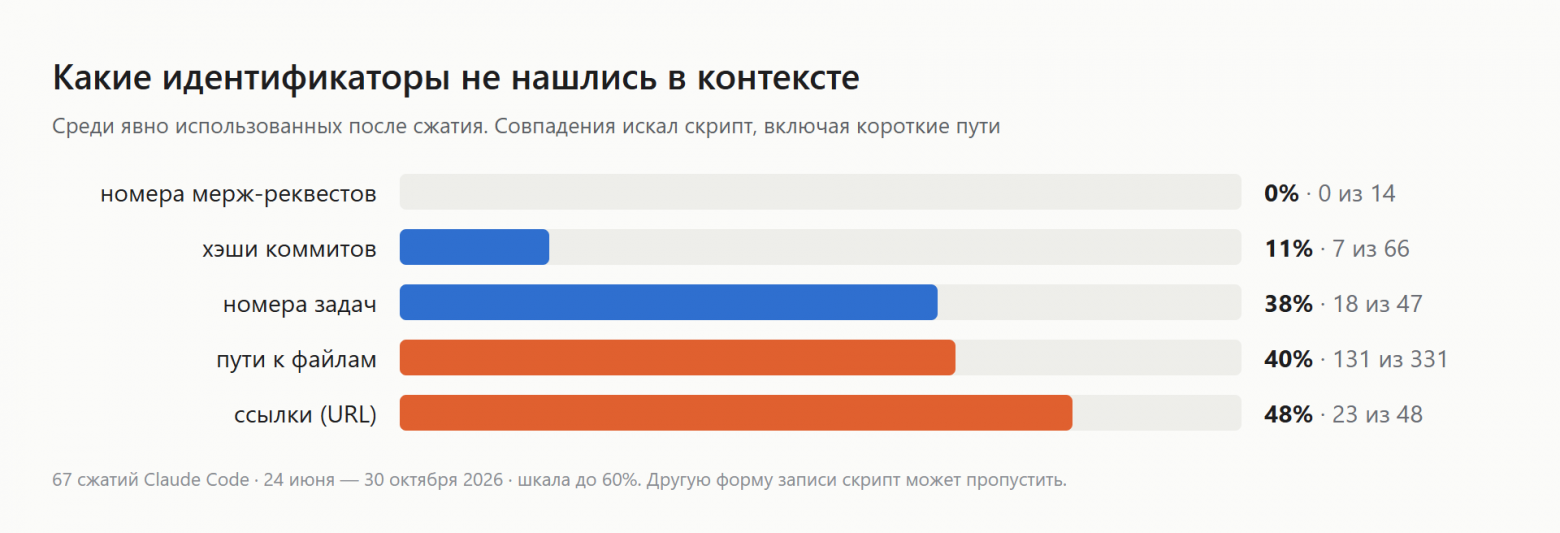
По типам разница большая. Номера мерж-реквестов нашлись в переданном контексте все, хэши — почти все. А пути, ссылки и номера задач скрипт не нашел примерно в 40% случаев. Подумалось: короткий номер удобно вписать в пересказ, а длинный путь модель заменяет словами вроде «правили конфиг». Но это догадка, я ее не проверял.
Откуда агент брал эти 179 деталей? 82 впервые появились после сжатия в выводе Bash, PowerShell или Read; искал ли их агент специально, по логу не понять. Одна впервые появилась в ответе kaeru. Остальные 96 агент написал без видимого источника в логе. Может, восстановил по косвенным признакам, а может, скрипт не узнал другую форму записи.
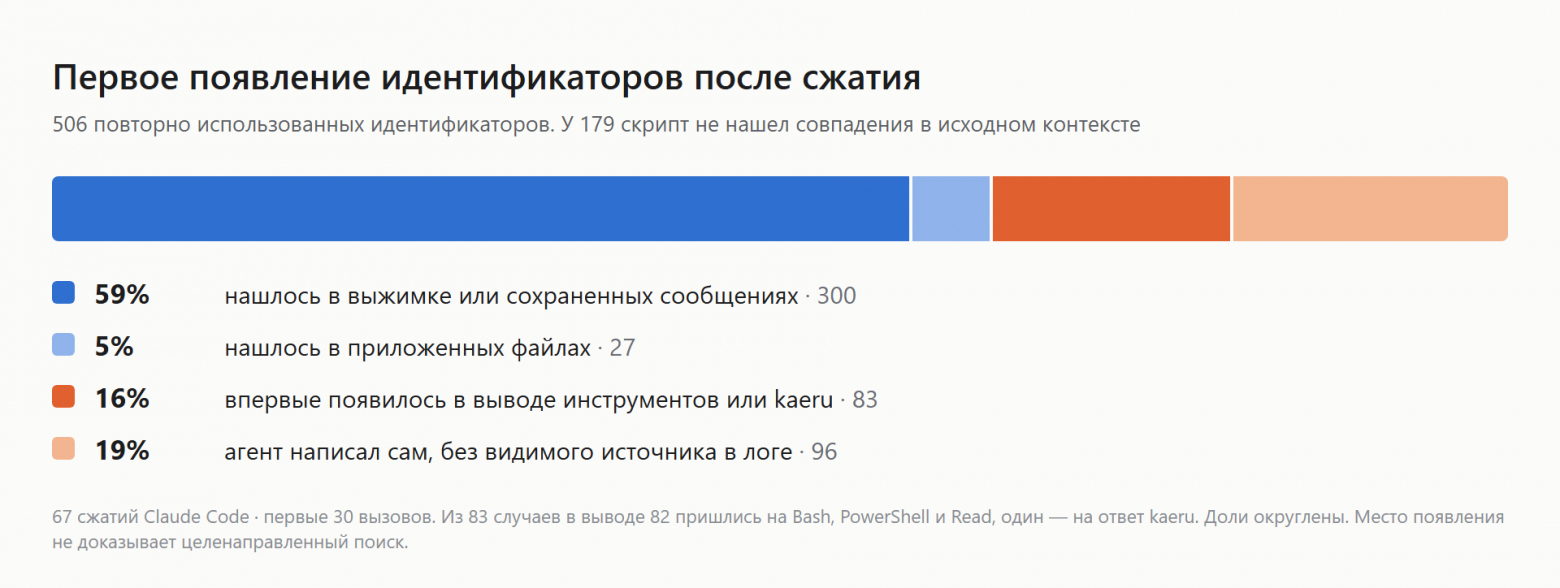
При этом 35% — это не «агент забыл». Деталь, которую агент забыл и больше не упомянул, в такой подсчет вообще не попадает. Это доля того, к чему агент вернулся, но чего скрипт не нашел в переданном ему контексте.
Договоренности и нарушение, которого не было
Смысл сравнением строк не проверить. Поэтому для договоренностей я взял последние реплики перед 60 сжатиями и выписал из них решения: «пушим только после моего одобрения», «этот файл не трогаем» и тому подобное. Набралось 298. Руками такой объем перелопачивать долго, поэтому разметкой занималась модель, я лишь апрувил. Каждую договоренность и каждый компакт модель оценила дважды, независимо, а в итог вошли только совпавшие оценки.
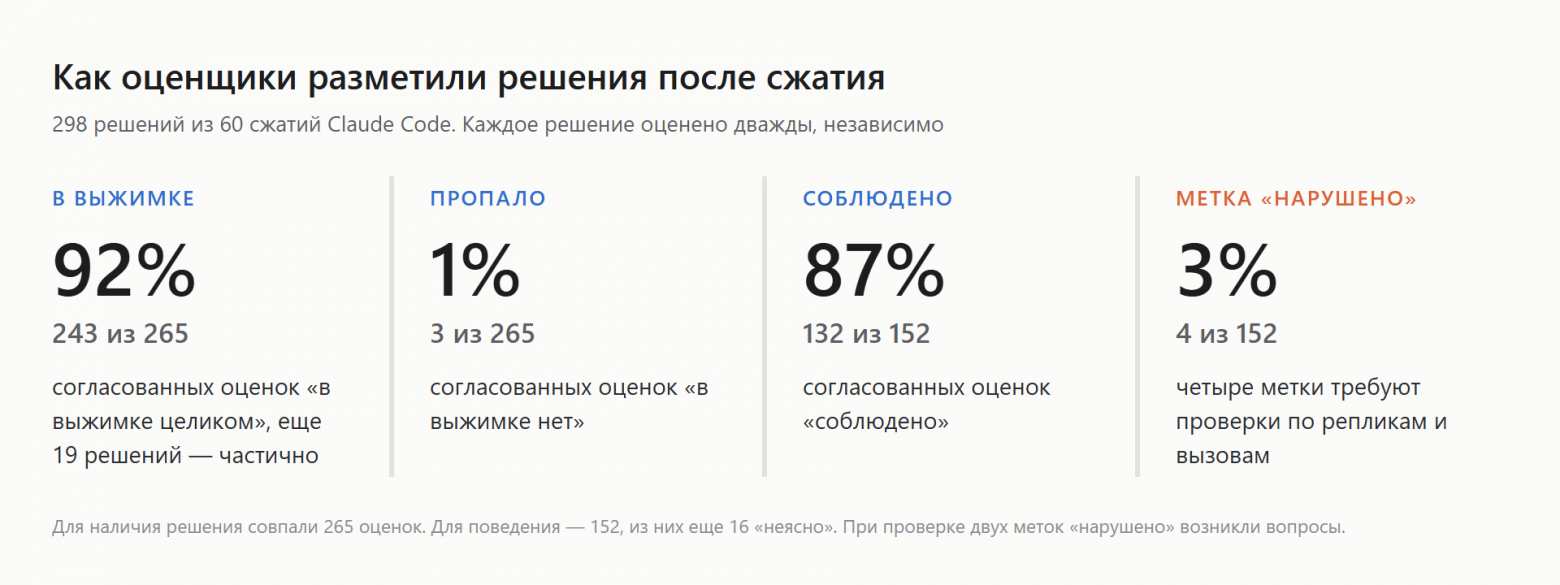
Из 265 решений, где оценки совпали, 243 сохранились целиком, 19 частично, 3 пропали: «вынести манифест на отдельную страницу», «в задачах писать от первого лица» и «списать время за пятницу». Все это решения из последних реплик. Что будет с договоренностью, данной за сотню вызовов до сжатия, эти данные не говорят.
Отдельно разметка оценивала, соблюдал ли агент решение после сжатия. Из 152 решений, где это было видно и оценки совпали, четыре получили метку «нарушено». Самым интересным оказался один из них. Перед сжатием я написал:
конечно, делай. запуск только после моего одобрения
В выжимке это осталось:
Announce readiness and WAIT for Ivan’s «го» before running the full path.
А первое сообщение агента после сжатия:
Талон не ушёл — 400 на печати
Попался! Агент решил своевольничать и запустил сценарий без разрешения! Оба прогона разметчиков так и решили.
Смотрю лог, нахожу свое «го»: до сжатия, но уже после той просьбы. А в первых 30 вызовах после сжатия нового запуска без разрешения не видно. Агент разбирает ошибку, смотрит форму запроса, читает DTO. Агент опять остался чист.
Как и с конфигом, подвел не агент, а мой способ его проверять.
Что из недостающего нашлось в памяти
Как агент подхватывает из kaeru работу в новой сессии, я показывал в прошлой статье. Здесь мне было важно, сколько из 179 деталей пришло из памяти. Впервые в ответе kaeru появилась одна.
Сначала я расстроился, потом пошел проверять, было ли там что доставать. Для 14 из 179 деталей нашлись вызовы записи в kaeru до сжатия с ответом об успехе. Для одной я восстановил память на момент сжатия: хэш 12ce9e1 записан 7 августа в 19:57 UTC, контекст сжался в 20:19, и заметка с хэшем к этому моменту лежала на месте. Остальные 13 совпадений я по смыслу не проверял: номер задачи мог совпасть и случайно.
Значит, как минимум одна деталь лежала в памяти на момент сжатия, а чтения этой записи после сжатия я в логе не нашел. Помогла бы она агенту — не проверял. Зато, разбираясь, нашел дефект в нашем же установщике. Напоминание «загляни в память» для Claude Code срабатывало при старте, продолжении и очистке сессии, но не после сжатия. Мои результаты это не объясняет: у меня стоят свои хуки, и после сжатия они срабатывали. А вот у тех, кто включал напоминание в установщике, подсказки после сжатия не было. Исправление уже в основной ветке.
Станет ли агент от этого ошибаться реже, я пока не мерил. Для этого нужно прогнать одинаковые задачи без памяти и с ней — это следующий эксперимент. Ну и главное, напоминание — только подсказка заглянуть в память, а не гарантия, что агент найдет там нужное.
Что в итоге
В моих сессиях договоренности из последних реплик в основном пережили сжатие. Номера мерж-реквестов нашлись в контексте все, хэши — почти все. Хуже с путями к файлам, ссылками и номерами задач: среди тех, к которым агент возвращался после сжатия, примерно четыре из десяти скрипт в переданном контексте не нашел. Чего агент не вспомнил вовсе, такой разбор не видит. А две самые громкие «потери» оказались ошибками моего подсчета и способа разметки.
Что я поменял у себя
Прошу выжимку перечислять пути и ссылки. Когда сжимаю вручную, добавляю к /compact: «перечисли пути к файлам, ссылки и коммиты, с которыми работали».
Жесткие запреты держу вне разговора. «Не пушить без подтверждения» сжатие переживает, но надежнее, когда такое записано в правилах проекта или проверяется хуком.
После сжатия напоминаю агенту про память. В Claude Code для этого добавляю compact в matcher хука SessionStart:
“SessionStart”: [
   {
      "matcher":"startup|resume|clear|compact",
      "hooks":[
         {
            "type":"command",
            "command":"ваш-скрипт-напоминания"
         }
      ]
   }
]
Прежде чем ругать агента, проверяю свои инструменты. Сначала смотрю выжимку и порядок реплик до сжатия, и только потом его действия.
Насколько это помогает, проверю следующим экспериментом.
Если ловили агента на том, что после сжатия он что-то забыл, расскажите в комментариях, что именно. Особенно интересно, была ли эта деталь в выжимке.
Как я считал
Для тех, кто захочет провести расследование и поймать за руку агента самостоятельно. Подход тот же, что в первой статье: читаем собственные логи агентов, а не ставим отдельный эксперимент.
-
Данные. 231 сессия Claude Code с апреля по начало ноября и сессии Codex за ноябрь. После удаления дублей — 67 сжатий в Claude Code и 32 в Codex. Дубли появляются, когда продолженная сессия копирует историю вместе со старыми границами сжатия; таких нашлось 38, отсеивал по идентификатору границы. 64 сжатия Claude Code из 67 автоматические, медианный размер контекста перед ними — около 973 тысяч токенов. Модели и версии клиентов за это время менялись.
-
Окно. После каждого сжатия брал до 30 вызовов инструментов.
-
Детали. Пути, ссылки, хэши, номера задач и мерж-реквестов искал скрипт. Внутри одного сжатия деталь считалась один раз. Пути сравнивал по двум последним сегментам, поэтому разные файлы с одинаковым окончанием могут совпасть. При проверке источников нашлась еще одна ошибка: семь деталей скрипт приписал kaeru, хотя они пришли из приложенного файла.
-
Решения. Черновую разметку делала языковая модель, в два независимых прохода; в доли вошли только совпавшие оценки. Спорные эпизоды я проверял по логам. Если будете повторять, давайте модели данные небольшими порциями: в моих прогонах модель не дочитывала пакеты больше 100 тысяч токенов.
-
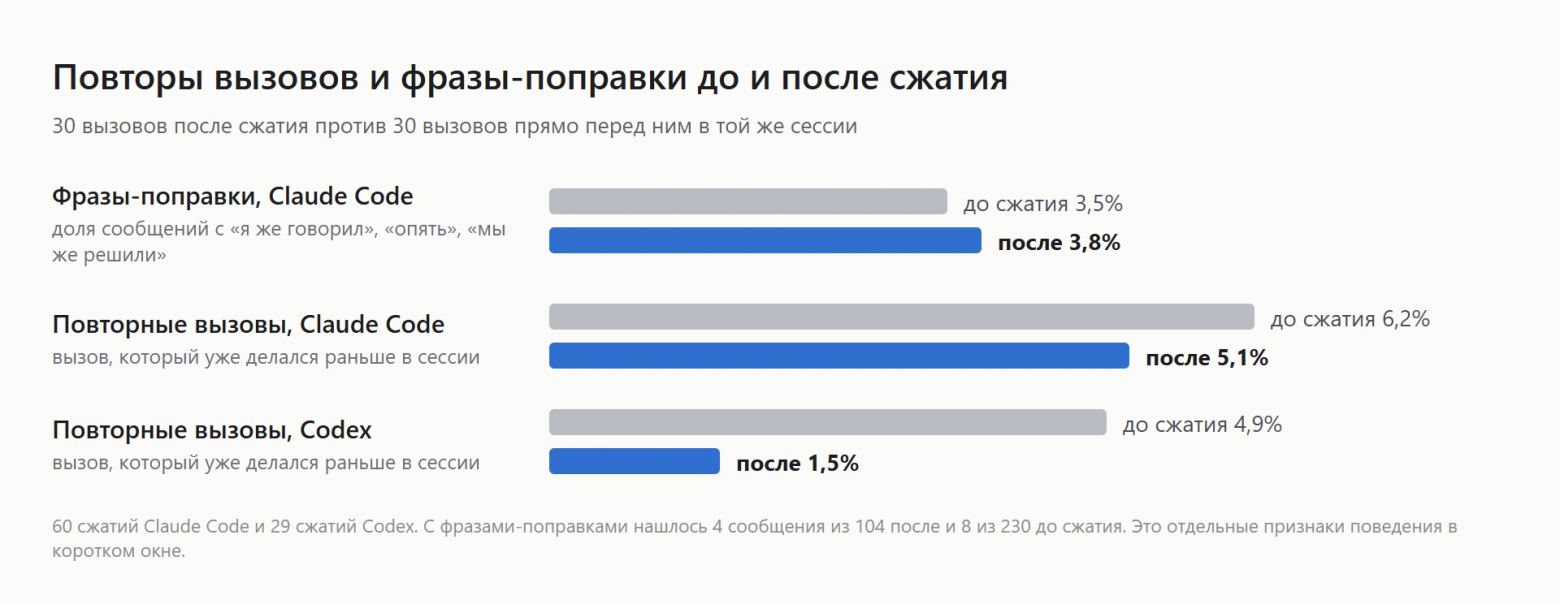
Повторы. Отдельно проверил, не начинает ли агент после сжатия чаще повторять вызовы, а я чаще поправлять его. Сравнивал 30 вызовов после сжатия с 30 до него в той же сессии; для этого подошли 60 сжатий Claude Code и 29 Codex. Доля повторных вызовов не выросла: у Claude Code 5,1% после против 6,2% до, у Codex — 1,5% против 4,9%. Мои фразы вроде «я же говорил» — в 4 из 104 сообщений после сжатия и в 8 из 230 до; их слишком мало, чтобы о чем-то судить. Повтор старой работы с другими аргументами такая проверка пропустит.
Чтобы найти сжатия у себя: в Claude Code ищите compact_boundary в JSONL-файлах внутри ~/.claude/projects, выжимка помечена как isCompactSummary. В Codex это запись compacted с полем replacement_history.
Автор: ceounittt