
Экономим токены Claude Code с помощью принципов Event Loop
Последние месяцы я делаю фичи в Claude Code не одним агентом, а командой: ведущий режет работу на задачи, кодеры пишут, рецензент смотрит, проверяющие принимают. Сначала это был чужой плагин, в который я коммитил свои улучшения, потом свой. После каждой серии прогонов я что-то в нём дорабатывал.
Довольно быстро выяснилось, что самый дорогой участник такой команды: не кодер и не рецензент, а ведущий, который просто ждёт. Его будит только внешнее событие, тишину команды он не отличает от её смерти, и каждое «посмотрю, как там дела» оплачивается всем его контекстом, а к середине прогона это сотни тысяч токенов. Одна пересылка письма через ведущего при контексте 437k стоила $0,38 по ценам API.
Из этого вырос supertick, плагин для Claude Code, в котором ожиданием занимается скрипт, а не модель. Код открыт под MIT: https://github.com/denizen24/supertick. Ниже расскажу, как он устроен, как поставить, как он выглядит на живой задаче, сколько стоили две задачи на финальной версии, где в команде фронтирные модели GPT и на какие грабли я наступил по дороге.
1. Проблема: ведущий, который ждёт
В командном режиме Claude Code ведущий является обычной сессией модели. Просыпается он от внешнего события: сообщения участника, уведомления о завершении субагента, возврата фонового вызова. Если события нет, ведущий не знает, работает кодер или давно закончил ход и стоит. Всё как в жизни и буднях руководителя разработки.
Отсюда соблазн «зайти проверить». Но ход ведущего стоит столько, сколько весит его контекст. В одной пачке задач до супервизора мой ведущий тратил 2,18M входных токенов на одно пробуждение. Почти всё это чтение кэша, но платишь всё равно.
Вторая беда: доставка. SendMessage возвращал queued, и на ранних сборках такое сообщение могло потеряться. Однажды рецензент, занятый задачей #3, получил запрос по #2, ответил только по #3 и закончил ход; второго запроса в его записи нет вовсе. Ведущий становился почтальоном и пересылал письма руками, а каждая пересылка становилась ещё одним ходом с полным контекстом.
Третья: память. Ведущий, который сам читает диффы и отчёты, раздувается контекстом, а после сжатия контекста забывает, кто чем занят.
2. Что я пробовал и откуда взялся supertick
-
Ждать внутри хода: sleep или опрос в цикле. Модель держит ход, и каждый круг инструментов снова оплачивает контекст.
-
Полагаться только на сообщения. Молчание неотличимо от смерти, потерянное
queuedозначает зависший прогон. -
Держать задачи во встроенных
TaskCreateиTaskList. Они есть не у всех моделей (на Opus 5 по умолчанию их нет) и пропадают при смене модели.
Отдельная история: сам командный режим Claude Code. В феврале 2026 года, в сборке 2.1.32 вместе с Opus 4.6, Anthropic выпустила agent teams как research preview: режим включался переменной CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1, команду создавал инструмент TeamCreate, а убирал TeamDelete. Я начинал с него, и, как я помню, первое время всё работало. По публичному changelog TeamCreate и TeamDelete убрали в сборке 2.1.178 (16.06.2026). В бинаре Claude Code эти имена теперь стоят в списке «ожидаемо отсутствующих»: так обрабатываются убранные инструменты, если они попадаются в истории старого разговора. Мои записи начинаются позже: 15 сентября, в командном прогоне по задаче, TeamCreate и TaskCreate уже не было (сборку я тогда не записал); 17 сентября на сборке расширения 2.1.272 и 18 сентября на 2.1.274 то же самое, а team_name помечен устаревшим: «одна неявная команда на сессию». Записи о работающем TeamCreate у меня нет, так что честно могу сказать одно: на сборках 2.1.272 и новее TeamCreate и TeamDelete нет, команда неявная, а участники представляют собой фоновых агентов с именами.
С задачами другая история: TaskCreate, TaskGet, TaskUpdate и TaskList остались, но зависят от модели. Они включены только для фиксированного списка старых моделей (Claude 3.x, Opus 4.0–4.7, Sonnet 4.0–4.6, Haiku 4.5), для фоновых сессий задач или когда задана переменная CLAUDE_CODE_ENABLE_TODO_TOOLS. На Opus 5 они у меня пропали и возвращались только этой переменной или старой моделью. Урок я вынес такой: чем меньше команда зависит от того, какие инструменты Claude Code покажет модели в следующей сборке, тем спокойнее. Поэтому supertick опирается только на Agent (с параметром name), SendMessage, ListAgents и TaskStop, а задачи держит в PLAN.md.
Переменная CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1 плагину не нужна, и он её не упоминает. Я проверил на CLI 2.1.308 (расширение VS Code 2.1.304): чистая сессия без пользовательских настроек и без переменной видит те же Agent, ListAgents, SendMessage и TaskStop, что и с ней; TeamCreate нет ни там, ни там. Чтобы не останавливаться на видимости инструментов, 22.10.2026 я отдельно прогнал SIMPLE без этой переменной (supertick отработал и без неё). Поведение плагина я исследовал начиная со сборки 2.1.274 и до 2.1.308.
Дальше я работал на готовом плагине agent-teams от izmailovilya (он лежит в репозитории с несколькими плагинами, в папке plugins/agent-teams: https://github.com/izmailovilya/ilia-izmailov-plugins) и сначала коммитил свои улучшения и правки прямо в него. Параллельно искал готовое решение среди существующих плагинов, которое закрыло бы все три беды сразу. Кроме agent-teams, разбирал porch (pragmatic-orchestration, https://github.com/CodeAlive-AI/pragmatic-orchestration): там я тоже изучил реализацию и идеального решения не увидел.
Ни там, ни там готового ответа я не нашёл, а своих правок становилось всё больше, и так выросла идея своего плагина. Как это выглядело по порядку:
-
Решил посчитать, сколько стоит командный режим
Разобрал расходы на agent-teams. Ведущий сам пересылал каждое письмо участника и платил за это всем выросшим контекстом: одна пересылка при 437k стоила $0,38 по ценам API. Ходы уходили на опрос «есть что новое?», а участников, которые умерли на лимите API (429), я находил руками. В подписке есть лимиты на токены в окнах по несколько часов, так что экономить тут тоже выгодно.
-
Начал искать варианты. Supervisor Tick в форке agent-teams
Проверял гипотезу нового ядра. Ведущий спит на фоновом скрипте; скрипт без модели каждые 20 секунд читает файлы прогона (карточки участников, почту, план, маркеры движков) и будит ведущего, только когда есть работа. Готовую задачу принимает одноразовый проверяющий по диффу, ведущий код не читает. Это ядро будущего supertick.
-
После испытаний своих идей родился свой плагин
Идеального готового решения я так и не нашёл (ни в agent-teams, ни в porch) и решил делать свой плагин: публичный репозиторий (https://github.com/denizen24/supertick) под MIT с новой архитектурой на новом фундаменте.
-
Испытания и релиз 1.0.0
Перед ним шли три пробных прогона на коде самого плагина: SIMPLE за 24 минуты; «MEDIUM», который сам себя оценил как COMPLEX, за 2 ч 06 мин; доводочный прогон за 77 минут.
3. Что такое supertick
Это плагин для Claude Code с одной главной командой, /supertick:team-feature. Вы описываете фичу или даёте файл плана. Ведущий раскладывает работу на задачи, оценивает сложность по механическому правилу и собирает команду под неё.
|
Сложность |
Кто работает |
|---|---|
|
SIMPLE |
ведущий, кодеры, рецензент |
|
MEDIUM |
то же плюс техлид и проверщики рисков |
|
COMPLEX |
то же плюс три архитектора (frontend, backend, systems): спорят о плане раундами и уходят до первого кодера |
Правило сложности без торга: шесть признаков MEDIUM (два слоя и больше, меняется существующая логика, рядом вход, оплата или права, три задачи и больше, есть блокирующая задача, пять файлов кода и больше). 0–1 признак: SIMPLE, 4 и больше: сразу COMPLEX, при 2–3 проверяются ещё семь признаков COMPLEX.
Каждая задача проходит одни и те же ворота: самопроверка кодера, одно ревью unified-reviewer (безопасность, логика, соответствие плану, качество), приёмка разовым проверяющим по диффу. В конце идут сверка задач между собой, сборка и тесты, браузер, если нужен, разбор оставленного старого кода и список ручных проверок для человека.
|
Навыки |
|
|
|
Агенты |
|
|
|
Скрипты |
|
|
|
Зависимости |
Claude Code, bash, python3 (только стандартная библиотека), git |
|
4. Как устроен supertick
Сердцем плагина служит цикл событий вне модели. Два скрипта, ни одного обращения к модели. Ведущий запускает supervisor-wait.sh фоновым вызовом и заканчивает ход. Скрипт раз в 20 секунд гоняет supervisor-tick.py по файлам прогона и завершается, только когда появилось действие уровня P1 или выше (порог задаёт --wake-on) или истёк --max (по умолчанию час). Завершение фонового вызова и есть пробуждение ведущего. Пока цикл крутится, токены не тратятся.
Отсюда и «Event Loop» в заголовке, хотя сравнение неточное. Принцип тот же: ведущий не крутится в ожидании внутри модели, а дешёвый цикл без модели следит за файлами (почтой, карточками, планом, маркерами движков) и отдаёт управление ведущему только на событие уровня P1 и выше. Но настоящих подписок на события тут нет: цикл сам опрашивает файлы раз в 20 секунд, то есть это принципы event loop, сделанные на поллинге.
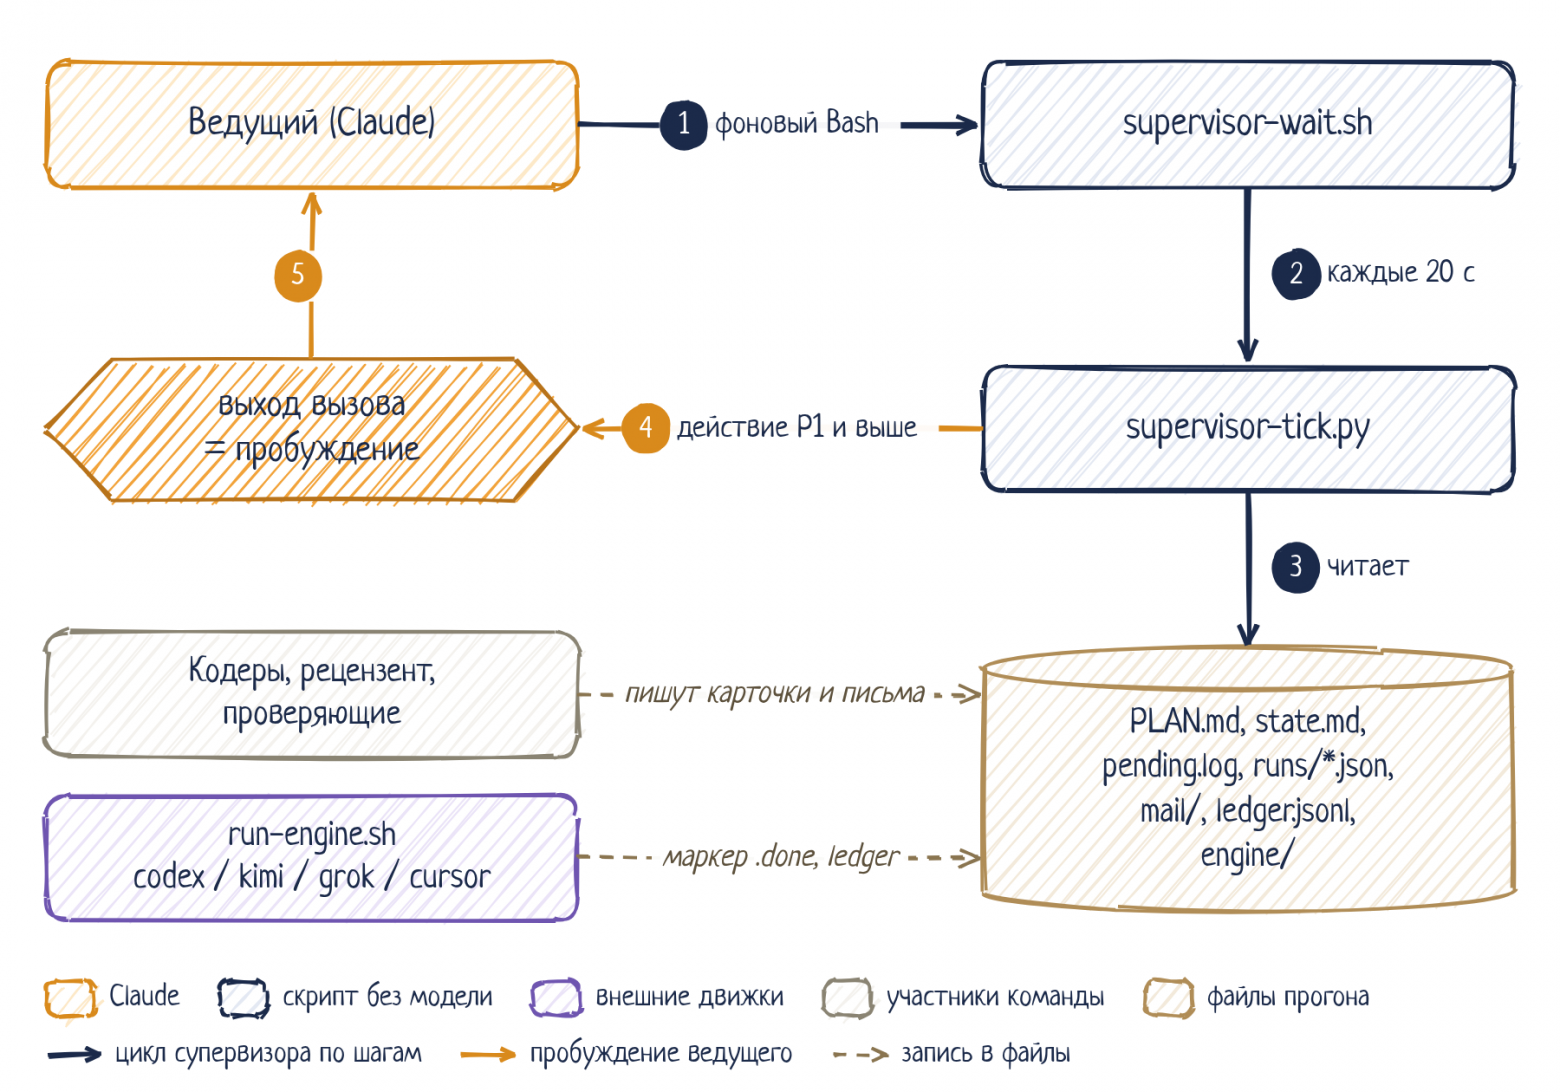
Тик печатает список действий с приоритетами и кладёт снимок в state/supervisor.json. Проснувшись, ведущий читает десяток строк и делает ровно названное, начиная с высшего приоритета. Закрытое письмо отмечается supervisor-tick.py ack, задача закрывается статусом в PLAN.md.
|
Приоритет |
Что будит |
|---|---|
|
P0 |
копия QUEUED не доставлена 2 минуты; письмо 2 минуты лежит в ящике невзятым; STUCK или ENGINE_DOWN; процесс движка умер без маркера; ответ движка никто не забрал; участник молчит два интервала надзора без правок в файлах задачи |
|
P1 |
кодер прислал DONE, а приёмка не начата; отчёт приёмки готов; вопрос, эскалация или SENSITIVE без ответа; участник за 3 минуты после старта не подал признаков жизни |
|
P2–P3 |
первые 60 секунд тишины; плановая контрольная точка; участник гоняет pytest или jest (busy вместо ложного P0) |
|
P4 |
ok, тихо: спать дальше |
Почта идёт файлами. Одно письмо лежит в одном файле mail/<кому>/<время>_<от кого>_<KIND>[_task<id>].md с шапкой from:/kind:/task:/ts:. Так писать могут и роли без Bash (рецензенту хватает Write), и никто не портит чужие строки. Ответ, которого кто-то ждёт (вердикт ревью, ответ ведущего на вопрос), сначала ложится файлом, потом уходит сообщением. Ждущий кодер ловит файл в переднем плане:
team-mail.sh <RUN DIR> coder-<N> lead ANSWER task <id> -- "<ответ>"
team-wait.sh <RUN DIR> coder-<N> --task <id> --max 540
Если сообщение всё же вернулось queued, отправитель шлёт ведущему копию, а ведущий дописывает строку в pending.log. Формат служит интерфейсом тика: время в начале, хвост | OPEN в конце.
14:05 coder-2 -> unified-reviewer | REVIEW: task #2. Files: src/a.py | OPENDONE считается кандидатом, а не результатом. Задачу закрывает не кодер и не ведущий, а одноразовый проверяющий: он видит только раздел задачи и дифф её коммитов и проходит каждый критерий приёмки по очереди. Ведущий код не читает, он видит одну строку ACCEPT: task #N — PASS или FAIL.
Всё на диске. План, состояние, письма, карточки участников, отчёты ревью и приёмки лежат в .claude/teams/feature-<имя>/ и не удаляются после прогона. После сжатия контекста ведущий восстанавливается по этим файлам и одному тику, без переписки с участниками.
Признак жизни участник подаёт сам: первой командой идёт run-state.py set … status=running. Чего тик не видит, так это смерти Claude-участника: у того нет процесса и маркера. Поэтому на каждом пробуждении по P0 ведущий сверяет состав со списком агентов.
5. Установка и первый прогон
Репозиторий сам является маркетплейсом: в корне лежит .claude-plugin/marketplace.json, так что никаких сторонних каталогов не нужно. Добавляете его один раз и ставите плагин по имени supertick@supertick (имя плагина @ имя маркетплейса):
# из терминала
claude plugin marketplace add denizen24/supertick
claude plugin install supertick@supertick

# или то же самое внутри сессии Claude Code
/plugin marketplace add denizen24/supertick
/plugin install supertick@supertick
# одной командой (Claude Code 2.1.292 и новее)
claude plugin install supertick --marketplace denizen24/supertick
# обновиться после нового релиза
claude plugin update supertick@supertickПосле установки перезапустите сессию Claude Code: навыки и агенты подхватываются при старте. Обновление ставится, только если в манифесте вырос номер version. Проверить, что тик запускается:
root="$(ls -d ~/.claude/plugins/cache/*/supertick/* | sort -V | tail -1)"
mkdir -p /tmp/supertick-smoke
python3 "$root/scripts/supervisor-tick.py" /tmp/supertick-smoke
# P4 ok: тихо: событий, требующих ведущего, нет
Тесты в клоне репозитория (первая команда на чистом клоне даёт 50 тестов, OK):
cd plugins/supertick && python3 -m unittest discover -s scripts/tests   # 50 тестов тика и скриптов
cd ../.. && python3 -m unittest discover -s tools/tests                 # контракты форматов
Дальше в корне git-репозитория своего проекта:
/supertick:team-feature добавить экспорт отчёта в CSV на странице заказов-
Карта маршрута
Ведущий печатает путь и ищет корень плагина. Спрашивает только о том, что видит человек: бриф плана на MEDIUM и COMPLEX, развилки дизайна, чистку старого кода, ручные проверки.
-
Лента в чате
Решения, риски, задачи на ревью и приёмке, готовые задачи со счётчиком
{done}/{total}, застревания. Её можно перебить в любой момент. -
Каталог прогона
PLAN.md,state.md,VERIFICATION_PLAN.md,reports/,mail/,runs/дают единственный ответ на «что сейчас происходит». -
Итог
VERIFICATION_REPORT.mdи нумерованный список ручных проверок с командами и признаками успеха.
Флаги: --coders=N (по умолчанию 5), --no-research, --engines=off, --complexity=simple|medium|complex. Если задача сырая, начните с /supertick:interviewed-team-feature: короткий разговор, бриф в .briefs/, затем тот же прогон. /supertick:conventions один раз собирает .conventions/ с эталонами, которые ведущий вкладывает в промпт каждого кодера. Коммиты делают кодеры, каждый только своих путей; ведущий код не правит и не коммитит.
6. Как это выглядит на живой задаче
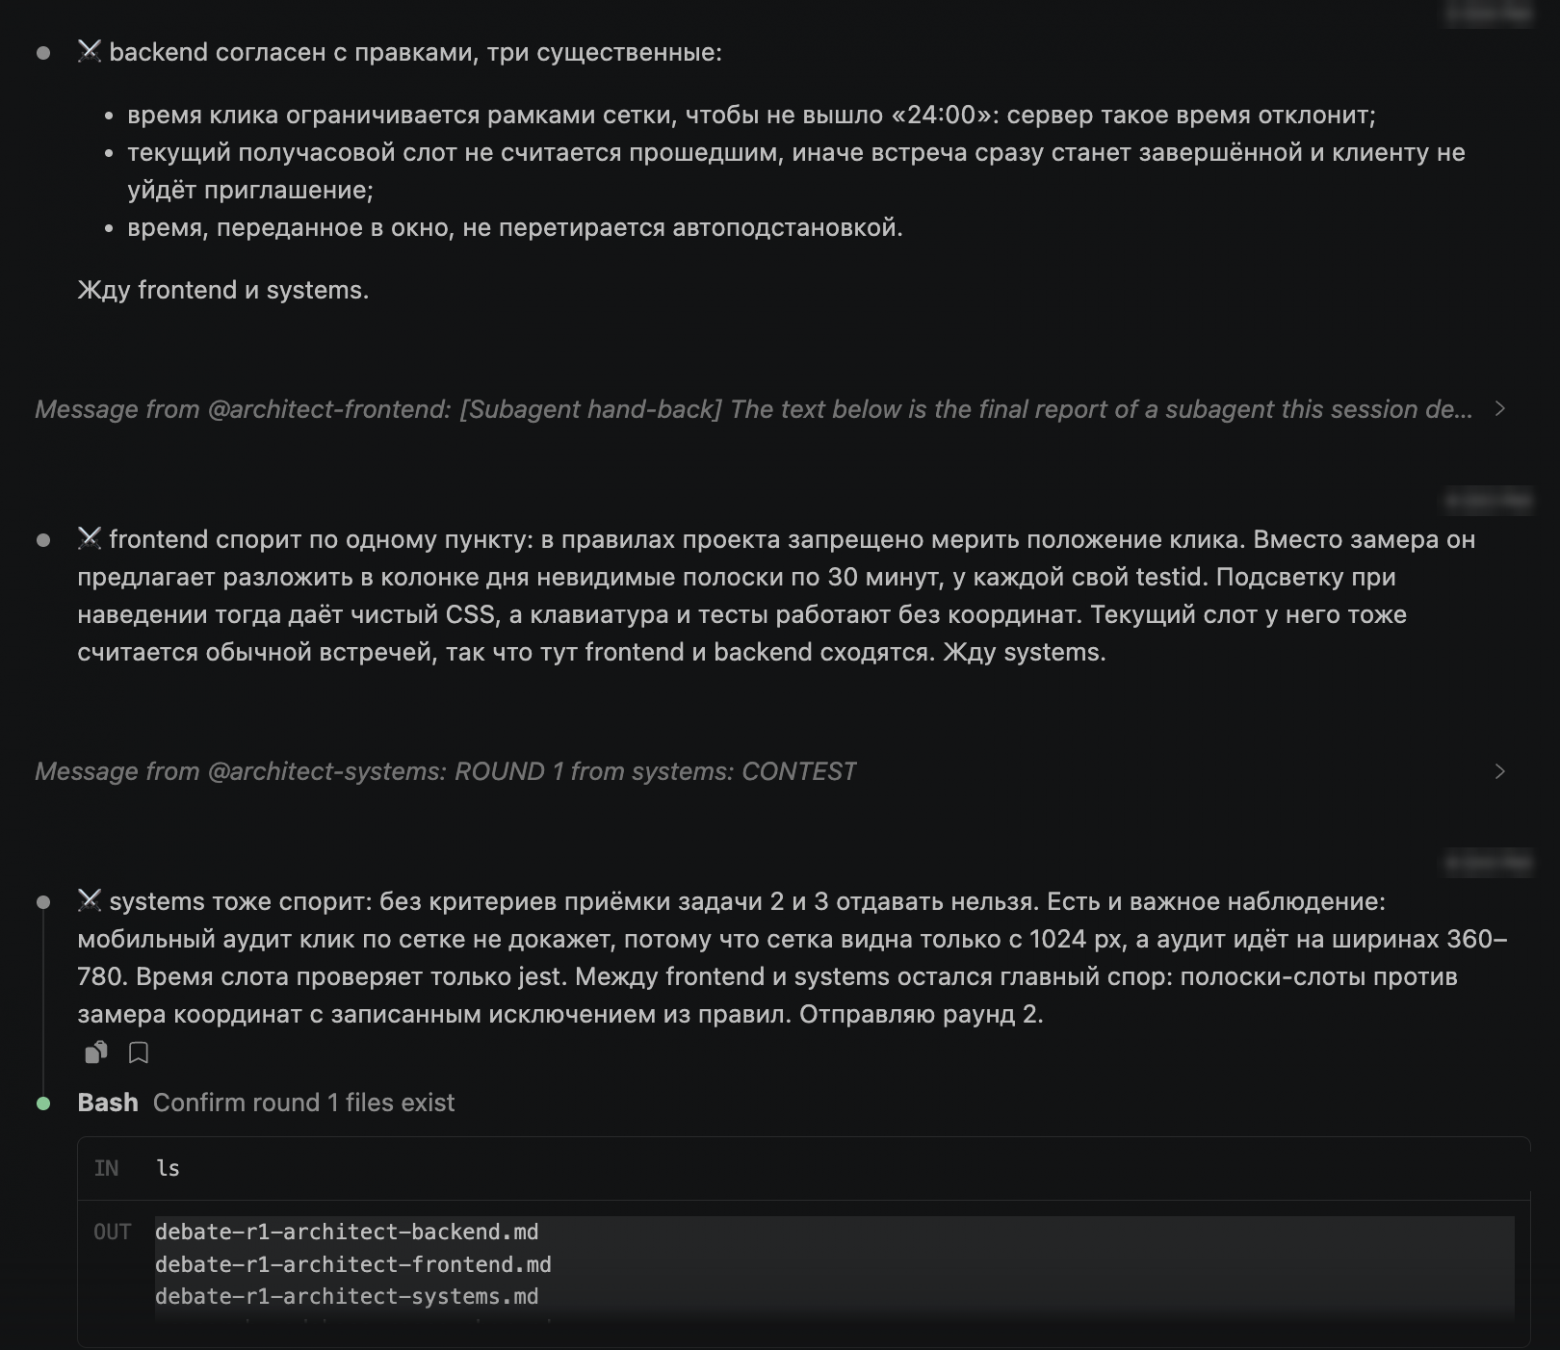
В качестве примера разберём продуктовую задачу: клик по пустому месту календаря должен открывать окно новой встречи с уже подставленным временем. Задача вышла COMPLEX: три архитектора и пять риск-тестеров, так что в ленте видны почти все роли. Ниже идут шесть скриншотов по порядку, с тем, что на них происходит.
Дебат архитекторов, раунд 1. Backend согласен с планом и приносит три существенные правки: время клика ограничить рамками сетки, чтобы не вышло «24:00», которое сервер отклонит; текущий получасовой слот не считать прошедшим, иначе встреча сразу станет завершённой и клиенту не уйдёт приглашение; время, переданное в окно, не должна перетирать автоподстановка. Frontend спорит: правила проекта запрещают мерить положение клика, поэтому он предлагает разложить в колонке дня невидимые полоски по 30 минут со своим testid у каждой. Тогда подсветку даёт чистый CSS, а клавиатура и тесты работают без координат. Systems спорит с другой стороны: без критериев приёмки задачи 2 и 3 отдавать нельзя, а мобильный аудит клик по сетке не докажет: сетка видна только с 1024 px, а аудит идёт на узких экранах. Главный спор остаётся между frontend и systems: полоски-слоты против замера координат с записанным исключением из правил, и ведущий отправляет раунд 2. Заметьте, что сам ведущий при этом только проверяет, что в reports/ легли три файла раунда: ответ субагента сначала сохраняется на диск.
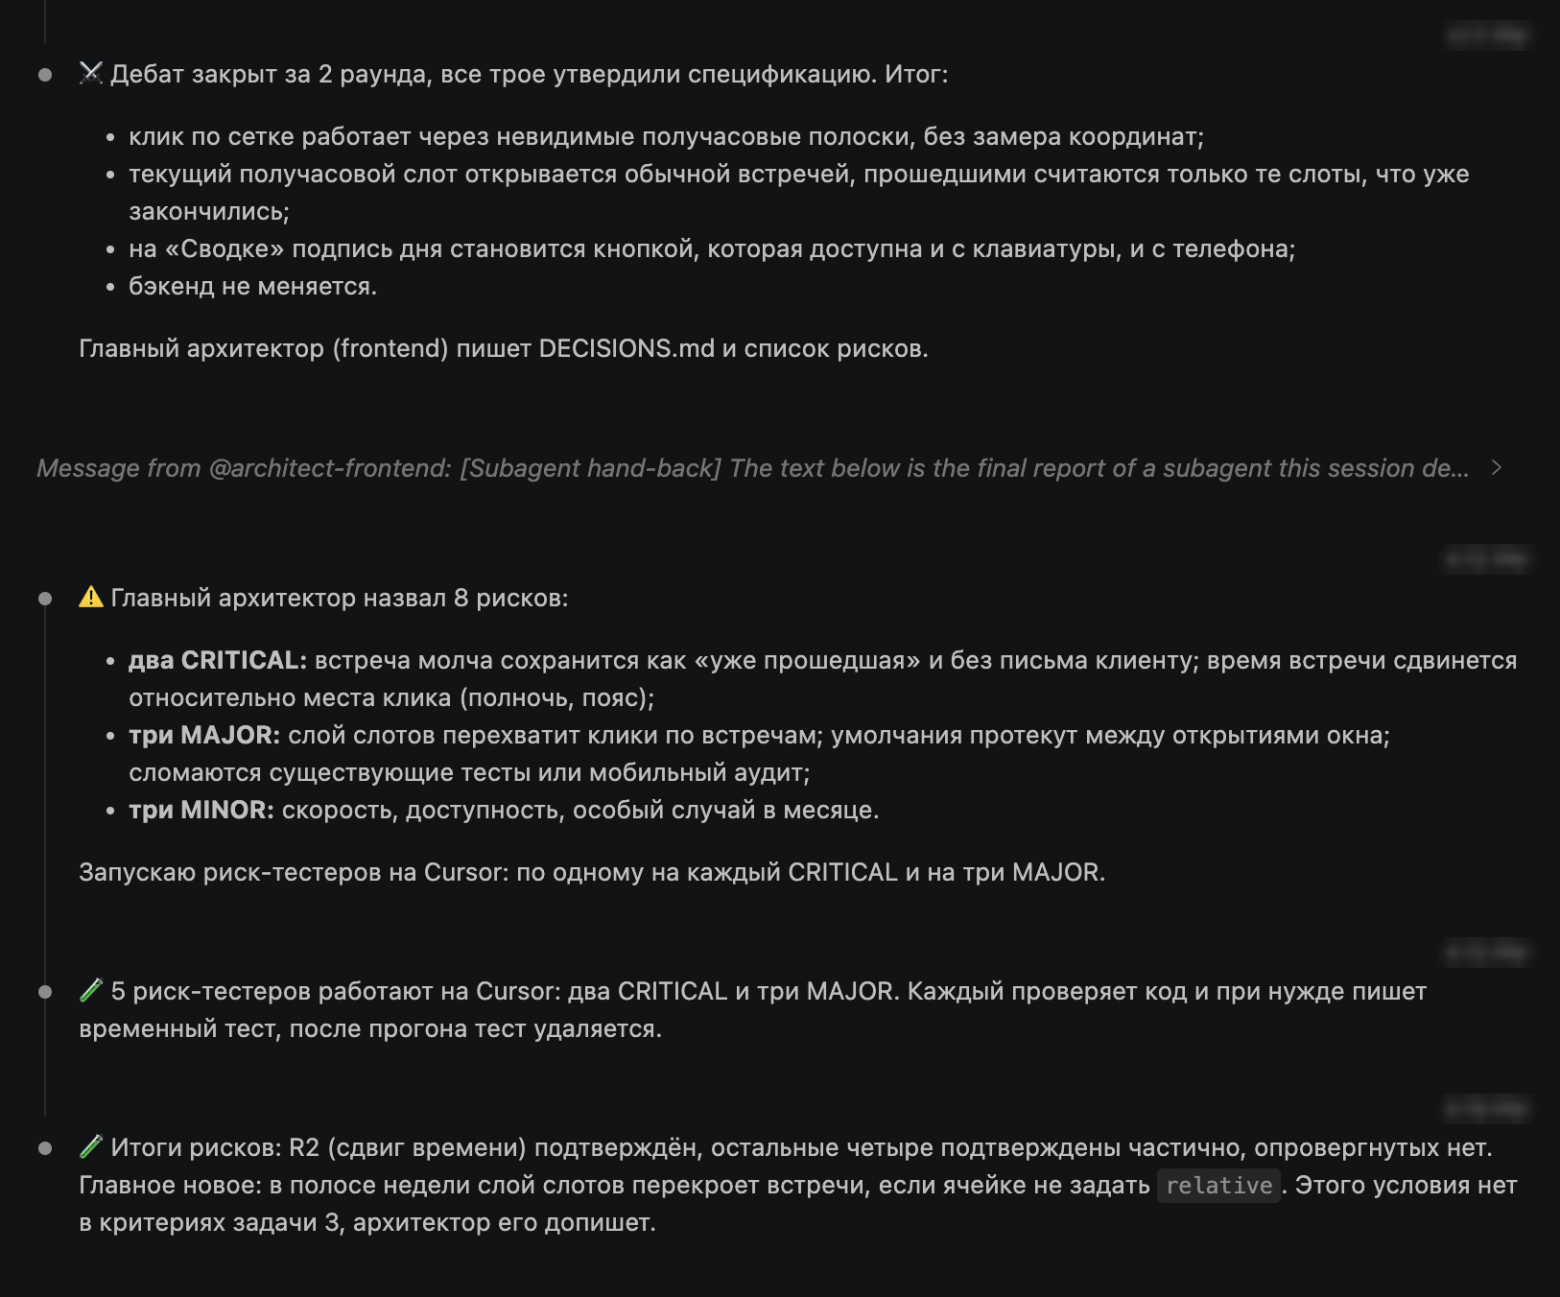
Дебат закрыт за два раунда, все трое утвердили спецификацию: клик идёт через невидимые получасовые полоски без замера координат, текущий слот открывается обычной встречей, подпись дня на главной сводке становится кнопкой, бэкенд не меняется. Главный архитектор (здесь это frontend) пишет DECISIONS.md и список из 8 рисков: два CRITICAL (встреча молча сохранится как «уже прошедшая» и без письма клиенту; время встречи сдвинется относительно места клика из-за полуночи или часового пояса), три MAJOR (слой слотов перехватит клики по встречам; умолчания протекут между открытиями окна; сломаются существующие тесты или мобильный аудит) и три MINOR.
На каждый CRITICAL и MAJOR ведущий запускает по риск-тестеру на Cursor, пять штук. Каждый смотрит код и при нужде пишет временный тест, который после прогона удаляется. Итог: сдвиг времени подтверждён, остальные четыре подтверждены частично, опровергнутых нет. И находка, которой не было в списке: в полосе недели слой слотов перекроет встречи, если ячейке не задать relative. В критериях задачи 3 этого условия не было, архитектор его дописал. По меткам в ленте риск-тестеры отработали примерно за шесть минут.
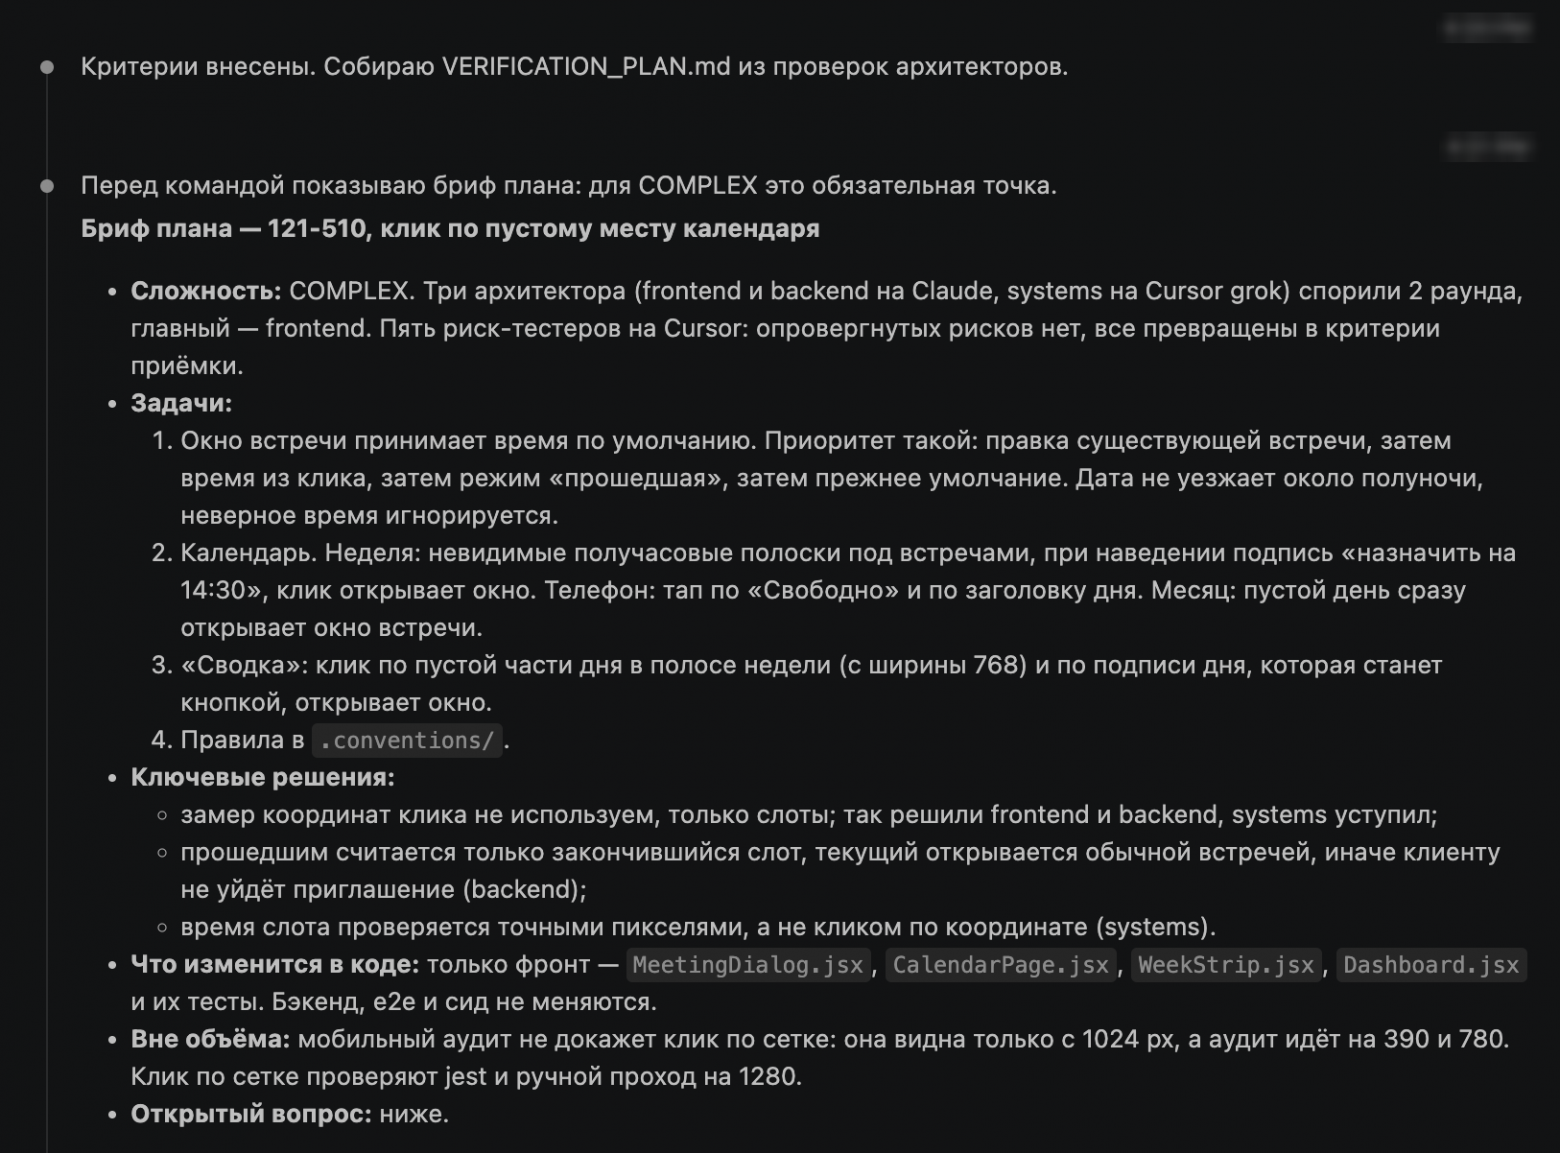
Дальше ведущий собирает VERIFICATION_PLAN.md из проверок архитекторов и показывает мне бриф плана (для COMPLEX это обязательная точка). В брифе видно, кто на чём работал: frontend и backend на Claude, systems на Cursor (grok). Задач четыре: окно встречи принимает время по умолчанию с явным порядком приоритетов; календарь (неделя, телефон, месяц); главная сводка; правила в .conventions/. Ключевые решения записаны вместе с тем, чьи они: слоты вместо замера координат решили frontend и backend, systems уступил. Меняется только фронт, четыре компонента и их тесты. Отдельной строкой перечислено, что вне объёма: мобильный аудит клик по сетке не проверит, его проверят jest и ручной проход на 1280 px.
После кодовых задач идёт сверка задач между собой. Расхождений нет: правило «прошло» одинаковое на обеих страницах, окно встречи открывается из одной точки, имена testid не пересекаются, правка встречи не наследует режим «прошедшая». Ведущий сохраняет отчёт и ставит в PLAN.md задачу конвенций. По воротам плагина она идёт после коммита всех кодовых задач и до проверяющих:
## Task 4: Обновить .conventions/
Status: IN_PROGRESS(coder-9)
Blocked by: фаза 3 (после коммита всех кодовых задач)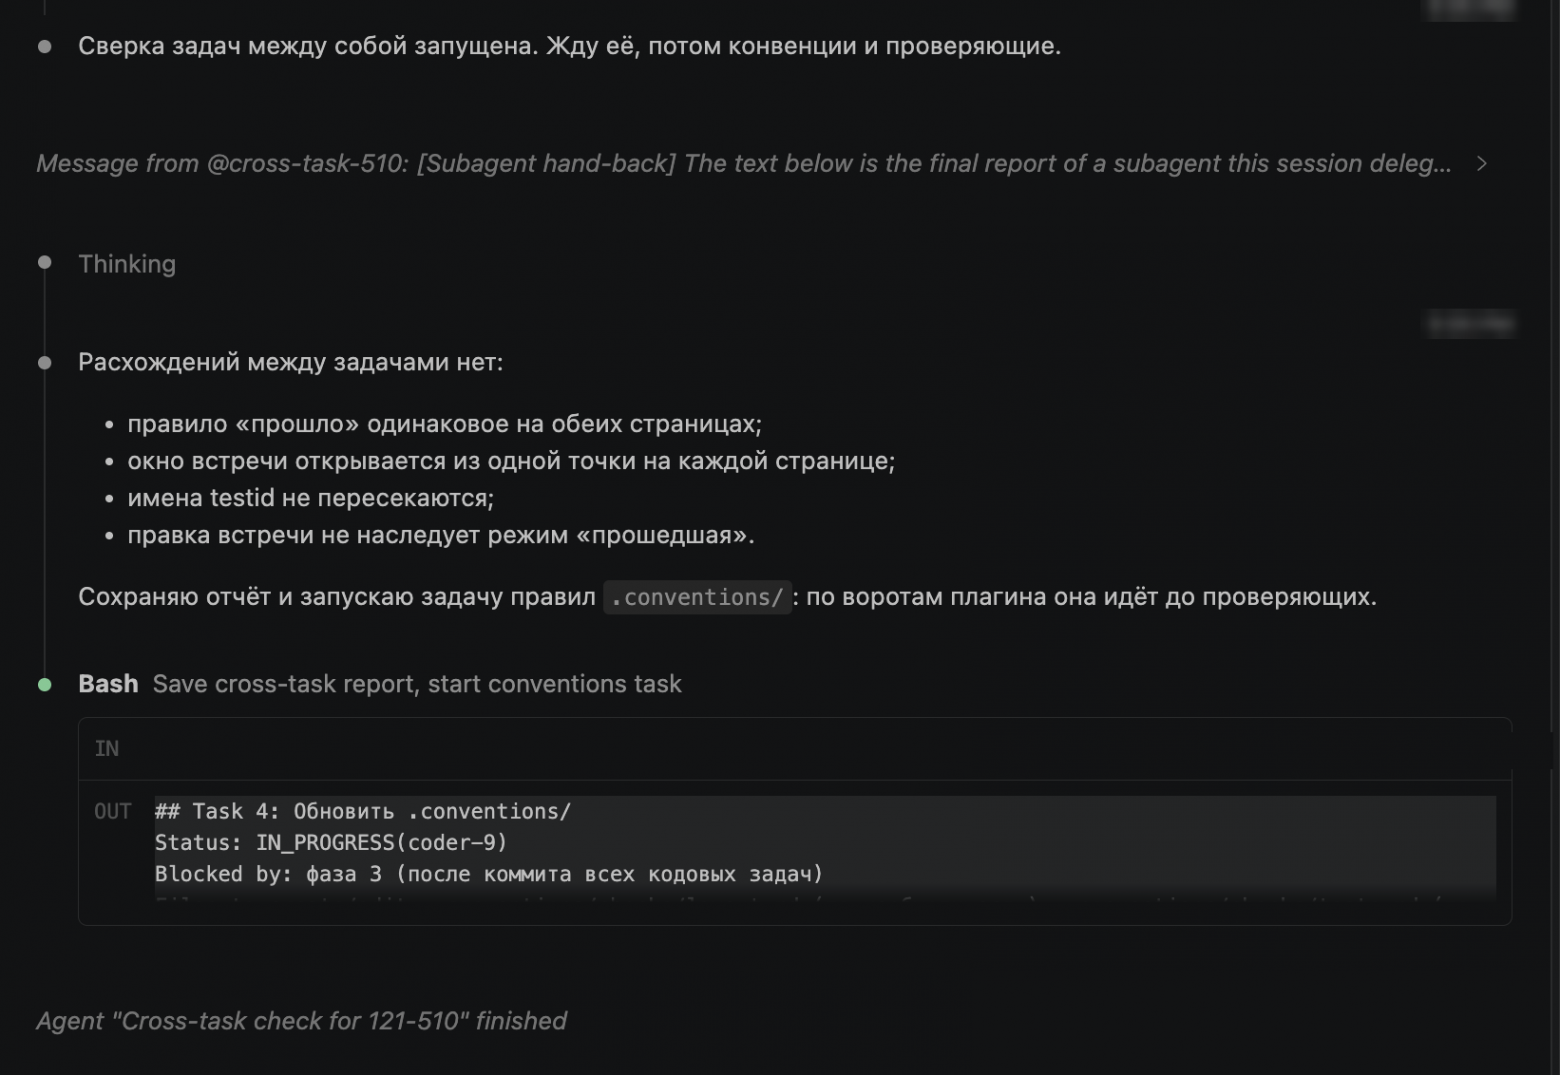
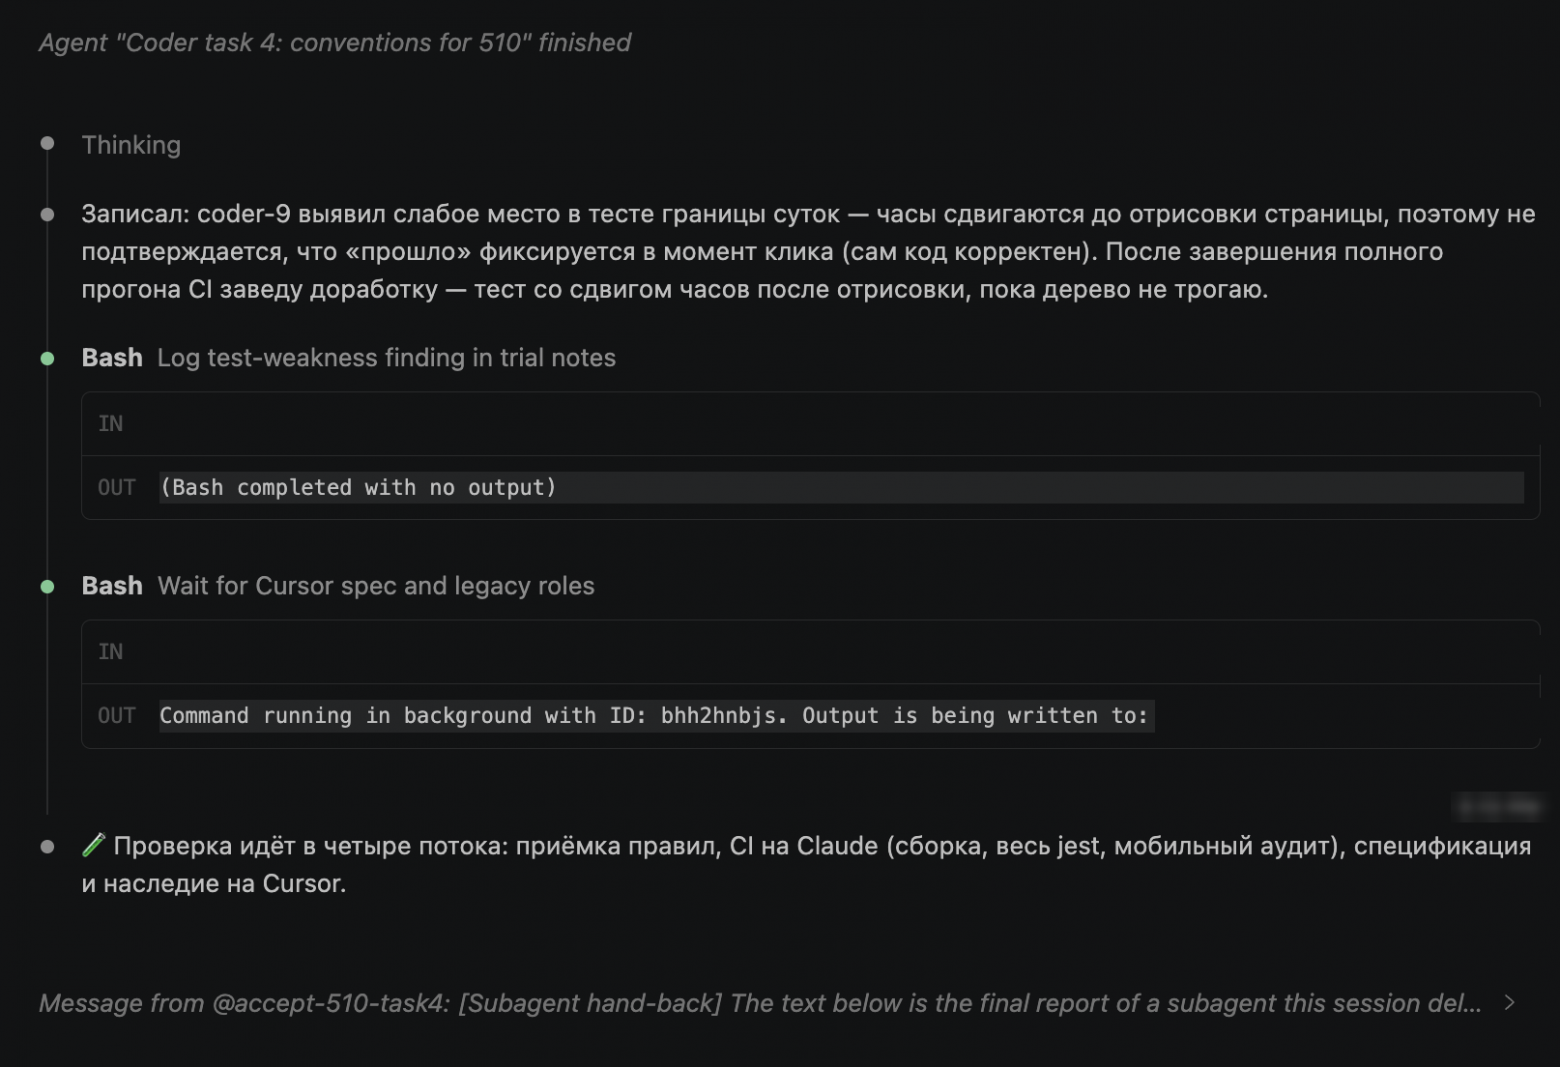
Кодер задачи конвенций заметил слабое место в чужом тесте границы суток: часы сдвигаются до отрисовки страницы, поэтому тест не подтверждает, что «прошло» фиксируется в момент клика. Сам код при этом корректен. И вот тут видно, зачем ведущему запрещено самому править код: он не лезет в дерево, а записывает находку и планирует доработку (тест со сдвигом часов после отрисовки) на потом, когда закончится полный прогон CI. Проверка идёт в четыре потока: приёмка правил, CI на Claude (сборка, весь jest, мобильный аудит), спецификация и наследие на Cursor. Ответов Cursor ведущий ждёт фоновым вызовом, который смотрит на маркеры в engine/.
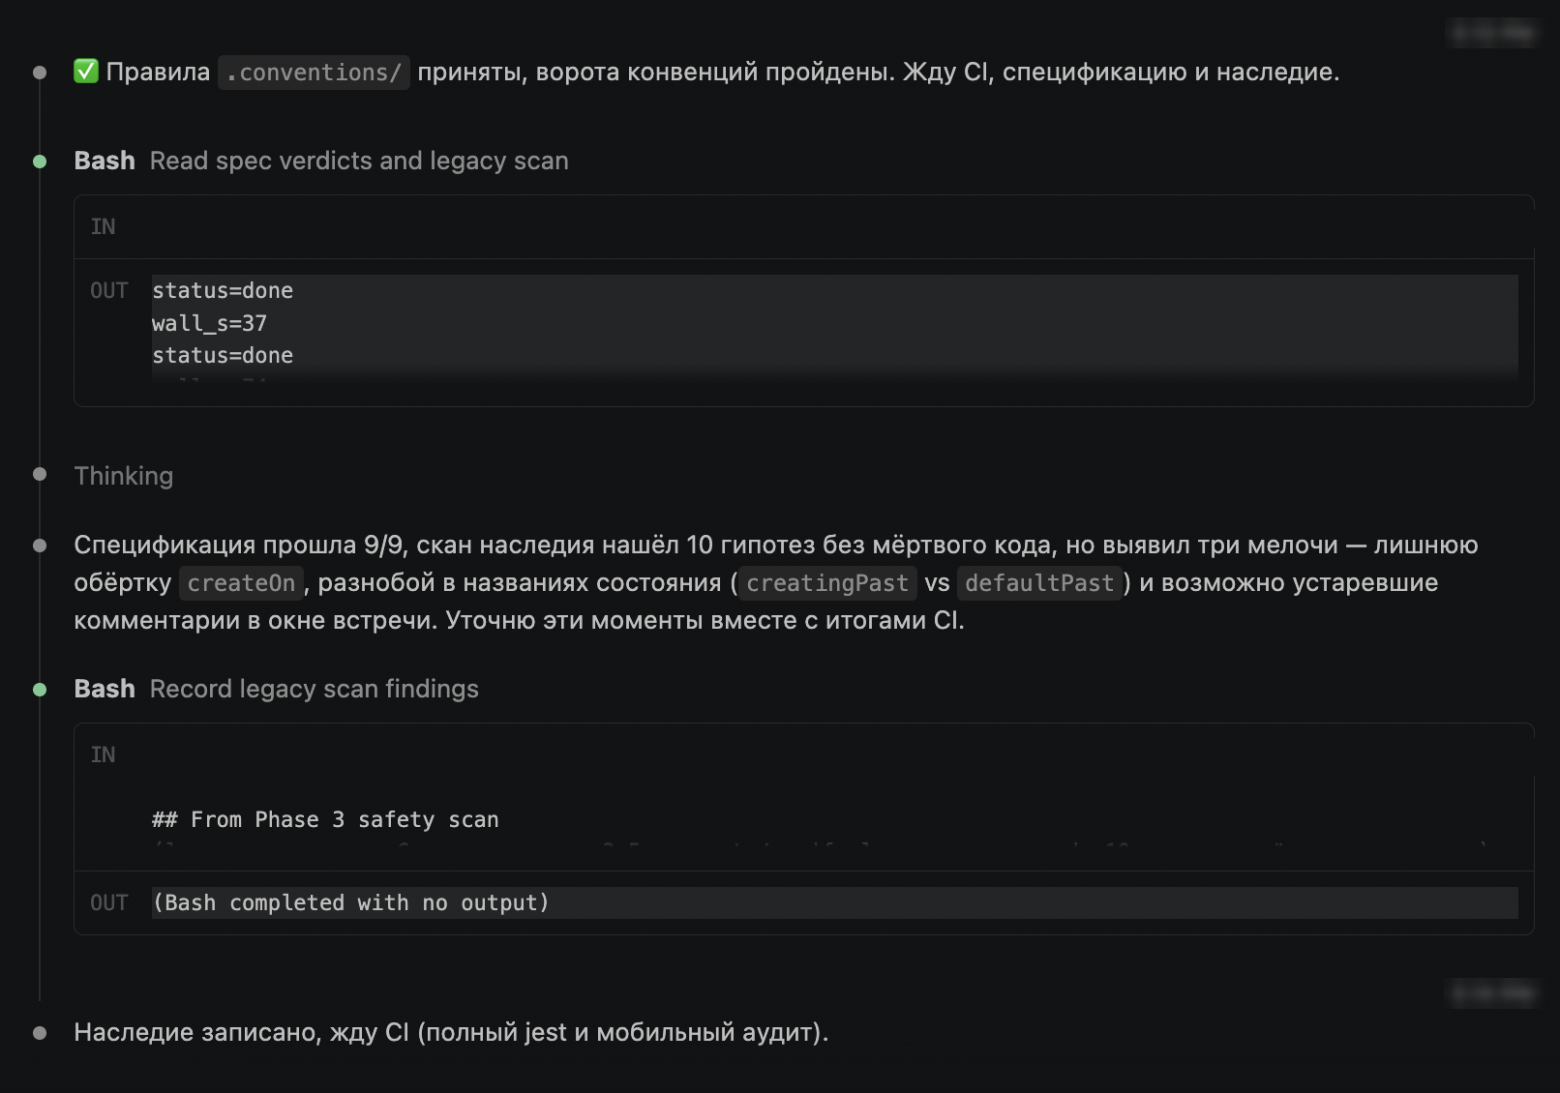
Задача конвенций принята. Спецификация прошла 9 из 9. Скан наследия проверил 10 гипотез и мёртвого кода не нашёл, но назвал три мелочи: лишнюю обёртку createOn, разнобой в названиях состояния (creatingPast и defaultPast) и, возможно, устаревшие комментарии в окне встречи. Находки записаны в отчёт о наследии; спрашивать меня про чистку ведущий будет вместе с итогами CI, а пока ждёт полный jest и мобильный аудит.
Чем кончилось: фича уехала в прод в новом релизе. Сама команда работала около 2 часов 20 минут.
Что мне здесь важно: спор архитекторов и риск-тестеры нашли две вещи (приглашение клиенту и relative у ячейки), которые я бы при ручной постановке задачи скорее всего не написал в критериях. И обе попали в критерии приёмки до того, как первый кодер написал строку кода.
7. Сколько это стоит на живых задачах
Давайте посчитаем стоимость на двух прогонах. В первом прогоне две мелкие карточки: ссылки на тарифы должны прокручивать страницу к блоку тарифов, и нестабильный тест воркера. Оценка сложности дала MEDIUM, SIMPLE я выставил вручную. Второй прогон взял календарь из прошлого раздела: три архитектора, пять риск-тестеров.
Время и Claude
|
|
Прогон 1, SIMPLE |
Прогон 2, COMPLEX |
|---|---|---|
|
Работа команды |
56 мин, из них 17 мин ушло на полный pytest |
2 ч 20 мин; по часам 5 ч, 2,5 ч ждали моих ответов |
|
Субагенты Claude |
16: 6 Opus 5.5, 10 Sonnet 5.5 |
20: 10 Opus 5.5, 10 Sonnet 5.5 |
|
Ведущий (Opus 5.5): чтение / запись кэша / выход |
31,7M / 0,33M / 0,10M |
68,6M / 0,63M / 0,12M |
|
Субагенты: чтение / запись кэша |
7,3M / 0,71M |
25,0M / 1,94M |
|
Claude, по ценам API |
$17: ведущий $11, команда $6 |
$39: ведущий $21, команда $18 |
Время и деньги округлены. Деньги даны как оценка по ценам API: Opus 5.5 ($4 вход, $20 выход, $0,20 чтение кэша за 1M токенов); Sonnet 5.5 ($2, $10, $0,20); запись кэша посчитана как часовой кэш, вдвое дороже входа. Цены API взяты как общая линейка, чтобы прогоны можно было сравнивать. На подписке счёт другой, но суть та же: если не экономить токены, в лимиты упираешься раньше.
Источники: журналы ведущего и субагентов, ответы Cursor в engine/*/NNN.out, метки времени.
Вызовы Cursor
|
Модель |
Роли |
Вызовов |
Вход / выход / кэш |
Время |
|---|---|---|---|---|
|
composer-2.5, прогон 1 |
2 разведчика, 2 прокси-кодера, проверка спецификации, скан наследия |
6 |
0,22M / 0,03M / 1,87M |
7,6 мин |
|
composer-2.5, прогон 2 |
2 разведчика, 5 риск-тестеров, проверка спецификации, скан наследия |
9 |
0,52M / 0,08M / 5,43M |
24 мин |
|
grok-4.7-xhigh-fast, прогон 2 |
архитектор systems: 2 раунда дебата и бриф для рецензента |
3 |
0,20M / 0,05M / 4,17M |
10 мин |
|
gpt-5.6-sol-high, оба |
второе мнение рецензенту |
0 |
— |
— |
Cursor в долларах я не считаю: он у меня по подписке, а надёжных цен за токен для composer-2.5 и grok нет. Поэтому здесь токены и время работы движка. Почему GPT не вызывался ни разу, об этом в разделе 9.
Почему эти цифры не стоит сравнивать в лоб
-
Ведущий второго прогона переплатил: это была та же сессия сразу после первого, с чужой историей. Почти все его деньги ушли на чтение кэша, $13,7 из $21. Честнее сравнивать вклад команды: $6 против $18.
-
Ведущий оказался самой дорогой ролью: больше половины счёта в обоих прогонах, хотя код он не читает. Именно эту часть и сокращает супервизор.
-
Выход субагентов в журналах занижен: кодер написал около 270 строк, а в журнале у него 2k выходных токенов. Основные деньги здесь уходят на чтение кэша, так что поправка составит несколько долларов.
-
Если Claude Code у вас по подписке, суммы даны как эквивалент по ценам API, а не то, что с вас спишут.
8. Внешние движки
Без конфига всё работает на Claude. Любую роль можно отдать внешнему CLI через ~/.claude/agent-teams.json:
{
  "fallback": "claude",
  "roles": {
    "codebase-researcher": "codex",
    "second-reviewer": { "engine": "cursor", "model": "gpt-5.6-sol-high" }
  }
}-
Пресеты есть для codex, kimi, grok и cursor (
cursor-agent). Если в системе нет бинарника, роль тихо уходит на Claude. -
Каждый запуск идёт через
run-engine.sh: процесс отцепляется, ответ ложится вengine/<роль>/, маркер.doneпишется последним, события пишутся вledger.jsonl. Ждать нужно маркер, а не таймер, поэтому ответ переживает даже перезапуск сессии. -
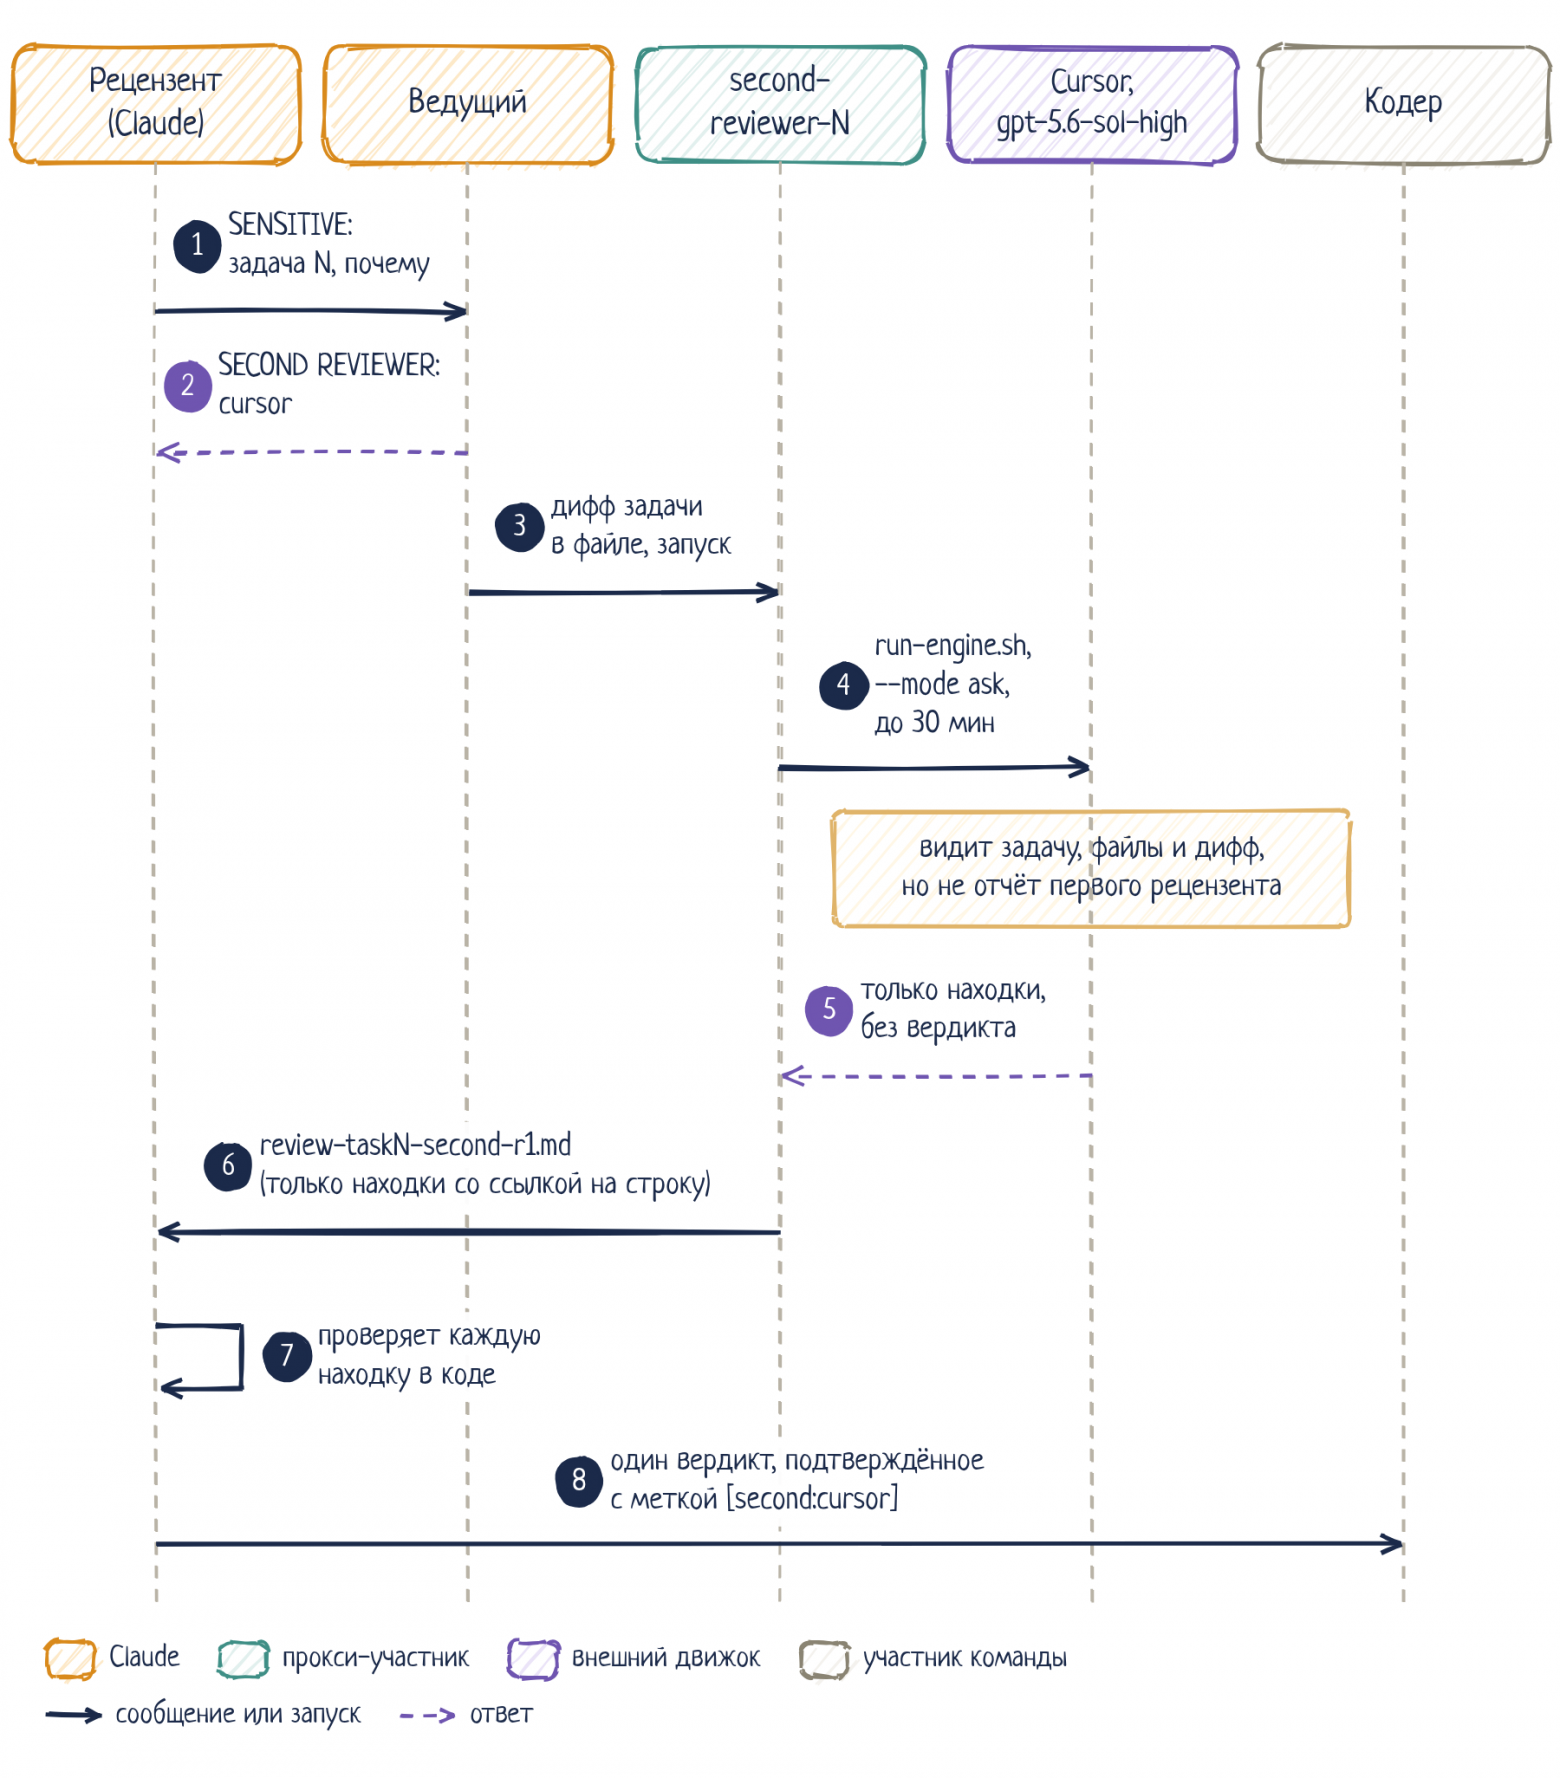
second-reviewer: второе мнение по задачам, которые рецензент объявил SENSITIVE (вход, деньги, миграции); только если его движок отличается от движка рецензента. Подробнее об этом в следующем разделе. -
Приёмщик всегда на Claude: движку в режиме чтения не запустить тесты задачи, и приёмка вышла бы ложной.
-
Голос движка совещательный: одобрение отклонений, арбитраж ревью, варианты дизайна и удаление кода остаются за Claude-ролями.
Мне пока хватает связки Claude и Cursor с разными моделями на разных ролях: в живых прогонах на Cursor работали разведчики, прокси-кодеры, архитектор systems, риск-тестеры, проверка спецификации и скан наследия. Дальше хочу попробовать отдельный аккаунт для моделей GPT и DeepSeek на других дополнительных ролях.
9. Где в команде фронтирные модели GPT и зачем второе мнение
Сразу оговорюсь: это временная схема, и она настраивается. Какие модели на каких ролях, зависит от того, что у вас подключено. У меня сильная модель GPT сейчас стоит на одной роли (второе мнение для рецензента): в ~/.claude/agent-teams.json это second-reviewer с движком cursor и моделью gpt-5.6-sol-high.
Зачем вообще второе мнение: другое слепое пятно. Ценность этого подхода я оценил ещё на agent-teams, до supertick: рецензент на Claude нашёл одну дыру в обработчике удаления встречи и пропустил соседнюю. Модель GPT через Cursor нашла её с первого запуска.
Правила у меня такие. Если архитекторов больше двух, один идёт через Cursor на grok. Тут удобно, что вы можете сами себе настроить каких архитекторов звать и на каких моделях, причём для каждого уровня сложности могут быть свои правила. Основной рецензент и техлид через Cursor не ходят никогда: правила проекта во внешний CLI не передаются, а решения я наружу не отдаю.
10. Если у вас только Claude Code
Всё, что выше про Cursor и GPT, это моя настройка, а не требование. Если у вас только подписка Claude и нет файла ~/.claude/agent-teams.json, все роли идут на Claude. Лишних вызовов плагин не делает и про движки ничего не пишет. Без этого файла плагин полностью рабочий, а конфиг движков остаётся необязательным усилением. Меняются три вещи:
-
Второе мнение выключено. Это единственная роль, которая не уходит на Claude, а пропускается: та же модель во второй раз ничего нового не увидит. На каждую задачу остаётся один рецензент.
-
Всё, что у меня уходит в Cursor, делает Claude: разведчики, риск-тестеры, проверка спецификации, скан наследия и архитектор вместо grok. Прокси-участников нет вовсе.
-
Если конфиг скопирован, а
cursor-agentне установлен, итог тот же: роли тихо уходят на Claude, второе мнение пропускается.
Кто и на какой модели тогда работает на каждом уровне сложности. Модели взяты из шапок файлов ролей в 1.0.0; если в Claude Code задана своя модель субагентов по умолчанию, она может их перебить.
|
Роль |
Модель |
SIMPLE |
MEDIUM |
COMPLEX |
|---|---|---|---|---|
|
Ведущий |
модель вашей сессии |
✓ |
✓ |
✓ |
|
Разведчик кода |
Haiku |
✓ |
✓ |
✓ |
|
Подборщик образцов |
Sonnet |
✓ |
✓ |
✓ |
|
Техлид: ревью плана, риски, арбитраж |
Opus |
— |
✓ |
— |
|
Три архитектора, спор до трёх раундов |
Opus |
— |
— |
✓ |
|
Риск-тестеры: по одному на CRITICAL, до трёх на MAJOR |
Opus |
— |
✓ |
✓ |
|
Кодеры: по одному на задачу, до пяти одновременно |
Opus |
✓ |
✓ |
✓ |
|
Рецензент, один за раз (меняется каждые 3 задачи) |
Sonnet |
✓ |
✓ |
✓ |
|
Приёмщик по диффу каждой задачи |
Sonnet |
✓ |
✓ |
✓ |
|
Сверка задач между собой (встроенный Explore) |
по настройке Claude Code |
✓ |
— (делает техлид) |
✓ |
|
CI-проверка в конце |
Sonnet |
✓ |
✓ |
✓ |
|
Проверка спецификации в конце |
Sonnet |
✓ |
✓ |
✓ |
|
Проверка в браузере |
Sonnet, нужен Claude in Chrome |
если есть Chrome |
если есть Chrome |
если есть Chrome |
|
Скан наследия (встроенный Explore) |
по настройке Claude Code |
✓ |
✓ |
✓ |
|
Второе мнение на чувствительных задачах |
— |
выкл |
выкл |
выкл |
Проверка в браузере всегда идёт на Claude, но ей нужно расширение Claude in Chrome. Без него пункты для браузера попадают в список ручных проверок для человека.
Что это значит для лимитов подписки
-
Сильнее всего лимиты едят ведущий и кодеры на Opus. В моих прогонах на ведущего пришлось больше половины расхода: он живёт весь прогон и копит контекст.
-
COMPLEX заметно дороже из-за трёх архитекторов на Opus и риск-тестеров. У меня часть этого уходила в Cursor, у вас всё ляжет на лимит Claude.
-
Если взять мой второй прогон из раздела 7, на Claude переехали бы два разведчика, пять риск-тестеров, архитектор, проверка спецификации и скан наследия. На каких моделях Claude они пойдут, по умолчанию задают шапки файлов ролей (они в таблице выше). Это только умолчание: свои варианты каждый настраивает сам.
-
Главная потеря без второго движка: не скорость, а разнообразие проверок. Задачи с деньгами и правами смотрит один рецензент, только глубже, а второго мнения от другой модели нет.
Какие модели добавить для контроля
Если захотите что-то добавить, я бы шёл в таком порядке. Что именно подключать, зависит от того, какие модели у вас есть: всё настраивается, и мои нынешние выборы временные.
-
Второй движок на роль
second-reviewer: модель другого вендора. У меня это GPT черезcursor-agentв режиме только чтения (--mode ask). Срабатывает роль только на чувствительных задачах, так что обходится дёшево. -
Массовые разовые роли (разведчиков, риск-тестеров, проверку спецификации, скан наследия) на дешёвую родную модель Cursor вроде
composer-2.5. Это бережёт лимиты Claude и не тратит недельный лимит Cursor на сторонние модели. Одна оговорка: в--mode askроли, которым нужно запускать команды, ставятся на режим записи с уговоркой «файлы не менять», или остаются на Claude. -
Для COMPLEX: одного из трёх архитекторов на модель другого вендора, чтобы спор был разнообразнее. У меня это
grok-4.7-xhigh-fastи правило: если архитекторов больше двух, один идёт через Cursor на grok. Здесь сейчас хочу добавить условие: если архитекторов три, то третьим обязательно будет что-то из фронтирных моделей GPT. -
На Claude оставить ведущего, основного рецензента, техлида и кодеров: правила проекта во внешний CLI не передаются, а решения я наружу не отдаю. Исключение у меня одно: второго и следующих кодеров на механических задачах ведущий может отдать в Cursor, и решает он это при запуске, а не конфиг.
В конфиге это выглядит примерно так. Ключи ролей взяты из agent-teams.example.json в репозитории. Роль, которой нет в roles, идёт на Claude; second-reviewer без ключа выключен.
{
  "fallback": "claude",
  "roles": {
    "second-reviewer": { "engine": "cursor", "model": "gpt-5.6-sol-high" },
    "codebase-researcher": { "engine": "cursor", "model": "composer-2.5" },
    "reference-researcher": { "engine": "cursor", "model": "composer-2.5" },
    "risk-tester": { "engine": "cursor", "model": "composer-2.5" },
    "spec-verifier": { "engine": "cursor", "model": "composer-2.5" },
    "legacy-scanner": { "engine": "cursor", "model": "composer-2.5" }
  }
}
11. Решения, которые я бы повторил
-
Кодер живёт одну задачу. Новый кодер с чистым контекстом дешевле, чем старый с историей: свежий кодер-добивщик стартует около 90k против 380k у ведущего, который читал бы дифф сам (это оценка из моих заметок, не замер).
-
Рецензент ротируется каждые 3 завершённые задачи, не по таймеру. Без ротации контекст рецензента к 4-й задаче дорастал до ~600k; по оценкам рецензенты съедали 55% прогона, а преемник после ротации стартует около 100k вместо 350k.
-
Архитекторы уходят после дебата. Ход архитектора в дебате ~36k против ~143k хода ревью; три архитектора, которые ещё и ревьюили, съедали 54–69% прогона (оценка).
-
Ведущий не читает код, диффы и отчёты целиком, только пути и первые строки. Его контекст: самое дорогое, что есть в команде; на живых задачах 1.0.0 он всё равно съел больше половины счёта.
-
Сложность считается механически. Торг «да это же простая задача» убирается правилом из шести и семи признаков.
-
Человека спрашивают в пяти случаях: бриф плана, видимая развилка дизайна, чистка старого кода, ручные проверки, пустая задача. Остальные пробелы закрывает разведка.
-
Эталоны в
.conventions/вкладываются в промпт каждого кодера, и по моему опыту это главный рычаг качества. В живом прогоне видно и обратное направление: frontend сослался на правило проекта и тем самым повернул спор архитекторов. -
Второе мнение не видит первого. Модель на Cursor получает только задачу, файлы и дифф, а вердикт остаётся один: у основного рецензента.
12. Грабли, на которые я наступал и которые решал по ходу
-
Конец фоновой задачи простаивающего участника его не будит. Фоном ждёт только ведущий; кодер ждёт файл в переднем плане, вызов за вызовом по 9 минут.
-
Роль без Bash выдумывает время. Рецензент написал
12:06+03:00при реальных13:48+02:00, карточка вышла «старше» письма. В итоге дважды ложный P0. Теперь время карточки берётся как более позднее изlastEventAtи mtime файла. -
Тяжёлые тесты выглядят как смерть. Кодер 5,5 минуты гонял pytest без правок файлов (ложный P0). Теперь тик смотрит
/proc: живой pytest или jest под корнем репозитория даёт P3busy. -
Status: DONE.с точкой тик не считает за DONE. Значение статуса: одно слово без пробелов и точки. -
Относительный путь в фоновом Bash «пропадал» на первом же тике: фоновый вызов может крутиться не в том каталоге. Скрипт сразу переводит путь в абсолютный.
-
Вердикт приёмки ищется только в первой непустой строке отчёта: раньше строка
ACCEPT: … PASSв любом месте отчёта давала PASS. -
Поведение
SendMessageменяется от сборки к сборке. На 2.1.308 он всякий раз отвечалMessage sent to <имя>'s inbox, и техлид дважды принял это заqueuedи слал лишние копии. Правила держатся на том, что вернул инструмент, а не на догадках. -
Недельный лимит Cursor на модели сторонних провайдеров. Этот лимит тратят архитектор на GPT и другие сторонние модели, а родная composer-2.5 его не тратит.
13. Ограничения и планы
-
Статус
busyчитает/proc, то есть работает на Linux. Без/procэто правило просто не действует. -
Исследование я вёл начиная со сборки Claude Code 2.1.274 (18.09.2026), последняя проверенная была 2.1.308 (22.10.2026). Поведение доставки сообщений за это время менялось дважды, на более старых и новых сборках оно может быть другим.
-
Тик не видит смерти Claude-участника, её ловит только сверка состава на P0.
-
Режимы с панелями tmux и iTerm2 не измерялись.
-
Тексты ролей и навыков написаны по-русски; лента идёт на языке пользователя.
-
Прогон, начатый на другом командном плагине, доводится там же: миграции каталога нет.
-
Открытые хвосты записаны в
.legacy-todo.md: например, возраст письма тик пока считает по имени файла, а не по mtime, и при ревью дольше 2 минут это даёт ложный P0. -
Живых прогонов на 1.0.0 пока два. В планах: набрать больше и попробовать модели GPT и DeepSeek на других ролях.
14. Вместо заключения
Главное, что я вынес: в команде агентов дорого стоит не работа, а ожидание. Если вынести ожидание в скрипт, который читает файлы, а ответы класть на диск до отправки сообщений, ведущий становится дешевле и переживает и потерю сообщения, и сжатие контекста. Самой дорогой ролью он всё равно остаётся (на живых задачах больше половины счёта), так что резать есть куда.
Код открыт под MIT: https://github.com/denizen24/supertick. Буду рад issues с разбором неудачных прогонов, PR и особенно замерам с других проектов.
Вопрос к читателям: как вы решаете ожидание в своих командах агентов (опросом, событиями, внешним оркестратором)? И сталкивались ли вы с потерей сообщений между агентами?
Автор: Denizen24