
Вызываем паранойю у ИИ-агентов: заменит ли MCP AppSec?
Привет, Хабр!
Я не писал на Хабре уже 15 лет, но всё это время хотел. Было много всяких разных проектов, продуктов, утилит и много чего ещё, о чём бы следовало написать. Но либо проекты устаревают быстрее, чем выдастся свободная неделька, либо NDA намекает не раскрывать деталей, без которых не получится забористо, либо просто лень. В общем “хорошие мысли преследовали меня, но я был быстрее”.
И вот появилось время, чтобы… Во-первых, примерить на себя роль владельца продукта, не знаю уж почему, но всегда хотелось попробовать себя в роли повелителя бэклога. Во-вторых, опробовать всякие модные Агенты, LLM и прочую нечисть, поработав над интересной мне задачей.
TLDR
Раньше писали скрипты через vim прямо на проде, потом отлаживали через print i,z,b и кофейную гущу, а теперь запускаешь Cursor — и за вечер появляется веб-приложение, а CI/CD уже катит его на прод. Кода стало больше, он стал запутаннее, и хакеры уже не сидят в зелёном терминале — AI-эра тут. Старая добрая триада SAST/SCA/DAST с потоком кода ещё справляется, а вот AppSec становится узким местом.
Поэтому я собрал себе ИИ-помощника с лёгкой степенью паранойи: локальный MCP-сервер AppSecGate, который запускает сканеры, ведёт базу файндингов и заставляет агента бояться уязвимостей.
В статье: как агенты встраиваются в SSDLC, что происходит под капотом MCP, бенчмарк семи локальных моделей на одной RTX 4060 Ti — без явных победителей, но с явными выводами. И ответ на главный вопрос: заменит ли MCP классический AppSec? Спойлер: нет, но рутину снимет, оставив безопаснику архитектуру и логику.
Итак, как было раньше или ещё сейчас
SSDLC даёт довольно прозрачный, проверенный временем и понятный путь сделать разрабатываемое приложение безопасным. Хотя есть несколько стандартов, все они описывают один и тот же подход, но с разных сторон. Вот пример минимального жизненного цикла разработки.
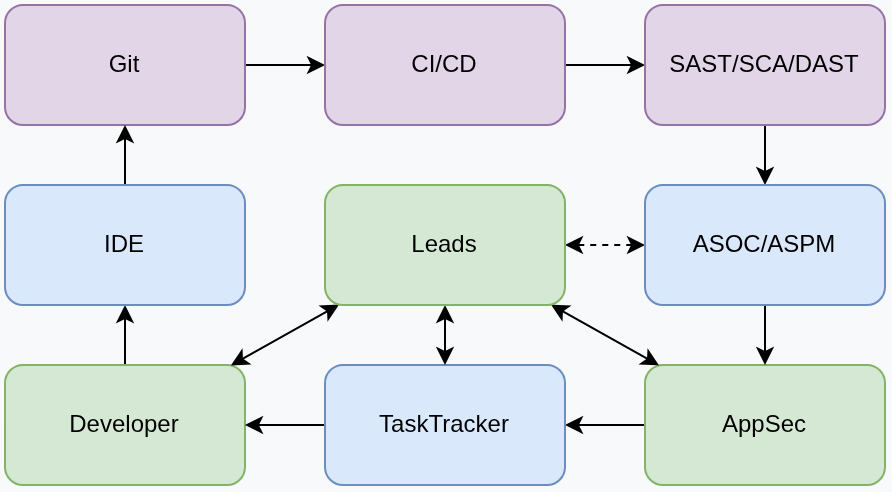
Легенда: зелёный — люди и роли, фиолетовый — инструменты безопасности, голубой — системы агрегации и учёта, оранжевый — агенты.
Разработчик (на схеме — Developer) пишет код, используя свою любимую среду разработки (IDE). После написания код попадает в систему контроля версий (Git), где в рамках процесса сборки и тестирования (CI/CD) запускаются сканеры безопасности (SAST/SCA/DAST). Отчёты от сканеров загружаются в агрегатор файндингов (ASOC/ASPM), где обрабатываются, дедуплицируются, обогащаются и вот их наконец-то видит безопасник (AppSec). Он триажит файндинги, тестирует руками и, если ему что-то не понравилось, пишет задачу в систему управления заявками (TaskTracker). Задача доходит до разработчика, он её исправляет и процесс уходит на следующий круг, и так, пока всем не надоест. За всем этим безобразием естественно наблюдают руководители (Leads), они приоритизируют задачи, налаживают коммуникации, а иногда даже могут ходить в ASOC, чтобы посмотреть на красивые дашборды.
Кстати, если в данной схеме заменить ASOC на TMS, а AppSec на QA, то схема не изменится совсем. У такого “наивного” подхода есть много минусов, но самый жирный — это непредсказуемая скорость исправления уязвимостей. Например, сломались сканеры, дырявую библиотеку нечем заменить или AppSec ушёл в отпуск, а надо релизиться. Вот и получается, что время от появления уязвимости в коде до её фикса может варьироваться от почти мгновенного до когда рак на горе свистнет.
Но, несмотря на минусы, у него есть один перекрывающий всё “плюс” — чёткое и понятное разделение ответственности. Разработчик отвечает за код, безопасник за безопасность, руководители за создание ценности. А сопутствующие проблемы — это и не проблемы вовсе, поскольку решаются деньгами. Больше разработчиков, больше AppSec, дорогие сканеры, автоматизация процессов и так далее, пока деньги не закончатся. И я, несмотря на весь сарказм в описании процесса, против такой организации ничего не имею, потому что это работает! И, что самое главное, можно прозрачно и понятно донести до бизнеса, что если хочешь безопасности — плати.
Надо сказать, что есть множество вариантов качественного улучшения процесса, но востребованы они чаще всего в специализирующихся на разработке компаниях, где критически важен TimeToMarket.
И вот на сцену выходят LLM
Несмотря на то, что я довольно давно в ИБ и вообще деревянный по пояс, но старался держать руку на пульсе и возможности LLM меня удивили не больше, чем их создателей. По факту я оказался абсолютно не готов к новой реальности, где агенты захватили умы и бюджеты, в том числе и мой. Статья написана руками, но дальше я опираюсь на данные, полученные от ИИ, и строю прогнозы и предположения, исходя из собственного разумения.
Первым на появление LLM, конечно же, отреагировали разработчики и принялись радостно переходить на них. Сперва просто нажимали TAB, и функция писалась сама, потом просили реализовать такой-то метод в таком-то файле, и моделька сама всё писала, ну и по итогу разработчик просто скармливает агенту ТЗ, которое написала моделька по задаче, которую написала моделька, и следит, чтобы она сильно от него не отклонялась. И всё это привело к тому, что кода стало больше, а сам он стал сложнее и запутанней. Надо бы отметить, что хотя бы документация теперь есть, и она актуальная, и ей, наверное, можно даже верить. Увеличение количества кода увеличивает нагрузку на AppSec, не только увеличивая объём триажа, но и повышая сложность ручного тестирования. И внезапно AppSec становится узким местом, что усложняет и без того напряжённые отношения.
Но всё-таки в индустрии безопасности тоже читают Хабр и не стоят на месте, когда другие интегрируют LLM. На помощь AppSec приходят замечательные ИИ-инструменты — ИИ-триаж, ИИ-пентест, ИИ-SAST, ИИ-SCA — всё это аккуратно упаковывается в продукты и продаётся и, конечно же, покупается и внедряется. Да и агента грех не использовать в работе, очень уж это сокращает время на поиск точек входа. Правда, есть вариант, что публичные LLM запрещены политикой компании, и тем, кто её пишет (это, кстати, мы) по-хорошему надо её соблюдать. В общем, если внедрить всё, что можно для триажа, то часть рутинной работы снимается. А вот сама структура работы перестраивается в сторону поиска логических уязвимостей и проработки безопасной архитектуры.
Кстати, ИИ-бум породил совершенно новую категорию разработчиков — вайб-кодеров (Vibe-coding). Зачастую они реализуют проекты в одного, при этом могут быть далеки от программирования и безопасности, зато у них есть уникальные идеи, востребованные на рынке. Самое забавное, что идея может быть действительно востребованной и денежной. Менее забавно то, что им приходится верить, что LLM пишет безопасный код, не путает дев с продом и вообще не ошибается. Но, к сожалению, пока такие надежды легко разбиваются о реальность и с этим всем приходится мириться.
По итогу получилась забавная ситуация, когда в процесс разработки вдруг вклиниваются агенты и захватывают его полностью.
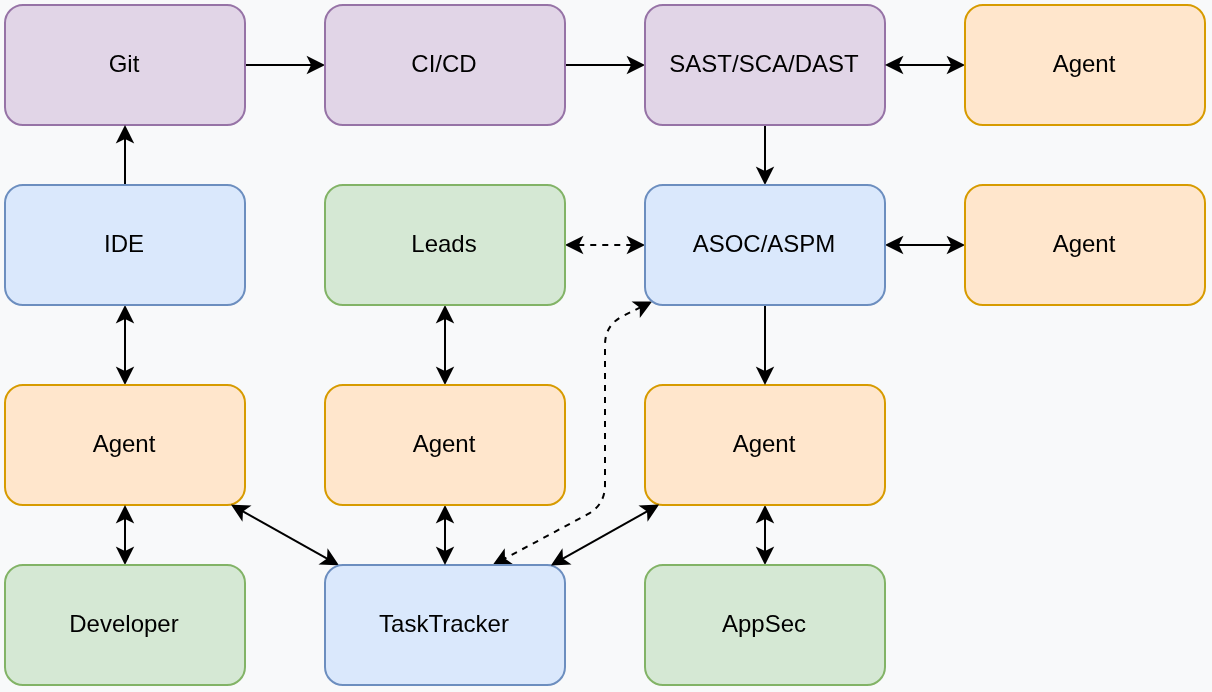
Получается, что теперь процесс изменяется с “Я подумал и сделал” на “Я подумал, написал агенту, он сделал, я проконтролировал”. Давайте “прочитаем” процесс “по ролям”.
-
Руководители генерят идею, агент скребёт по бэклогу и предлагает создать задачу на разработку
-
Разработчик просит агента посмотреть бэклог и выбирает задачу. Если задача ок, то отдаётся команда — “фас” и код попадает в Git
-
CI/CD запускает агента, который сканирует код на уязвимости и исправляет их или просто генерирует отчёт
-
ASOC/ASPM получает все отчёты, нормализует их и отправляет агенту, чтобы тот протриажил и выдал своё заключение
-
AppSec просит агента посмотреть файндинги на ревью, и всё, что ему не понравится, отправлять разработчику в виде задач
-
Руководители в процессе работы просят агента поскрести по бэклогу, находят задачу от AppSec и перекидывают её на ответственного специалиста
И вот петля обратной связи затянулась, план по токенам выполнен, задача закрыта, все довольны и идут пить кофе. Понятно с первого взгляда, что процесс не самый оптимальный. Но при классическом разделении зон ответственности, к которым прилагается бюджет, такой вариант может сложиться “сам собой”.
Взаимодействие Agent-to-Agent
И тут самое время вспомнить про Lean и DevOps (не все знают, но DevOps — это практически адаптация Lean к пайплайну разработки) и прочие прекрасные инструменты из недалёкого прошлого. А они нам предлагают искать максимально короткий путь обратной связи и маленькими шажками двигаться по нему. И такой путь, если взглянуть на схему, становится очевиден — дать агентам возможность работать напрямую друг с другом. Но тут есть нюансы…
Если дать агентам: Разработчик, Руководитель и Безопасник, обсуждать приоритизацию бэклога, то кто из них быстрее поймёт, что с помощью промпт-инъекции договориться проще и быстрее. Но самое интересное — не закончится ли бюджет на токены раньше, чем они придут к этой мысли. Звучит как начало классического анекдота “Заходит в бар…”, кстати такие анекдоты последнее время публикуют в новостях, правда почему-то не в разделе “Юмор”.
Как бы ни хотелось полной автоматизации, пока что она, скорее всего, заведёт нас в тупик. Так что возвращаемся к старому доброму системному подходу и начинаем думать. Собственно, немного подумав, я нарисовал следующую схему.
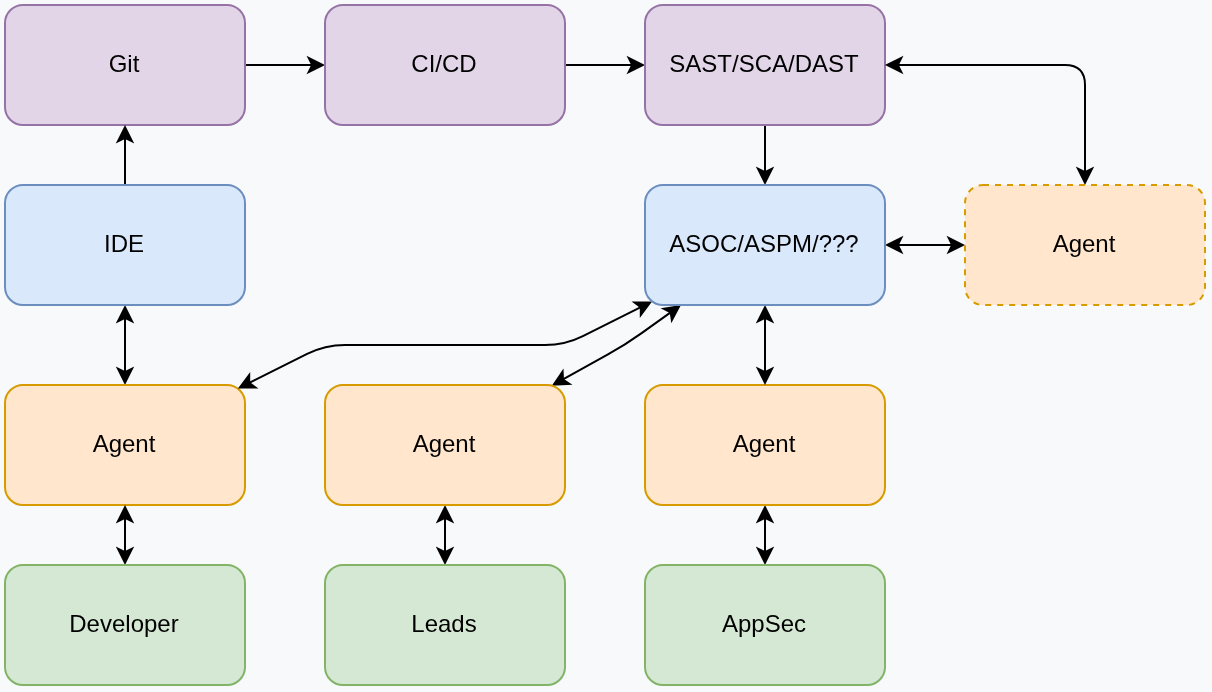
Что мы тут видим в отличие от прошлого варианта:
-
TaskTracker — исключён из процесса обработки файндингов. Потому что раньше он передавал неструктурированную информацию от одного человека к другому, а для агентов лучше сразу обмениваться структурированной информацией. Но при этом трекер может остаться в схеме, например для учёта времени, списания токенов и т.п.
-
В процессе CI/CD остался только один агент, но он в процессе сканирования получает контекст по файндингам из ASOC. И это единственный автономный агент, и он не обязателен, с его работой может справиться агент, запускаемый Безопасником. Нужен он или нет — зависит от того, готовы ли вы к автономным агентам или нет.
-
Система ASOC/ASPM трансформируется из системы для людей в систему для агентов. Сохранится ли у неё старое название или будет называться по-другому, пока не ясно.
А вот чего не видно, — это то, что можно лёгким движением руки сделать shift-left и сдвинуть этап сканирования на этап написания кода и заставить агента сканировать проект самостоятельно. В пользу этой гипотезы можно привести следующие тезисы.
-
Разработчику не нужно париться, так как агент сам будет выполнять сканирование, проверит результаты и попробует исправить. Короче, ничем это не будет отличаться от форматера или юнит-тестов, которые агенты уже научились запускать самостоятельно.
-
Нет смысла блокировать push и останавливать разработку, если вдруг сканер чего-то там нашёл. Проблема автоматически эскалируется на AppSec/Lead.
-
Но при всём при том разработчику проще устранить проблему сейчас, нежели ждать, пока эта проблема прилетит сверху.
-
При сканировании diff можно сильно экономить токены за счёт того, что Агент и так работает с этим файлом.
-
Весь локальный триаж фиксируется на центральном сервере, так что мы можем контролировать процесс и, что самое главное, доказать эффективность подхода руководству
Побочным продуктом такого сдвига может получиться неплохой инструмент для SOLO-VIBE-CODER’ов, которые, с одной стороны, читают новости и не хотели бы в них попадать в качестве иллюстрации ИИ-провалов, а с другой гонятся за TimeToMarket и не могут потратить вечность на изучение вопросов безопасности.
А будет ли это работать?
Для проверки подхода я решил не размениваться по мелочам и реализовать MVP локального MCP-сервера. Он будет запускать сканеры, возвращать результаты по запросу и хранить базу сканирования и триажа. Получилась вот такая вот архитектура.
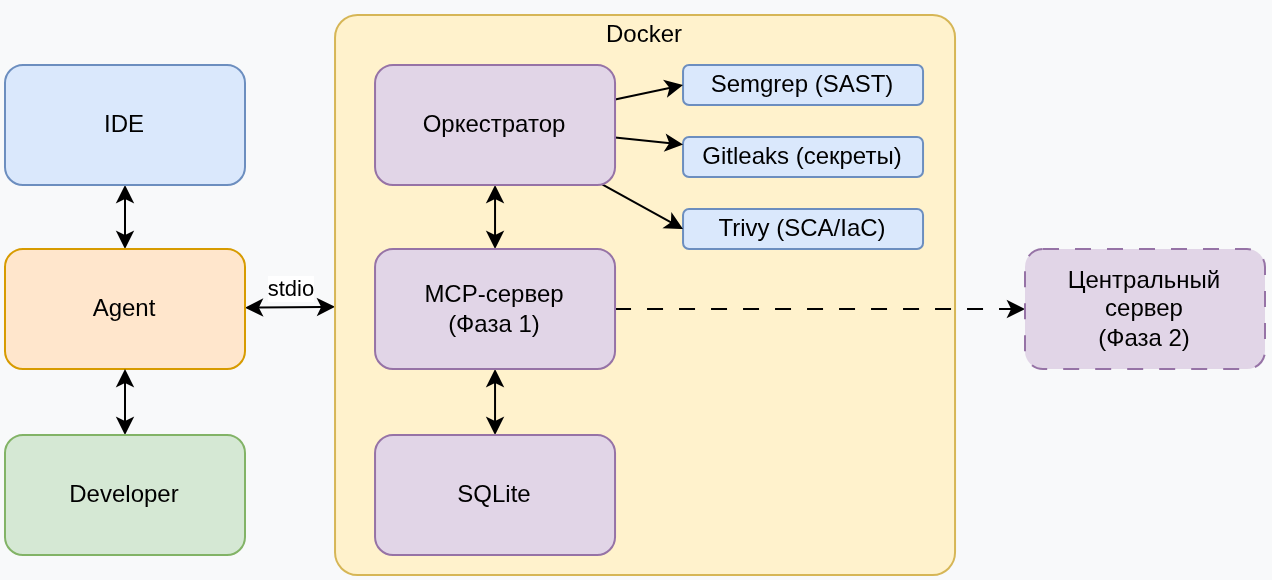
В процессе реализации хотелось ответить на несколько важных для меня вопросов.
-
Сможет ли агент самостоятельно разобраться в инструментарии, если я попрошу “А проверь-ка, голубчик, проект наш на безопасность, да AppSecGate используя непременно”?
-
Сколько времени/денег обойдётся разработка первой версии?
-
Как это всё будет работать?
-
Справятся ли с ролью агента локальные модели, доступные на моём железе “NVIDIA RTX 4060 Ti 16GB”?
-
Словлю ли я “вайб”?
-
Что дальше?
А проверь-ка голубчик…
И вот спустя 7 дней разработки, ~210 миллионов токенов, ~3000 рублей и ~8 литров кофе у меня на руках оказался собранный образ MCP-сервера. К тому моменту я уже переключился с Continue на Cline, написал AGENTS.md и вообще преисполнился, но об этом позже. Клонирую OWASP Juice Shop, без которого не обходится ни одно тестирование ASOC, подключаю AppSecGate MCP в Cline и в режиме планирования пишу “Проверить безопасность проекта” и наслаждаюсь магией.
По результатам нескольких прогонов получилось выявить следующий путь рассуждений агента.
-
Агент проверяет конфигурацию через
get_config -
Запускает сканирование проекта
scan_projectи получает агрегированный результат сканирования -
Проводит анализ находок, используя SQL-доступ к базе файндингов
query_findings_db. Не знаю почему, но Агенту нравится пользоваться именно таким вариантом, хотя есть альтернативы. -
Результат анализа содержит перечисление файндингов и предложение ничего не исправлять, потому что это OWASP Juice Shop и всё так и задумано.
-
Приходится доказывать агенту, что я тут инструменты проверяю и придётся фиксить всё.
-
Получив-таки рабочий план, перевожу его в режим Act и агент принимается за работу
-
Дальше идёт обычный триаж. Получение контекста по срабатываниям —
get_fix_context_batch; если требуется, исправляет и, используяverify_fix_batch, проверяет исправление или подавляет файндинг, если это FALSE_POSITIVE. -
Периодически агент проверяет закрытие файндингов через
query_findings_dbи продолжает их устранять. -
По итогу он формирует отчёт о проделанной работе с основными исправлениями
Последний прогон занял ~50 минут с использованием deepseek-v4-flash и стоил ~15 рублей. За это время обработано 200 находок: 56 исправлено (из них 8 critical, 45 high, 3 medium), 27 признано WONT_FIX (в основном учебные codefix-данные и публичный ALB), 117 отмечено как FALSE_POSITIVE (тестовые секреты Gitleaks). Изменено 29 файлов, diff +333 / −115 строк. Расход токенов: 16 212 728 input (из них 15 173 760 — cache reads) и 56 411 output.
Действия агента более чем предсказуемые, а рассуждения оправданны. Отдельно поразило, как ловко модели научились оперировать результатами сканеров и исправлять файндинги. Не могу утверждать точно, но, кажется, модели специально натаскивали под подобные задачи, что в целом неудивительно.
Сценарий с мягким shift-left я тоже пробовал отработать. Изначально была идея использовать хуки, но как они работают понять не смог и нашёл вариант добавить требование в AGENTS.md, можно и через rules, но, кажется, оба варианта по итогу обрабатываются одинаково. И вариант с AGENTS.md в теории универсален для разных типов агентов. Перед тем, как добавлять правила, рекомендую выполнить один прогон вручную, чтобы агент набрал контекста по использованию MCP. Важно помнить, что бы вы ни написали в правилах, модель может это проигнорировать или воспринять неправильно.
Всё хорошо, но проект явно сыроват и требует времени на допил. Во время прогонов я заметил несколько проблем (уверен, что их больше).
-
Один раз модель потеряла 20 файндингов и нашла, когда я её попросил повторно просканировать проект
-
Cline не сжимает контекст, пока задача полностью не закончится, почему — непонятно. Это точно неправильное поведение, которое может влиять на расход токенов и скорость сканирования.
-
Иногда MCP обманывает агента, например, посчитав два дубля файндинга за один, что приводит к дополнительным рассуждениям
-
Иногда возникает задумчивость при работе с
query_findings_db, например, агенту требуется узнать состав полей -
Когда тестировал pre-commit, намеренно изменил файл и попросил закоммитить изменения. Агент запустил скан, но пометил находки как WONT_FIX, типа, человек же сам исправил, значит, так надо…
Но самое главное — оно работает. Да, нужно поправить баги, да, нужна центральная база хранения — но это уже дело техники. Прежде чем превращать MVP (а если смотреть на полный функционал — будем честны, скорее PoC) в полноценный продукт, я решил глубже погрузиться в магию MCP и собрать побольше грабель.
Как рождается магия MCP
При запуске IDE агент считывает конфигурацию. Ниже пример конфигурации Cline (.cline/data/settings/cline_mcp_settings.json) для запуска локального MCP-сервера:
{
  "mcpServers": {
    "appsecgate-jshop": {
      "type": "stdio",
      "command": "/usr/bin/docker",
      "args": [
        "run",
        "--rm",
        "-i",
        "--network=none",
        "--read-only",
        "--tmpfs=/tmp:size=100M,mode=1777",
        "--tmpfs=/home/appsecgate/.cache:size=2G,mode=1777",
        "--tmpfs=/home/appsecgate/.appsecgate-mcp:size=100M,mode=1777",
        "--cap-drop=ALL",
        "--security-opt=no-new-privileges:true",
        "-v",
        "./projects/juice-shop/:/workspace:ro",
        "moondoom/appsecgate-mcp:latest",
        "--transport",
        "stdio",
        "--project",
        "/workspace"
      ],
      "disabled": false,
      "timeout": 600
    }
  }
}
В примере используется локальный запуск сервера “type”:“stdio”, что указывает агенту на необходимость самостоятельно запустить сервер, выполнив “command” с “args”. Есть ещё вариант удалённого сервера “type”: “http” и “url” вместо “command”. В варианте “stdio” есть как плюсы, так и минусы:
Плюсы:
-
Используется образ Docker — это позволяет легко распространять приложение, то есть конфигурация универсальная и не требует установки дополнительного софта, кроме Docker, конечно же.
-
Для stdio не требуется наличие сети в контейнере, так что его можно запускать в режиме максимальной изоляции. Это в целом снижает риски, связанные с запуском “чужого” кода, что не может не радовать такого параноика, как я.
-
Можно использовать volume для хранения постоянных данных, а можно и tmpfs прописать, и тогда они сами будут чиститься при каждом запуске, что удобно для отладки. В примере отладочный вариант представлен, для прода с
README.mdознакомится ты должен сперва.
Минусы:
-
Требуется в явном виде пробрасывать исходники проекта в контейнер. Для связки VS Code + Continue — можно использовать переменные окружения, а вот связка VS Code + Cline у меня так и не завелась и пришлось хардкодить путь проекта (судя по всему из-за того, что у меня VS Code установлен через snap, а так-то вроде можно)
-
Изоляция приводит к тому, что базы правил для SAST/SCA нельзя обновлять в режиме онлайн. Для MVP это не критично, для Enterprise вообще огонь, но вот для массовой аудитории может создать трудности с обновлением библиотек. Пока вижу вариант передавать аргумент “–pull=always”.
-
Постоянные volume могут вызывать проблемы при обновлении сервера из-за разных версий баз данных, но это проблемы будущих итераций :)
После запуска контейнера Агент начинает своё общение с сервером. Проводит инициализацию (initialize) и получает список доступных на сервере тулов (tools/list). Далее список тулов косвенно встраивается в SYSTEM_PROMPT и передаётся при каждом запросе к модели. Таким образом, модель понимает, что ей доступны tool-ы и сразу получает исчерпывающие инструкции.
Очень удобно для пользователя и в равной степени для злоумышленников. Ведь для успешной атаки на агента через MCP достаточно просто подключить его и отправить хотя бы один запрос, а дальше модель, повинуясь внутреннему голосу, начнёт исполнять волю “Хаоса” и творить “добро” направо и налево. Это известная проблема и современные модели должны изолировать тулы и не воспринимать их как прямые указания к действию, но это не точно и зависит от модели. Так что будьте осторожны при подключении любых MCP, даже если вы запускаете его удалённо или в изолированной среде. Как вариант можно вручную проверить список тулов полученных от сервера в интерфейсе расширения, до первого запроса к агенту.
Соответственно, при получении запроса “Проверить безопасность проекта” модель уже “знает” об инструментарии, доступном ей, и принимает единственно верное решение — использовать инструмент с подходящим описанием. Дальше поведение агента уже зависит от системного промпта и результатов которые вернул MCP.
То есть у нас фактически есть три “крутилки”:
-
Системный промпт. Определяет общее поведение агента, например — “митигировать, нельзя пофиксить” или “митигировать нельзя, пофиксить”, а третьего не дано.
-
Описание тулов. Указывает какие инструменты использовать и как обрабатывать их результаты
-
Результаты сканирования. Это один из самых вариативных инструментов, меняя описание правил и критичность различных категорий, можно регулировать поведение агента в зависимости от типа уязвимости.
Про важность этих “крутилок” я узнал, пока тестировал локальные модели, но эту историю нужно рассказать подробнее.
Тестирование open-source моделей
Мне, как безопаснику, долгое время боровшемуся с утечками корпоративных тайн, горько смотреть, с какой лёгкостью сейчас люди переходят на публичные модели. Поэтому при работе с исходниками компании я всегда использовал только локальные LLM — благо ещё до повышения цен собрал себе неплохой сетап. Но железо ≠ магия, так что без подводных камней не обошлось.
Железо
Всё крутится на одном хосте под Proxmox VE, с включённым IOMMU и обеими GPU, проброшенными в гостей:
|
|
Хост (PVE) |
VM “Workstation” |
VM “LLM” |
|---|---|---|---|
|
CPU |
i7-13700K, 16C/24T (8P+8E), до 5.4 GHz |
8P |
8P |
|
RAM |
64 GB |
24 GB |
24 GB |
|
GPU |
— |
Intel UHD 770 |
NVIDIA RTX 4060 Ti 16GB |
|
Монитор |
только на старте |
да (подключён к матери) |
headless |
|
Диск |
Samsung 980 PRO NVMe |
ZFS |
ZFS |
Почему именно так:
-
Обе GPU проброшены в гостей — хост “голый”, ни
i915, ниnvidiaв нём не грузятся. -
Workstation на Intel UHD 770 — там монитор, VS Code + Cline, браузер и Docker с MCP-сервером AppSecGate. Модели не крутятся, GPU нужна только чтобы рисовать интерфейс.
-
LLM на 4060 Ti 16GB — headless, только под вычисление.
Плюс такой конфигурации в том, что видеокарта полностью отдана под вычисления: ollama, hashcat или, например, jupyterlab + pytorch. Причём вся эта радость в докере, так что можно менять конфигурации как перчатки. Ну а если надо поиграться с настоящими ИИ можно загрузить Win и погонять ИИ-скинов в Cyberpunk через Moonlight. Есть и проблемы, но я к ним уже привык.
Изначально хотел тестировать модели руками в Cline и по ходу дела делиться впечатлениями. Полагаясь на свой опыт работы с deepseek-r1:14b, думал, что слабые модельки попросту не смогут нормально работать с инструментами и будут лажать. Но, запустив более-менее современную модель, понял, что всё не так плохо. Пришлось пересматривать свои планы и быстренько собирать стенд для тестирования.
Быстренько, как водится, не получилось, а получилось вот так вот.
-
Цель для сканирования — микропроект на Flask (app.py) — 8 уязвимостей для Semgrep и Docker+requirements.txt для Trivy
-
Тестовый Агент — с задачей сканировать, фиксить SAST и эскалировать находки Trivy
-
AppSecGate MCP — сканирует и предоставляет агенту результаты
-
Coding Tools MCP — в качестве замены стандартным тулам Cline
-
Обёртка, которая всё это дело запускает и сохраняет логи и трейсы.
Важный дисклеймер! Цель тестирования — проверить, что MCP вообще заработает! Тесты не претендуют на объективность, а результаты могут не отражать реальную производительность и возможности тестируемых моделей!
Далее попросил DeepSeek выбрать несколько моделей, которые по его разумению сдюжат агентский режим и прогнал по ним предварительные тесты. Контекст выбрал 32768 токенов, это вроде как минимум для агентов. Размер и раскладку CPU/GPU брал из ollama ps. Никакого дополнительного тюнинга не применял, просто загрузил, используя ollama pull. Передварительно решил оценить скорость моделей.
|
Модель |
Параметры |
Tools |
Thinking |
Размер |
CPU / GPU |
t/s |
|---|---|---|---|---|---|---|
|
gemma4:26b |
25.2B |
да |
да |
~16 GB |
21% / 79% |
84.0 |
|
gpt-oss:20b |
20.9B |
да |
да |
12 GB |
0% / 100% |
67.8 |
|
qwen3-coder:30b |
30.5B |
да |
нет |
15 GB |
1% / 99% |
58.5 |
|
glm-4.7-flash |
29.9B |
да |
да |
15 GB |
1% / 99% |
52.0 |
|
qwen2.5-coder:14b |
14.8B |
да |
нет |
15 GB |
0% / 100% |
31.0 |
|
qwen3.8:27b |
27.3B |
да |
да |
17 GB |
35% / 65% |
12.1 |
|
devstral:24b |
23.6B |
да |
нет |
20 GB |
23% / 77% |
9.5 |
Судя по токенам в секунду, думал, что лидерами будут qwen3-coder:30b или glm-4.7-flash, потому как большие и быстрые, хотя и не полностью на GPU. Первые прогоны выявили лидера — glm-4.7-flash, на нём я прогонял все предварительные тесты и тюнил промпт.
Про то, что у меня есть ещё и
gemma4:26bя вообще забыл и в первой табличке долго не замечал её отсутствие, а выплыла она уже когда заканчивал статью… Потому не рассматривал её как серьёзного конкурента.
Писал агента не сам, но пока корректировал действиями Cline, выделил те самые “крутилки” из предыдущего параграфа. А ещё с удивлением для себя обнаружил, что в моём MCP описание инструментов написано на русском, что вроде как не круто, поэтому оперативно поменял. Так что, более-менее приведя агента в рабочее состояние, я запустил тестирование, скормил логи агенту и принялся изучать результаты.
|
Модель |
Recall (mean) |
Fixed (med) |
Токены (mean) |
Время (mean) |
Pass |
|---|---|---|---|---|---|
|
qwen3.8:27b |
100% |
8 |
314k |
650s |
3/3 |
|
gemma4:26b |
87% |
6 |
879k |
419s |
3/3 |
|
qwen3-coder:30b |
73% |
5 |
877k |
451s |
2/3 |
|
glm-4.7-flash |
73% |
7 |
1.17M |
772s |
2/3 |
|
gpt-oss:20b |
47% |
0 |
254k |
89s |
1/3 |
|
devstral:24b |
3% |
0 |
4.7k |
25s |
0/3 |
|
qwen2.5-coder:14b |
0% |
0 |
4.2k |
5s |
0/3 |
А результаты меня удивили! Во-первых, мой фаворит glm-4.7-flash — залажал в самом конце и ушёл в петлю, а qwen3.8:27b взял и победил, что называется чисто на скиле. Для серьёзных выводов трёх прогонов, конечно, маловато, но у меня и не стояло такой задачи. Агент распределил места следующим образом.
|
Модель |
Вердикт |
Обоснование |
|---|---|---|
|
qwen3.8:27b |
🏆 “Победитель” |
100% recall × 3 прогона, 8/8 fixed, минимум токенов среди топа, 0 ошибок |
|
gemma4:26b |
🥈 Второй |
Стабилен (3/3, 80–90%), самый быстрый среди прошедших (419s), но в 2.8× дороже по токенам и медианно 6/8, а не 8/8 |
|
qwen3-coder:30b |
⚠️ Средний |
Recall нестабилен (40–100%), patch_succ 0.57 — часто бьёт мимо после сдвига строк |
|
glm-4.7-flash |
⚠️ Нестабилен |
Один прогон — 100%/376k, другой — 20%/1.8M с 3 ошибками. Высокий ceiling, но не гарантирует |
|
gpt-oss:20b |
⚠️ Слабый |
1/3 pass, 6 tool exceptions, два прогона из трёх — 20–30% recall |
|
devstral:24b |
❌ Не оценить |
0 tool-calls, JSON в тексте вместо вызова |
|
qwen2.5-coder:14b |
❌ Не оценить |
То же — JSON-описание вместо tool call |
Главные выводы прогона.
-
Небольшие модели могут стабильно работать в роли агента, пусть и с ограничениями.
-
Скорость по токенам для агентов важна, но может ничего не стоить, если модель плохо ориентируется в инструментах или уходит в петлю.
Лично для меня это означает, что можно автоматически сканировать и размечать большие проекты по цене электричества. При этом я, скорее всего, буду использовать glm-4.7-flash для большинства задач, возможно под контролем более тяжёлого, но стабильного qwen3.8:27b или всё же внимательнее присмотрюсь к gemma4:26b. Ещё думаю поиграться с настройками ollama, квантованием и пошерстить Hugging Face. Нужно больше тестов, больше прогонов, красивых табличек и ещё более красивых графиков. А пока я вдоволь наигрался в тестировщика и готов поделиться своими незабываемыми впечатлениями и далеко идущими выводами.
Лёгкий оффтоп про “вайб”
Если говорить честно, то всё, что написано выше, — это рассуждения, к которым я приходил по ходу реализации первой фазы проекта. А изначально я просто напрягал DeepSeek своими рассуждениями о переработке резюме и предложил оценить меня как Продукта. Потом была мысль, а не сделать ли свой пет-продукт. Слово за слово и вот “architecture.md” уже сохраняется в пустой каталог “docs”, а агенту ставится задача реализовать первую фазу проекта. А дальше всё как в тумане…
И за три недели блужданий из тумана я так и не выбрался, лошадок не видел, ёжиков тоже, но зато вместе с ИИ поиграл в ролевые игры.
-
Я-Продукт — хочу сделать продукт, чтобы и самому пользоваться и другим не стыдно было поставить. В общем исследуем рынок, смотрим кто там конкуренты… о, кажется, пора уже и запускать.
-
ИИ-Программист — а чего ждать, сперва одну фичу, потом другую, потом баги, баги и ещё раз баги…
-
Я-Безопасник — надо накрутить изоляцию в докере, проверить лицензионную чистоту и вот ещё бы изолировать Cline, а то один “rm -rf /” и всё…
-
Я-Инженер — надо оптимизировать сборку докера, потом подумать, как будем релизиться. А ещё безопасник что-то там писал про изоляцию, но это потом.
-
Я-Архитектор — так что-то продукт плохо работает, надо подумать о дедупликации файндингов, слышал недавно про какие-то векторные базы, надо прикрутить. DeepSeek говорит, нормальная штука, вот тебе ADR-0001
-
Я-Продукт — Так, версия 0.1.0 уже, считай, релиз, начинаю писать статью! Так, сперва процессы, потом технины добавить, но тут пусть Инженер с Программистом думают. А ещё надо рекламой заняться, ё-моё!!! оказывается 90% рынка MCP англоязычный… Надо срочно перевести всю документацию на английский…
И так целыми днями, пока Агент фиксит очередной баг или делает рефакторинг, ты уже переключился на другую роль, исследуешь очередную проблему. Я бы не назвал это вайбом, но процесс затягивает и балует мозг изрядным количеством дофамина. Особенно цепляет скорость, с которой можно воплощать свои идеи в жизнь. Причём скорость тут зависит не от привычных всем переменных — сколько программистов, какая у них квалификация и какая атмосфера в команде, а от знаний конкретного человека и от того, сколько у него денег на токены. И скорость — это то, что бросается в глаза, а за скоростью прячется ещё и куча возможностей. Например, в разрезе моего проекта я не вижу смысла засовывать под капот множество сканеров или делать гибкую настройку workflow, это легко может сделать любой желающий одним промптом. Ведь для агента не важно, кто его запустил, изначальный разработчик или просто рандомный чувак, которому нужна какая-то фича, контекст будет одинаковый, а вот результат скорее всего будет ближе к ожиданиям заказчика.
И что дальше
У проекта был изначальный роадмап, который исходил из кратчайшего пути к готовому продукту. Но в процессе работы над проектом и статьёй я получил новые вводные, о части которых даже не догадывался на этапе планирования.
-
Народ уже строит целые операционные системы из агентов, в которых нет IDE и минимум людей. Я пока не понимаю, насколько такой подход захватит мир, но надо разбираться. Потенциально, это новые клиенты, для которых проект может стать “санитарным минимумом” по внедрению SSDLC. Тут уже главное показать, что продукт готов к автономной работе и не требует больших усилий по настройке, а то и может кастомизироваться агентами на лету.
-
Локальные LLM могут работать в Агентских сценариях и надо учитывать, что продукт может заинтересовать тех, для кого важна локальность — корпоративного заказчика. Причём, скорее всего, его средняя часть, у кого есть деньги на собственное железо, но нет Директора по ИИ-трансформации. Таким клиентам бывает сложно продать “чистую безопасность”, потому, возможно, стоит добавить больше правил на code-smell и compliance.
-
Весь проект — это одна неделя разработки, его легко повторить. Конкурентов в данной нише много, от простеньких “обёрток для сканера”, например “Semgrep MCP”, до классических ASPM, уже реализовавших MCP-интерфейс, — например, “Checkmarx One” и “BoostSecurity”, и модных ИИ-native по типу “ZeroPath”. Так что общая ценность проекта стремится к нулю и надо как-то отстраиваться от конкурентов. Например, делать упор на открытость, лёгкость и возможность быстрой доработки под конкретные флоу.
Подумав немного о вводных, решил, что дальше у меня будет три основных направления развития продукта.
-
Разработка Фазы 2, то есть центрального сервера с возможностью агрегации событий от нескольких агентов, работающих независимо. И чутка захватить Фазу 4, чтобы получить возможность анализировать данные и строить красивые дашборды. Так можно реализовать самый главный функционал и оценить стоит ли развивать проект дальше.
-
Сделать лёгкий реверанс в сторону корпоративного заказчика и поддержать популярный в корпоративной среде сканер — SonarQube. При этом можно попробовать показать, что с доработкой правил и центральным сервером, продукт работает не хуже SonarQube, но при этом легче и быстрее.
-
Провести боевое слаживание в сценарии с несколькими агентами, а-ля ИИ-Мастер — ИИ-Слейвы. Это самый интересный кейс, лично для меня. Хочу провести анализ 50-100 открытых проектов и посмотреть, что там по находкам. Тут можно и надёжность самой тулы проверить, и правила потюнить и самому проверить как там с безопасностью OpenSource написанного Vibe-Coder-ами.
Ну и по мелочи ещё куча всяких проблем, которые надо пофиксить. В общем, планов громадьё, кофе и печеньки закуплены. Есть огромное желание поделиться результатами с сообществом — так что если хотите следить за развитием проекта и не пропустить следующую статью (спойлер: она будет не про MCP, а про моё видение безопасности LLM в целом), подписывайтесь на мой канал ArchiSecOps. А пока я готовлю продукт и план для следующей статьи, приглашаю всех желающих попробовать и оценить AppSecGate MCP.
Автор: animage