
Как мы сократили Т2М контента с 7 дней до 1 часа, применив подход на основе данных и вывернув известный мем наизнанку
Привет, Хабр. Я Михаил Мирошников из департамента данных и рекомендательных систем B2C Сбера. Расскажу о переменах в подготовке банковских коммуникаций: об ИИ‑генерации текстовых форматов, их почти моментальном согласовании при помощи LLM‑проверок и о том, куда это всё ведёт контентные команды.
По волнам памяти
Олды помнят мемный твит про «придумывали 3 человека, а согласовывали 33». Лучшего анекдота про недостатки процессов в крупных технологических компаниях, пожалуй, нет. Хорошо помню, как выглядела подготовка контента, когда я пришёл в Сбер. Условный пуш в среднем делали недели две, и эти две недели включали в себя, помимо денька «на подумать» и минут 20 собственно написания, следующие этапы согласования:
-
одобрение заказчиком первого черновика;
-
редактура маркетологами;
-
внутренняя редактура в подразделении;
-
согласование репутационных рисков;
-
юридическая проверка;
-
compliance‑согласование (опционально, в зависимости от продукта);
-
ещё один ок от заказчика, что черновик можно показать людям из продукта;
-
согласование продакт‑менеджеров или иных партнёров.
На этом этапе несчастный пуш зачастую напоминал письмо дяди Фёдора родителям — в лучшем случае. А в худшем — трек Кендрика Ламара с восемью гостевыми куплетами от разных авторитетных обладателей «Грэмми». Я имею в виду длину, далеко выходящую за пределы допустимых технических требований и здравого смысла. Поэтому к делу снова подключался редактор и помогал ужимать текст до допустимых значений.
9. Наконец, согласовывал корректор, после чего следовала тестовая отправка коммуникации, во время которой кому‑то из тестовой группы (человек десять) могло ещё что‑нибудь не понравиться.
Водопад правок покрывал тебя с ног до головы, и с этим до поры до времени никто особо не спорил: банк — это всё‑таки структура, основанная на процессах и правилах. В некоторых банках всё по‑прежнему происходит так, как я описал. Контент‑менеджер тут, как правило, ощущал себя персонажем из другого мема:
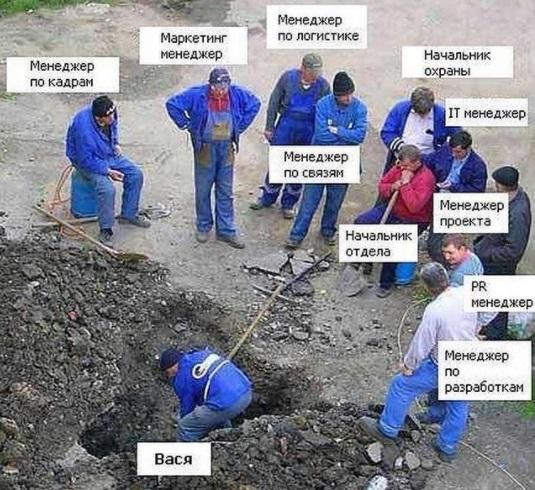
Точно не помню, с чего начался редизайн этого порочного круга согласования — это, скорее, было эволюцией, а не революцией, — но постепенно мы пришли к сокращению количества согласователей. В конце 2023 года стандартный цикл подготовки составлял около недели — 5-6 рабочих дней — и включал в себя редактора, репутационные риски, юристов, корректора, ну и compliance при необходимости. Лучше, но всё равно плохо для эры, когда инфоповоды живут полдня, а коммуникация должна попадать в самое сердечко. И тут мы стали активно внедрять ИИ в контент.
Эра ИИ и числа
Про ИИ‑агентов тогда ещё ничего не говорили, этот хайп начался немного позже. Поначалу мы просто учились создавать тексты: писать промпты, учитывать в них сегментную и канальную логику, соотносить разные правила эффективности с разными продуктами, контролировать эффективную длину сообщения, применять коммуникационную типологию и учитывать нюансы, которые скрываются под большой синей кнопкой «Сгенерировать».
В конце 2023 у нас было 0% сгенерированных текстов и 10% сгенерированных картинок в мейлах и лендингах. В конце 2024 30% наших SMS и пушей были на ГигаЧате и DeepSeek, а от выкупа изображений мы почти полностью отказались — они были сгенерированными. Но на том этапе контент всё ещё проверяли люди. Причины разные: и неуверенность в качестве генерации, и сложность согласования фундаментального редизайна процесса, и — чего уж там — некая технофобия. Количество сделанного контента росло, но не экспоненциально: узким местом было именно согласование.
Мы понимали проблему. В конце 2025 уже 70% коротких текстовых форматов генерировали только ГигаЧатом в Creator (это софт, в котором мы готовим и согласовываем тексты), мы начали E2E‑генерацию писем и лендингов, и наконец‑то начали применять ИИ‑проверки вместо согласования людьми. Пока только для части контента, с ложными срабатываниями, не в интерфейсе целевой АС, а через почтового бота, но это работало. Учитывая агентский хайп, все согласующие подразделения в Сбере были позитивно настроены к тому, чтобы вовлечься в разработку чего‑то с буквами «ИИ».
Разумеется, внедрение ИИ привело к повышению эффективности и углублению персонализации. В 2023 мы делали около 11 000 единиц контента, а в прошлом году перешагнули за 22 000, при этом заметно сократив ресурсы. Например, в моей команде мы стали вдвое продуктивнее, при том что собственно контент‑менеджеров в ней вместо 10 стало 5: кто‑то сменил роль, став проект‑менеджером, кто‑то перешёл в другие контентные команды.
Проверки‑проверочки
Кто‑то спросит: «А зачем вообще нужны проверки, почему нельзя сразу сгенерировать идеальный и соответствующий всем требованиям и законам текст?» Объясню на картошках. Сразу сгенерировать клёвый текст одной кнопкой и одним промптом возможно, но давайте представим, что вчера вышел закон, который требует в любой интернет‑рекламе писать некое примечание, а сегодня в Сибири начались паводки и оба этих фактора следует срочно учесть в коммуникации. Первый добавляет в текст пуша (только пуша, не SMS, потому что SMS — это не интернет) соответствующую фразу и имеет отношение к юридической проверке, а второй применяет правила сдержанного стиля — без CTA, весёлых эмодзи и юморной подачи, — и это уже проверка на репутационные риски. В случае с идеальным сценарием «по одной кнопке» тебе нужно слишком много поменять под капотом, а потом согласовать эти изменения, и займёт это не меньше одного спринта. Править фильтрующие проверки значительно легче с точки зрения релизов и операционного ресурса на разработку. Это как дёрнуть рычаг, переведя LLM во временный «красный» режим.
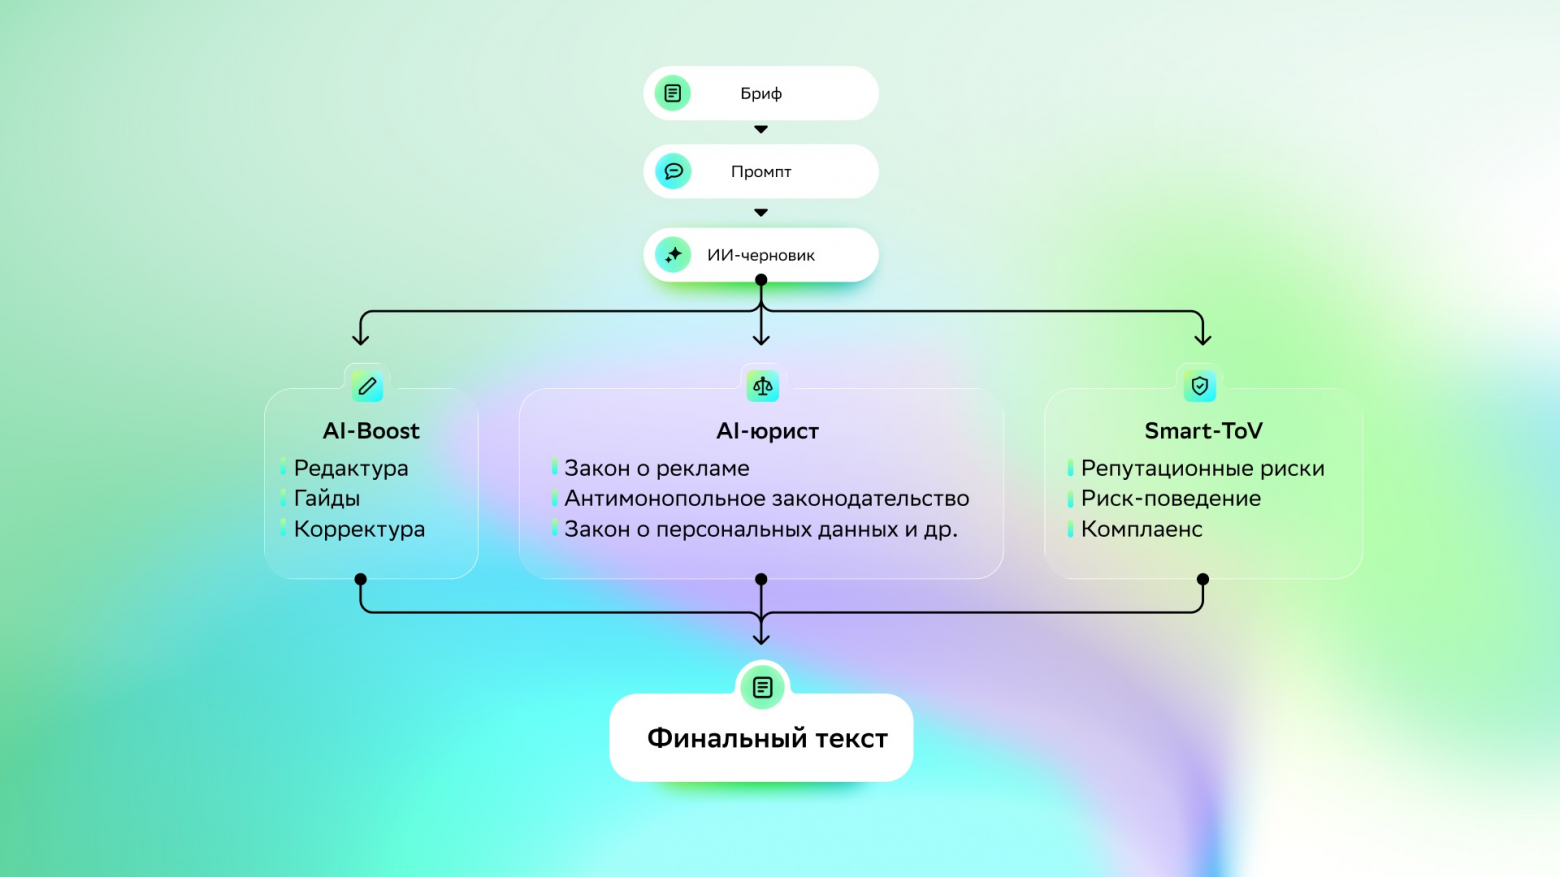
Все этапы согласования мы сгруппировали в три ИИ‑проверки.
ИИ‑Boost. Это помогает с редактурой и корректурой. Для того чтобы определиться со списком применяемых правил, мы выгрузили весь согласованный контент за последнюю пару лет и изучили комментарии редакторов и корректоров. Несмотря на десятки тысяч единиц контента, все их комментарии были более‑менее однообразны. Их можно сгруппировать примерно в 50–60 ключевых правил, по которым ГигаЧат должен проверять SMS и пуши (75% наших коммуникаций). К ним мы добавили Орфограф, нужные руководства по продуктам, возможность проверять список заимствованных слов и некоторые другие нюансы. Особенность этой проверки ещё в том, что её правила «прибиты гвоздями». Нельзя писать с ошибками и не по руководствам. Дотюнив корректность срабатывания для части контента в почтовом боте, мы зарелизили проверку в Creator и сделали её доступной для всего контентного стрима B2C. Теперь не нужно выбирать согласователя, включать его в ветку согласования, писать ему в мессенджере: «Женя, посмотри, как будет минутка», и ждать, пока Женя посмотрит.
Редактор и корректор при этом никуда не делись: у нас есть письма, лендинги и другие каналы, для которых проверки ещё не реализованы. Но жизнь для них стала проще: только представьте, в прошлой итерации контентного процесса при объёме примерно 2000 единиц контента в месяц на каждого согласователя падало бы что‑то каждые минут пять. Думаю, легко представить, как снижается чувствительность к ошибкам на таком конвейере. Ну и отпуски редактора и корректора теперь проходят для всех без стресса.
Smart ToV. Это ИИ‑проверка репутационных рисков. Подход был тот же: посмотреть правки и комментарии за последние годы, кластеризовать их и разделить на критичные и некритичные. Критичные, размеченные «светофором», — это конкретный список токсичных тем и формулировок, которые есть у контентных команд в любой крупной организации, а также правила активации временного режима коммуницирования в регионах, охваченных ЧС.
А ещё мы уделяем внимание эмодзи в коммуникациях и тому, как они должны связываться с теми или иными продуктами, следим за правилами отсылки к актуальным мемам и новостям. Модель может отследить использование сленга и подсветить, скажем, слово «кринж». Но его использование может быть осмысленным: например, если СберПрайм будет запускать что‑то на молодёжь, склонную к использованию такой лексики, тогда всё ок. Человеческое согласование нужно только при фиксации моделью «красного» риска.
ИИ‑юрист. Самая сложная штука, разработкой которой занимались коллеги из блока GR. Нужно понимать, что безрисковых рекламных коммуникаций не бывает. Учитывая, что 75% нашего бэклога это короткие форматы, где нет технической возможности отобразить все условия продукта или расставить полные примечания нужного формата — некоторые из них сами размером как SMS, — тот или иной риск штрафа для организации и конкретного сотрудника присутствует почти всегда. Что мы сделали: собрали типовой контент по пяти ключевым финансовым продуктам, проанализировали встречающиеся в них риски и составили так называемые карты рисков. В них указаны формулировки, повышающие вероятность наступления риска, возможная ответственность и меры по снижению рисков. Карты рисков утверждены для подразделения Data, но функциональностью могут пользоваться и не париться все контентные команды B2C.
Направляя контент на согласование ИИ‑юристу, коллеги просто дожидаются ответа модели, которая подсвечивает им все содержащиеся в сообщении риски и предлагает меры по их снижению. Если найденные риски высоки, то мы рекомендуем изменить формулировки, во всех остальных случаях контент‑менеджеру достаточно ознакомиться с ними и поделиться списком выявленных рисков со своим заказчиком. То, что раньше по SLA занимало пять дней, теперь занимает минуты три. До конца года ИИ‑юрист сможет рассматривать контент по другим банковским продуктам, научится определять риски в контенте по страховкам и подписке СберПрайм. Дальше — его масштабирование на все продукты Сбера и дочерних компаний, ну и, конечно, на все виды контента.
Также мы вот‑вот зафиналим compliance‑проверки для контента по инвестициям и месяц назад вывели проверку рисков поведения — это совсем новый для нас вид проверок. Крутое название мы ей ещё не придумали. Она нужна, чтобы наша реклама не вводила в заблуждение, не использовались манипулятивные практики и всё было максимально корректно. В общем, это раньше называлось «без скрытых условий и надписей мелким шрифтом».
Что же с нами стало
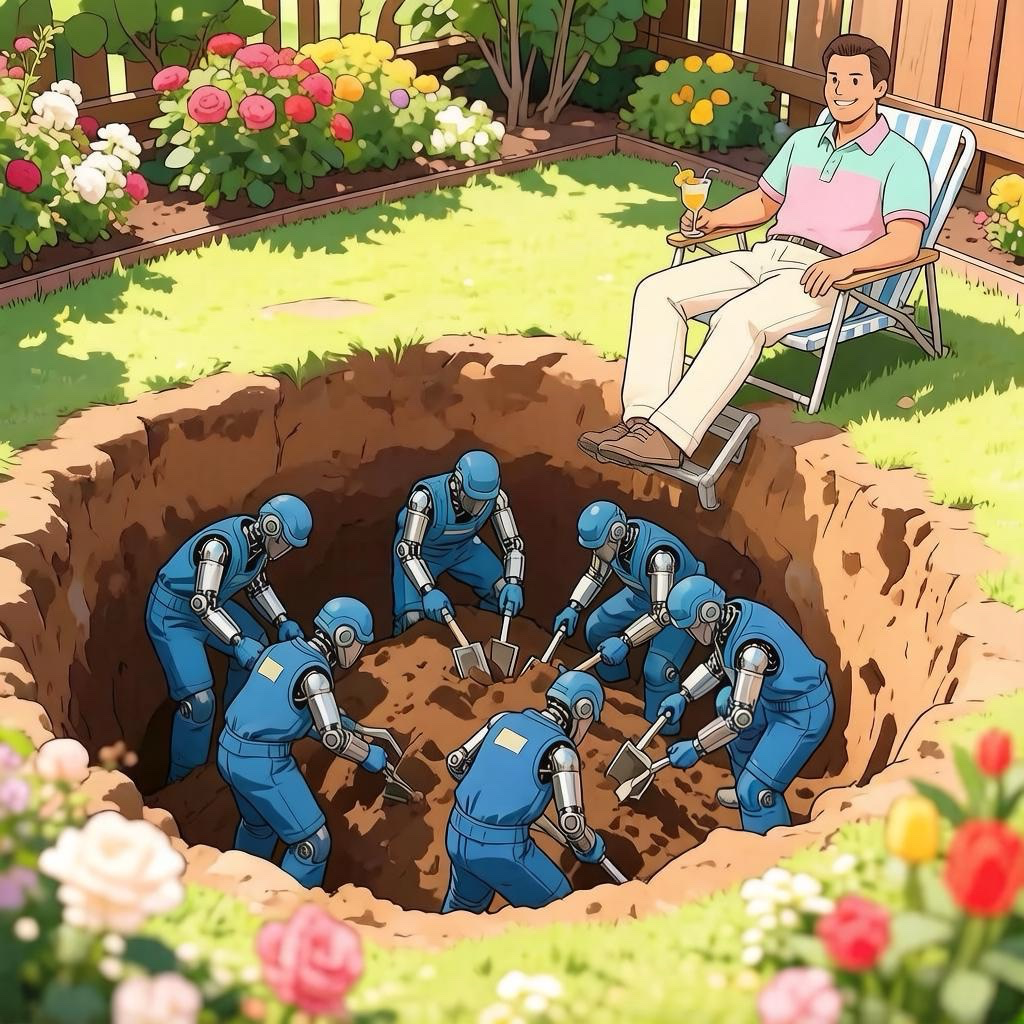
Сейчас, когда примерно для трети наших коммуникаций благодаря ГигаЧату можно генерировать контент и согласовывать только ИИ‑проверками, мы готовы выводить новую роль: ИИ‑валидатор. Это вчерашний контент‑менеджер, задача которого не писать тексты руками, а проверять сгенерированный по бриф‑промпту результат и вносить точечные коррективы там, где это подсказывают ИИ‑проверки. Мем с мужиком в яме вывернулся наизнанку: теперь контент‑менеджер будет сидеть в шезлонге на краю ямы, в которой копошатся ИИ‑агенты.
Скажи мне кто пять лет назад, что работа контент‑менеджера будет, по большому счёту, заключаться в нажатии кнопок «Сгенерировать», «Проверить» и «Выгрузить», я бы вряд ли поверил. Ок, я сильно утрирую — работы ещё полно. В конце концов, не перевелись продукты, для которых ещё можно улучшать качество генерируемых черновиков, проверки следует расширять и совершенствовать, искусственный интеллект должен научиться создавать любые актуальные для нас виды контента, а для ИИ‑юриста открыт безграничный простор нетипового контента, но тем не менее!
То, что нам удалось совершить, — если не революция, то уж точно маленький мятеж против бюрократии и архаичных методов создания коммуникаций. Ни один контент‑менеджер в процессе не пострадал, скорее, наоборот. А главное и самое приятное — это то, что реализовано всё на родном ГигаЧате, в Creator нашей разработки, где генерирующий и все согласующие ИИ‑агенты доступны в едином интерфейсе. Сделано в Сбере — своими собственными руками и мозгами на реальных данных.
Почему ещё это важно
Если что, мы в курсе, что не такие уж уникальные. Бигтехи активно внедряют автосогласование генеративки.
Пару лет назад Amazon запустил ИИ‑генерацию продуктовых описаний для своих продавцов. Загрузил фото — получил готовый листинг. Больше 900 000 продавцов активно используют эту фичу, 90% принимают ИИ‑текст с минимальными правками, время создания карточки сократилось с часов до 15 минут. Звучит как мечта, но есть нюанс: Amazon не отвечает за содержимое перед покупателем — если продавец наврал про вес гантелей, это проблема продавца. Проверки там ровно столько, сколько найдётся места между пальцами алгоритма маркетплейса.
Klarna — шведский финтех, один из пионеров BNPL — сравнительно недавно выкатил внутренний ИИ‑инструмент Copy Assistant. 80% маркетингового копирайтинга теперь генерирует машина, генерируют больше 1000 изображений в квартал, time‑to‑market сократился с шести недель до семи дней, а маркетинговый бюджет срезали на $10 млн в год. Но проверка у них классическая: ИИ пишет, человек проверяет, человек одобряет. Не совсем то же, что у нас — это ближе к ускорению черновика.
Есть и более близкий кейс. Persado — платформа, которая специализируется на ИИ‑генерировании маркетингового контента для регулируемых индустрий. У них встроенная compliance‑проверка: контент проверяют на соответствие более чем 20 регуляторным фреймворкам на этапе генерации (у нас тоже много блокирующих алгоритмов на старте), но не постфактум. Крупный американский банк, который использует Persado, сократил time‑to‑market коммуникаций с 12 недель до 72 часов, отказы в согласовании по compliance‑причинам снизились на 90%, инцидентов после запуска, по утверждению коллег, — ноль. Серьёзный результат. Но это внешний сервис, интегрируемый в CRM, а не родной модуль внутри неё.
И теперь для тех, кто сейчас разминает пальцы и готовится написать комментарии про «очередной пиар Сбера», «ничего нового» и «всё равно всё через согласования».
Мы не купили сторонний сервис и не наняли реализовавший подобное финтех для тайных консультаций. Мы взяли и заменили роли в каскаде — редактор, репутационные риски, юрист, корректор, частично compliance- и риск‑поведение — на три ИИ‑проверки внутри собственной CRM. Это не человек, проверяющий тексты на конвейере, а машина за конвейером, за которой присматривает человек. Он вмешивается, да, но только в критических случаях, когда система сама сомневается. От брифа до выгрузки в CRM — час. Не 72 часа. Не 7 дней. Час.
Точность ИИ‑юриста и Smart ToV — выше 90%, ИИ‑Boost полностью ассистирует контент‑менеджерам без специальной экспертизы. Причём проверки чаще докапываются до несуществующих рисков, чем пропускают реальные. Неприятность эту мы исправим, случаи в конце концов единичные, но для банка это даже не баг — это фича. Лучше перестраховаться, чем объясняться в суде, что вы случайно обещали клиенту доходность, которую не гарантировали.
Конверсия ИИ‑текстов по CTR и CR — на уровне наших копирайтеров. А они, между прочим, очень крутые. Так что это комплимент не столько машине, сколько людям, которые её учили.
Честно: полный E2E‑процесс мы запустили только в прошлом квартале, и пока это работает на 30% SMS и пушей (это то, что сейчас умеет проверять первая итерация ИИ‑юристов), до конца года будет вдвое больше. Не весь объём, не сразу, без фанфар и шампанского. Но даже в этом масштабе — насколько нам известно из публичных примеров — мы одни из немногих, кто заменил каскад согласователей на полную ИИ‑проверку внутри единой платформы. Покидайте в комментарии ваши примеры, было бы очень интересно узнать, кто ещё такое сделал.
Автор: Sber