
Память ИИ агента. Как собрать архитектуру памяти качественно?
Я построил общую память для своих ИИ-агентов. Теперь то, что я рассказал одному, может пригодиться другому — даже в новом разговоре
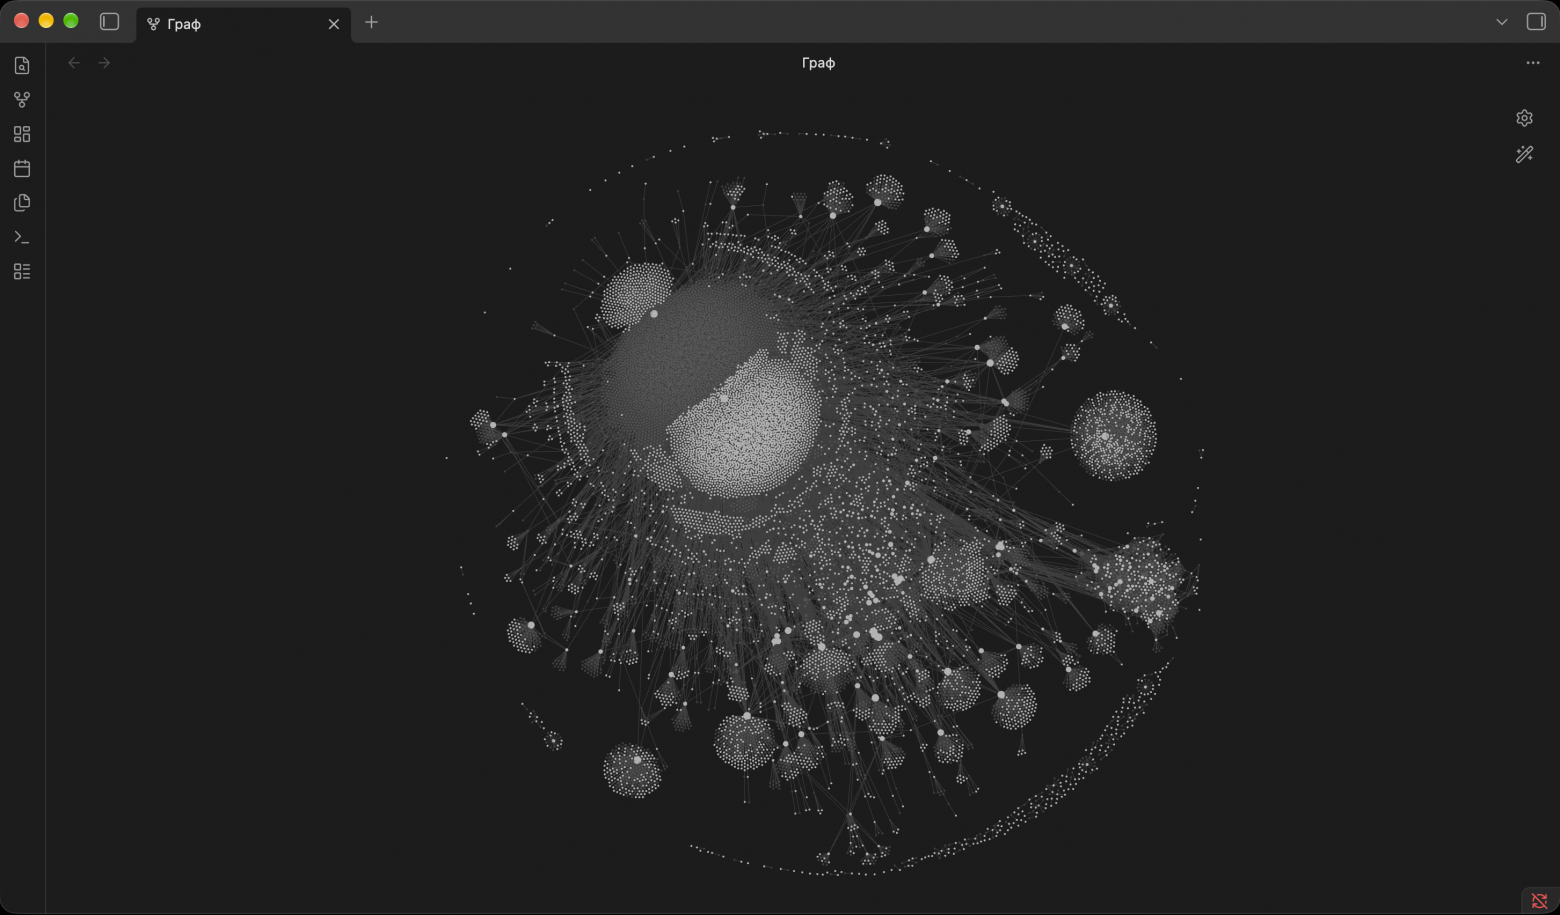
Под капотом — PostgreSQL, граф знаний и поиск по словам, векторам и связям. На момент проверки в графе было больше 10 тысяч узлов. Но количество записей не гарантирует, что агент найдет нужную: однажды поиск зацепился за общее слово и притащил в ответ факты совсем по другой теме
Покажу на коде, как сообщения превращаются в память, как агенты находят нужные сведения и почему иногда находят лишнее
У меня несколько ИИ-агентов. Я общаюсь с ними в Telegram, они работают с разными задачами, но часть знаний у них общая. Захотелось, чтобы факт, сказанный одному агенту, мог использовать другой — без необходимости перед каждым запросом скармливать модели всю историю
В статье — разбор моей системы по коду: как сообщение попадает в память, зачем здесь PostgreSQL и pgvector, как работает поиск по словам, векторам и связям, что происходит при повторной обработке события и почему семантическое сходство нельзя считать доказательством истины. Покажу и ошибку поиска, которую обнаружили на небольшом тестовом наборе
Коротко про масштаб: на момент проверки 8 ноября 2026 года в базе было 10 079 узлов и 13 127 связей; поле embedding было заполнено у всех узлов. Это снимок состояния, а не метрика качества. Кодовые фрагменты ниже взяты из реализации; названия переменных в одном-двух местах сокращены ради читаемости. Пример с решением проекта — вымышленный, реальные данные переписок я не публикую
Почему недостаточно одного summary
При работе с моделью я разделяю четыре вещи:
-
Текущий контекст — сообщения и данные, которые модель видит в этом запросе
-
Короткая постоянная память агента — компактные сведения, нужные ему из разговора в разговор
-
История сессий и архивы — возможность вернуться к исходному диалогу и более старым заметкам
-
Общий граф знаний — извлеченные факты и связи, которые можно искать по запросу
У моего личного агента на Hermes есть две небольшие области постоянной памяти с лимитами 2 200 и 1 375 символов. Это не оперативная память машины и не размер контекстного окна модели. Это ограничение конкретного хранилища постоянных заметок
Часть других агентов ведет собственные файлы памяти и недельные итоги. Они живут отдельно от файлов Hermes и общего графа. Ротация одних файлов не означает, что автоматически ротируется вся система
Summary полезен, когда диалог вырастает, но при сжатии в него может не попасть нужная подробность. Источник остается важен: если на кону решение по проекту, я хочу иметь возможность открыть исходную реплику, а не полагаться только на пересказ
Общая схема
Сообщение пользователя
        │
        ▼
Захват: источник, автор, очистка, удаление старой подкладки
        │
        ▼
Очередь событий
        │
        ▼
Модель извлекает сущности и связи
        │
        ▼
Проверка цитаты + нормализация
        │
        ▼
PostgreSQL: узлы, связи, источник, журнал событий
        │
        ├───────────────┐
        ▼               ▼
Поиск перед ходом    Поиск по запросу агента
лексика / граф /     когда автоподкладки
векторы / морфология недостаточно
        │               │
        └───────┬───────┘
                ▼
Отобранные факты → контекст модели
Покажу путь на вымышленном примере. Допустим, пользователь пишет: «Для проекта Альфа решили запускать отчеты по понедельникам». Затем спрашивает другого агента: «Когда выпускаем отчеты по Альфе?»
Для полезного ответа недостаточно того, что строка существует в базе. Система должна связать проект и решение, сохранить источник, найти запись по новому вопросу и не потерять ее при ограничении выдачи. Если позже расписание меняется, старое решение еще и нужно перестать показывать как актуальное
1. Захват: сначала разобраться, кто вообще это сказал
Для Hermes у меня работает отдельный capture-процесс. Он читает новые пользовательские сообщения из хранилища сессий в режиме read-only и отправляет подходящие события в очередь. Чтение отделено от основного агента: обработчик памяти не должен останавливать разговор или переписывать базу сессий
До извлечения фактов стоят фильтры источника и автора. Сообщение другого бота не должно автоматически становиться словами владельца. Служебные блоки тоже нужно убирать. Особенно — блоки памяти, которые система сама подставила модели на предыдущем ходе
Иначе получается петля:
факт из памяти → подкладка в контекст → захват подкладки
               → «новый факт» → новая подкладка → ...
Поэтому блок с извлеченной памятью удаляется из текста до повторной обработки. На входе также есть очистка некоторых шаблонов секретов. Это полезная страховка, но не доказательство, что любые чувствительные данные будут распознаны и удалены
2. Модель извлекает факт, код проверяет цитату
Дальше модель получает исходный текст и предлагает сущности и связи. Она возвращает не только пересказ, но и цитату, подтверждающую сущность. Проверка в коде выглядит так:
const norm = (s) => String(s ?? '')
  .toLowerCase()
  .replace(/s+/g, ' ')
  .trim();

const dlg = norm(dialogueText);
const grounded = (q) => {
  const n = norm(q);
  return n.length >= 6 && dlg.includes(n);
};

const entities = (Array.isArray(obj.entities) ? obj.entities : [])
  .filter((e) => e && typeof e === 'object' && grounded(e.quote));
Проверка простая: после нормализации цитата должна быть не короче шести символов и встречаться в исходном тексте. Если модель придумала подтверждающую фразу, сущность не проходит фильтр
Но тут важно не переоценивать защиту. Подлинная цитата не доказывает, что модель правильно ее поняла или верно определила категорию. А связи в текущей реализации проверяются структурно — наличие корректных концов и типа связи, — но отдельной проверки цитаты для каждого ребра нет. Поэтому граф может хранить связь, которую еще нужно проверять по источнику
Еще одна неприятная ошибка — записать факт без подписи как сказанный владельцем. В текущем коде отсутствие подписи не превращается автоматически в подтвержденное авторство. Если источник неизвестен, выдавать его за установленный нельзя
3. Паспорт факта: ссылка, автор, время
Для события из Telegram система может сохранить источник: автора, время, идентификатор сообщения и ссылку, если их удалось получить. Это позволяет вернуться от найденного факта к разговору
На примере с проектом Альфа модель может выдать примерно такую структуру:
{
  "entity": "Проект Альфа",
  "fact": "Отчеты выпускаются по понедельникам",
  "quote": "Для проекта Альфа решили запускать отчеты по понедельникам",
  "source": "сообщение пользователя",
  "said_at": "время исходного сообщения"
}
Это схематический пример, а не выгрузка из моей базы и не буквальный JSON формата конкретной таблицы. Его задача — показать, какие вопросы должен выдержать факт: что произошло, на чем основана запись и когда это было сказано
Есть различие и между датой сообщения и датой записи в базу. Если обработка очереди задержалась, подмена одной даты другой исказит хронологию. Аналогично нельзя придумывать ссылку на приватное сообщение там, где Telegram не дает такой адрес
4. Повтор события: почему очередь сама по себе не спасает от дублей
Очередь может доставить событие повторно: процесс упал после записи, а подтверждение обработки потерялось. Если каждый раз безусловно добавлять извлеченные данные, повторы станут частью памяти
У меня идентификатор события регистрируется в той же транзакции, что и запись графа. Фрагмент обработчика:
await client.query('BEGIN');

const claim = await client.query(
  'INSERT INTO processed_events (event_id) VALUES ($1) ON CONFLICT DO NOTHING',
  [eventId]
);

if (claim.rowCount === 0) {
  await client.query('COMMIT');
  // Событие уже обработано: повторно не применяем
  return;
}

// Здесь в той же транзакции записываются данные события,
// узлы и связи. При ошибке транзакция откатывается.
Если регистрация события уже существует, обработчик не применяет его второй раз. Если ошибка произошла до commit, откат убирает и отметку обработки, и изменения графа — событие можно повторить
Это гарантия на уровне применения одного идентификатора события в базе, а не обещание exactly-once для всей распределенной системы. Два разных идентификатора с одинаковым смыслом все равно могут потребовать отдельной дедупликации
5. Почему граф и PostgreSQL находятся вместе
PostgreSQL хранит узлы и связи в обычных таблицах. В узле — категория, название, текст, источник, время, служебные поля доступа и embedding. Отдельная таблица связывает узлы между собой. Отдельно хранятся сведения об обработанных событиях и источниках
Граф в данном случае — это модель связей, а не обязательное требование использовать специализированную графовую СУБД. У нас выбран PostgreSQL; из этого не следует, что он быстрее или лучше графовой базы на любой нагрузке. Такого сравнения я не проводил
8 ноября я проверил живую базу запросом только на чтение:
BEGIN READ ONLY;
SELECT count(*) AS nodes, count(embedding) AS embedded
FROM memory_graph_nodes;
SELECT count(*) AS edges FROM memory_graph_edges;
COMMIT;
Получилось 10 079 узлов, столько же заполненных embeddings и 13 127 связей. Количество узлов не равно количеству независимых подтвержденных фактов: узлы бывают структурными, а один узел может содержать несколько строк. Эти цифры нужны для понимания масштаба снимка, а не для заявления «память работает на 100%»
6. Поиск: слова, морфология, векторы и связи
Когда приходит запрос, читатель ищет кандидатов несколькими способами. В коде есть режимы lexical, graph и full, что позволяет сравнивать вклад компонентов. В полном режиме используется и векторный сигнал
Локальная модель превращает запрос в вектор. PostgreSQL с расширением pgvector выбирает ближайшие узлы по косинусному расстоянию:
SELECT id, (embedding <=> $1::vector) AS dist
FROM memory_graph_nodes
WHERE embedding IS NOT NULL
ORDER BY embedding <=> $1::vector, id
LIMIT $2;
Вектор передается параметром $1, а не собирается из текста пользователя внутри SQL. В текущем читателе проверяется размерность вектора запроса — 384 компонента. Порог и зазор между кандидатами настраиваются; значения по умолчанию в коде — 0,80 для сходства и 0,02 для разницы между лидерами
Зачем вообще зазор? Короткая общая фраза может оказаться похожа сразу на множество записей. Высокий косинус у первого кандидата сам по себе не означает, что именно он отвечает на вопрос. Дополнительный фильтр пытается отсечь диффузный результат, хотя и он не делает поиск безошибочным
Поиск по русским словоформам использует возможности PostgreSQL: to_tsvector('russian', ...) и to_tsquery('russian', ...). Кроме того, есть лексическое сопоставление и обход по связям графа. Если локальный сервис эмбеддингов не ответил вовремя, векторный сигнал пропускается, а остальные пути могут продолжить работу
Важная оговорка: я не называю это RRF или каким-то конкретным алгоритмом слияния только потому, что у нас несколько сигналов. Это нужно доказывать реализацией ранжирования, а не красивым названием
7. Почему 10 000 символов найденного не означают 10 000 полезных
Результат поиска еще должен поместиться в контекст агента. У провайдера Hermes по умолчанию бюджет автоматической подкладки — 2 800 символов, включая служебный заголовок. Это значение можно изменить настройкой; оно не является универсальным лимитом модели
Раньше читатель собирал более длинный результат, а потребитель обрезал его до своего лимита. Факт, находившийся ниже границы, мог исчезнуть независимо от его важности. Теперь читатель заранее получает доступный ему бюджет, а провайдер дополнительно страхуется обрезкой по целой строке и пометкой о сокращении
Это два разных вопроса:
-
нашел ли поиск факт среди кандидатов?
-
увидела ли модель этот факт после ранжирования и ограничения размера?
Метрику качества имеет смысл считать на финальной выдаче, которая действительно попадет в модель. Иначе можно радоваться правильному ответу на позиции, до которой агент физически не добрался
Кроме автоматической подкладки у агента есть отдельный инструмент поиска. Если краткая подборка не ответила на вопрос, он может обратиться к графу еще раз. Отдельно обрабатывается ситуация, когда чтение сломалось: отсутствие результата и ошибка доступа — не одно и то же
Реальная ошибка: нерелевантный запрос разбудил граф
В диагностике от 4 августа 2026 года мы проверяли девять запросов: шесть с ожидаемыми фактами и три намеренно нерелевантных. Каждый прогонялся в трех режимах поиска. Это маленький smoke-тест, а не полноценный бенчмарк
Что увидели тогда:
-
режим
lexical: ожидаемый факт попал в итоговую ограниченную выдачу в 4 из 6 положительных запросов -
режимы
graphиfull: в 5 из 6 -
только один из трех отрицательных запросов дал пустой ответ; два вернули нерелевантные сведения
-
один англоязычный перефраз не вернул ожидаемый факт ни в одном из трех режимов
Причину двух ложных срабатываний удалось локализовать: общий токен в запросе давал слабое совпадение, после чего обход графа расширял набор по соседним узлам. Чем шире обход без достаточной проверки отношения к исходному вопросу, тем легче добавить шум
После этого старого замера код менялся, в том числе механизм работы с бюджетом. Эти цифры нельзя выдавать за качество текущей версии. Полноценный актуальный тест с размеченными вопросами, проверкой утечек и оценкой конечной выдачи я здесь не проводил
Но сам случай хорошо показывает, почему проверка только позитивных запросов недостаточна. Память должна уметь не только находить, но и говорить: «релевантного ничего нет»
8. Устаревание: почему я не удаляю старое решение
Вернемся к вымышленной Альфе. Допустим, сначала отчеты решили выпускать в понедельник, а позже — в среду. Сохранить оба предложения недостаточно: при следующем запросе агент может выбрать старое
В моей системе факт можно пометить устаревшим с указанием основания. Исходный текст при этом остается в базе; пометка обратима. История не исчезает, но старую строку не нужно показывать как действующую
При поиске строки для пометки есть опасная ловушка. Семантически фразы «число семь — актуальное» и «число семь — больше не актуальное» очень похожи. Поэтому смысловой поиск может показать кандидатов, но не должен сам выбрать, какую строку скрыть. Для операции требуется однозначное совпадение; если подходящих строк несколько, система отказывает и просит уточнить
Это не автоматическое разрешение всех противоречий. Решение об устаревании должно иметь основание. В более сложном случае — например, два источника дают разные сроки — одной косинусной близости недостаточно, чтобы определить, кто прав
Безопасность: граница правила не равна изоляции клиента
У правил в графе есть области действия: глобальная, ролевая, конкретного агента и временная. Читатель отфильтровывает неподходящие правила до выдачи агенту. Но это утверждение относится именно к механизму правил. Оно не доказывает, что все категории общей базы автоматически изолированы по клиентам
Для клиентских данных нужно отдельно проектировать и проверять границы: какой компонент пишет данные, кто читает, как устроены доступы к базе и бэкапам, что попадает в логи и какие данные уходят во внешнюю модель. Фильтр секретов на входе и метка в одной таблице не заменяют такую проверку
Я намеренно не привожу реальные сообщения, адреса серверов, идентификаторы чатов и учетные данные. Для обсуждения архитектуры они не нужны
Что я бы проверял в системе памяти
Если собирать похожую систему, я бы тестировал не только вопрос «она что-то нашла?», но и отдельные сбои на каждом этапе:
-
Захват: правильно ли определен автор и не попадают ли в очередь служебные подкладки
-
Извлечение: что происходит, если модель вернула невалидный JSON, неподтвержденную цитату или неверную связь
-
Повтор: что будет при падении до commit и повторной доставке того же event ID
-
Поиск: точные запросы, перефразы, вопросы через связи и отрицательные примеры, где правильный результат пустой
-
Бюджет: остался ли нужный факт в конечной выдаче, а не только в полном списке кандидатов
-
Актуальность: можно ли отличить новое решение от старого и вернуться к источнику
-
Доступ: видит ли агент только те сведения, которые ему разрешены, в том числе при сбое и повторе
-
Наблюдаемость: отличает ли система пустой поиск от таймаута, зависшей очереди или отсутствия соединения
Итог
Моя память агентов — это не одна векторная база. Это путь от исходного сообщения и определения автора до извлечения, записи, поиска, ограничения выдачи и проверки актуальности. Граф помогает связать сведения между агентами, а источник позволяет вернуться к тому, что действительно было сказано
Система полезна ровно настолько, насколько она способна принести нужное и не подсунуть устаревшее или чужое. Чем дольше агенты работают, тем важнее проверять не только объем накопленной памяти, но и то, как именно она используется
При проектировании архитектуры ИИ-системы я закладываю память вместе с остальными компонентами. Постепенно из источников и принятых решений собирается база знаний — то, что я называю вторым цифровым сознанием
Материалы
Автор: MatIntellect