
Контекст ИИ-агентов: что хранить, что читать и чему доверять
После моего переезда с Claude Code на Codex на Хабре разгорелся спор: нужна ли история диалогов, если есть Git, документация и спецификации? Я изучил аргументы, инструменты и исследования. Оказалось, проблема гораздо шире.
В начале ноября я рассказал на Хабре, как после блокировки платной организации Claude Code перешёл на Codex и попытался сохранить историю проектов.
Код остался на компьютере, репозитории никуда не исчезли. Но за несколько месяцев накопились десятки разговоров об архитектуре, ошибках, экспериментах и планах. Далеко не всё попадало в документацию.
Штатный импорт в Codex оказался неудобным: из 25 проектов и 53 чатов около 50 сессий удалось перенести, но привязка переписок к проектам получилась неудачной. В итоге я нашёл Hansard и стал обращаться к старой истории через поиск.
Думал, на этом история закончится. Однако в комментариях начался спор.
greenrus предложил хранить решения и планы в Git. mist56 напомнил про skills, KB и документацию, а затем указал на количество мусора в старых диалогах. becefi поднял вопрос о переносе состояния рассуждений и различиях между протоколами моделей.
Другие читатели поделились собственными системами памяти и управления агентами. А RouR написал отдельную статью «Контекст должен быть в репозитории, а не в чате», где описал GRACE и doubled-graph.
Я начал изучать эти подходы и понял, что мы часто спорим о разных задачах.
Сохранить историю, передать незавершённую работу и предоставить агенту достоверные знания — не одно и то же.
Контекст — это не один большой файл
Допустим, новый агент впервые открывает существующий проект. Ему нужно понять архитектуру, ограничения и текущее состояние работы.
Но информация об этом находится в разных местах.
|
Источник |
Что содержит |
Когда полезен |
|---|---|---|
|
Код и тесты |
Реализацию, зависимости, поведение |
Разобраться в текущей системе |
|
Документация и спецификации |
Требования, архитектуру, принятые решения |
Понять, как система должна работать |
|
Рабочие планы |
Выполненные шаги, открытые вопросы, результаты |
Продолжить задачу |
|
История сессий |
Обсуждения, эксперименты, отвергнутые варианты |
Восстановить прежний опыт |
|
Процедурная память |
Проверенные приёмы и способы диагностики |
Не повторять прежние ошибки |
|
Состояние выполнения |
Контрольные точки, результаты команд |
Возобновить прерванный процесс |
Код показывает, что реализовано сейчас, но не обязательно объясняет, почему выбрали такую архитектуру. Документация может содержать причины, если их записали и своевременно обновляли. История разговоров сохраняет больше подробностей, однако вместе с ними — ошибочные гипотезы и устаревшие сведения.
Поэтому задача не в том, чтобы заставить агента прочитать всё.
Нужно выбрать подходящий источник и определить, насколько полученной информации можно доверять.
Актуальный проект: документация, спецификации и сам код
Здесь у критиков моего первоначального подхода сильный аргумент.
Новый разработчик не начинает работу с чтения всей истории проекта. Ему дают карту системы, инструкции и конкретную задачу. Остальные материалы он изучает по мере необходимости.
Для ИИ-агента логично поступать аналогично.
В небольшом проекте часто достаточно AGENTS.md или CLAUDE.md, актуальной документации, ADR, рабочих планов и тестов.
Но Git сам по себе не является системой памяти. Это контроль версий: в репозитории можно хранить спецификации, решения, планы и даже историю сессий. Важнее содержание и актуальность этих материалов.
Когда исходников слишком много
Отдельная проблема — навигация по большой кодовой базе.
Aider Repo Map формирует компактную карту структуры проекта, учитывая бюджет токенов. В статье «Codebase Intelligence для агента» рассматривается поиск и индексация Rails-монолита размером более 3,5 млн строк.
Структурная навигация, связи между символами и семантический поиск позволяют не читать сотни файлов ради одного изменения.
Однако даже идеально найденный участок кода не обязательно объяснит историю принятого решения.
Как не довериться устаревшей документации
Допустим, архитектурный документ утверждает, что два модуля независимы, а в коде между ними уже появилась связь.
Агент может прочитать документ и предложить изменение, основанное на устаревшей информации.
OpenSpec и GitHub Spec Kit помогают организовывать работу через требования, спецификации и планы.
RouR в своей статье описывает GRACE и doubled-graph, сопоставляющий заявленную архитектуру со структурой реального кода.
Такая проверка потенциально позволяет обнаруживать архитектурные расхождения. Но совпадение графов не гарантирует правильного поведения программы, а спецификации и контракты требуют сопровождения.
Для большого проекта это может быть оправданно. Для небольшой утилиты — оказаться избыточным.
Главное здесь не выбор конкретной методологии, а принцип: актуальные знания желательно проверять по независимому источнику — коду, тестам или результатам выполнения.
Историческая память: Hansard и deja-vu
Вернусь к собственному сценарию.
Блокировка Claude Code произошла неожиданно. Многие решения существовали только в предыдущих разговорах. Подготовить полный комплект документов для миграции я заранее не успел.
Здесь пригодился Hansard. Он позволяет искать по сохранённым сессиям разных агентов, обращаться к ним через Recall и продолжать работу в другом агентном окружении.
Пример из NetRuleRouter
Сейчас я продолжаю разработку NetRuleRouter — программы маршрутизации трафика через разные подключения.
При расследовании проблемы Windows TUN с ошибкой 5010 агент сообщил:
Hansard подтвердил TUF как выделенный Windows-ноутбук и локальную копию репозитория на нём.
После этого агент обозначил необходимость проверить логи и жизненный цикл TUN/маршрутов, прежде чем менять код. Сведения о тестовом ноутбуке и условиях воспроизведения ошибки не обязательно относятся к архитектурной документации. Но при диагностике они могут быть полезны.
При этом я пока не могу утверждать, что Hansard ускорил исправление ошибки. Для такого вывода нужно проверить сам запрос Recall, найденные источники и влияние сведений на дальнейшие действия.
Этот эпизод показывает возможную пользу исторического контекста, но ещё не является измерением эффективности инструмента.
Чем интересен deja-vu
Ещё один проект — deja-vu от VShulcz. Он индексирует локальные журналы кодинг-агентов и предоставляет поиск через CLI, MCP и другие интеграции.
Особенно интересны функции с привязкой к разработке:
-
deja wip— восстановление незавершённой работы; -
deja blame— поиск исторических сессий, связанных с файлами; -
deja fix— поиск прежних действий после похожих ошибок; -
статусы решений, включая отвергнутые;
-
предупреждения об изменении файлов после найденного обсуждения.
Последние возможности помогают не просто находить старые рекомендации, но и оценивать, насколько они ещё применимы. Например, если найденное исправление относится к модулю, который впоследствии переписали, это повод дополнительно проверить результат поиска. А отсутствие повторения ошибки в старом журнале ещё не доказывает, что именно найденное действие её устранило.
Сам deja-vu я пока не тестировал. Hansard уже закрывает мою текущую потребность, поэтому устанавливать второй индексатор только ради обзора не собираюсь.
Когда история помогает спецификациям
Интересная деталь: расширение deja-vu session recall уже включено в каталог сообщества GitHub Spec Kit. Его заявка была закрыта 5 ноября 2026 года.
Расширение использует текущие spec.md и plan.md для поиска по старым сессиям: что раньше пробовали, какие решения отвергли и какие файлы менялись.
При этом попадание в каталог сообщества не означает, что сопровождающие Spec Kit проверили или одобрили качество кода расширения. Каталог подтверждает корректность оформления записи, а не результаты независимого аудита. Но сам механизм интересен.
Спецификация определяет текущую задачу, а архив помогает не повторять уже пройденные эксперименты.
Здесь история и документация не конкурируют, а дополняют друг друга.
Передача незавершённой работы и координация агентов
Теперь другой сценарий. Claude Code исправляет ошибку, выполняет команды, меняет файлы. В этот момент заканчивается лимит. Можно заранее попросить подготовить HANDOFF.md, но если работа уже прервалась, такой возможности может не быть.
Для подобных ситуаций разработан baton, описанный в статье «Перенос сессий между консольными ИИ-агентами без потери контекста». Он читает существующие журналы, подготавливает материалы для продолжения работы и может переносить локальные изменения между компьютерами.
Hansard тоже поддерживает продолжение работы в другом агенте. Поэтому сравнивать такие решения нужно не по наличию функции «Continue», а по тому, какие данные реально передаются: история сообщений, результаты инструментов, изменённые файлы, рабочий план, ссылки на источники. При этом сохранённый журнал не равнозначен переносу внутреннего состояния модели. Thinking blocks, особенности кэширования и протоколы разных провайдеров не гарантируют идентичного продолжения рассуждений.
У оркестраторов существует и другой механизм. Например, LangGraph разделяет контрольные точки выполнения и долговременные хранилища знаний. Контрольная точка позволяет продолжить процесс из известного состояния. Историческая память помогает восстановить прошлый опыт. В одном продукте могут использоваться оба подхода.
Когда исполнителей несколько
В комментариях anikin-v описал собственную практику: рабочие папки задач с планами, гипотезами и промежуточными результатами. Агент обновляет их сам либо по команде.
Особенно интересна другая часть его опыта. Для длительных задач он иногда использует отдельного агента-контролёра, который не пишет код. Тот следит за планом, готовит задания исполнителям, фиксирует результаты и организует передачу работы. По сути, получается небольшая виртуальная команда.
Похожие проблемы решают Beads и SpecWithCode, о котором рассказал aabyzov.
Ещё один пример — мультиагентная OpenIDE, позволяющая создавать отдельные ветки обсуждений, передавать задачи разным агентам и возвращать результаты проверки в основной разговор.
Здесь важно уже не просто хранить память, а управлять потоками контекста между исполнителями.
Но структурированная передача тоже не исключает ошибок. Контролёр может неправильно понять отчёт, а выжимка — потерять значимую деталь.
Автоматическая память: записать — не значит вспомнить
Между полным архивом и вручную поддерживаемыми документами есть системы автоматического извлечения знаний.
Claude-Mem, kaeru и skillmem используют разные механизмы сохранения наблюдений, решений и повторно применимых приёмов.
Но здесь возникают две проблемы: когда обращаться к памяти и как определять достоверность найденного.
Цена памяти, которой не пользуются
В статье «Записать — не значит вспомнить» автор описал эксперимент с MemShelf. На 38-й день работы системы индекс и дайджесты 157 сохранённых эпизодов занимали около 36,6 тысячи токенов — 18,3% окна в 200 тысяч.
В другом срезе — за отдельно проанализированные 30 дней — автор не обнаружил вызовов MCP-инструментов MemShelf и DocShelf. При этом к архиву он обращался вручную.
Эти измерения нельзя напрямую объединять в одну статистику эффективности. И отсутствие вызовов MCP не доказывает бесполезность всей памяти: сведения могли поступать в контекст другими способами.
Однако проблема хорошо видна. Постоянно загружаемая память способна занимать значительную часть окна без соответствующей пользы от поиска.
Разработчики kaeru столкнулись с похожим вопросом. Они изучили более 13 тысяч файлов логов; в одном небольшом наблюдении агенты за семь сессий ни разу не воспользовались необязательным предложением прочитать сохранённые рассуждения.
Семь сессий — слишком мало для общих статистических выводов, но сама проблема понятна. Агент может иметь доступ к памяти и не обращаться к ней. Или наоборот — система будет подмешивать историю слишком часто, расходуя токены и загрязняя рабочий контекст.
MCP предоставляет интерфейс вызова. Хуки, инструкции и skills могут управлять моментом обращения. Но ни один из механизмов сам по себе не гарантирует релевантность результата.
Контекстное окно тоже нужно контролировать
В материале Effective context engineering for AI agents Anthropic рассматривает сжатие истории, очистку результатов инструментов, выборочное чтение файлов и изоляцию работы субагентов.
Это не то же самое, что долговременная память. Сжатие освобождает место, но может потерять подробности. Очистка результатов команд уменьшает объём контекста, однако иногда требует повторных вызовов. Субагенты позволяют не переносить все промежуточные рассуждения в основную сессию.
Поэтому увеличение контекстного окна само по себе не решает задачу управления знаниями.
А если память сохранила ошибку?
Допустим, агент сделал неправильный вывод и записал его как полезный опыт. Позже другой агент извлекает эту запись и принимает за подтверждённое решение. Получается накопление ошибок.
Поэтому полезно хранить не только содержание записи, но и её источник, дату, статус, условия проверки и связь с текущим кодом.
Особенно важно различать гипотезы, подтверждённые результаты, отменённые решения и сведения с неизвестной достоверностью.
Есть и вопрос безопасности. Старый диалог может содержать инструкции, которые когда-то относились к другой задаче или были получены из недоверенного источника. Если агент начинает исполнять их при чтении архива, историческая память превращается в канал передачи нежелательных команд.
Поэтому найденные разговоры нужно рассматривать как данные о прошлом, а не как новые инструкции к выполнению.
От исторического обсуждения к проверенному решению
После знакомства с разными инструментами я сформулировал для себя простой порядок работы.
Допустим, агент нашёл старое обсуждение исправления ошибки TUN. Сразу применять найденное решение рискованно. Сначала нужно установить источник и дату обсуждения. Затем понять, была ли это гипотеза, подтверждённый результат или отвергнутый вариант.
После этого — сверить найденное с текущим кодом, документацией и тестами. И только после проверки использовать решение или отказаться от него. Если удалось установить что-то важное, результат стоит зафиксировать в актуальном рабочем плане, ADR или KB. Получается последовательность:
Найти → установить статус → проверить актуальность → применить и проверить → зафиксировать результат.
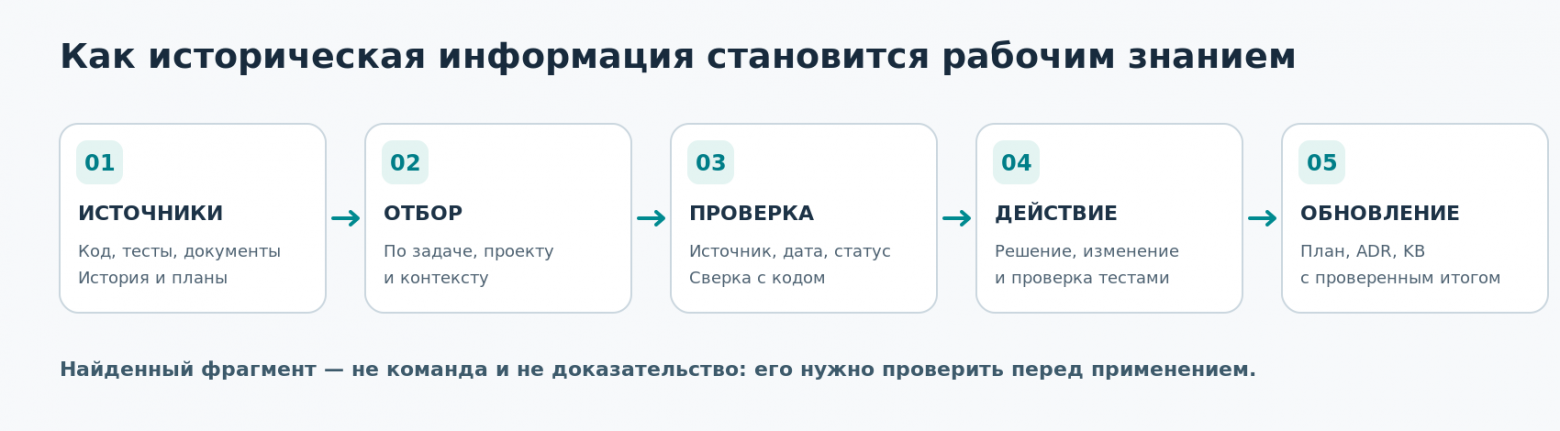
Здесь архив и документация выполняют разные роли.
Архив сохраняет свидетельства прошлого. Актуальная база знаний фиксирует сведения, на которые проект может опираться сейчас.
Причём последняя тоже требует проверки и обновления.
Как понять, помогает ли память на самом деле?
Большинство рассмотренных инструментов я изучал по документации и публикациям авторов. Полноценного сравнительного тестирования пока не проводил. И одного вопроса «нашёл или не нашёл?» для такого теста недостаточно.
Полезную основу предлагает исследование LongMemEval, ICLR 2025. Его критерии можно адаптировать к разработке:
|
Способность |
Пример проверки |
|---|---|
|
Найти информацию |
Восстановить обсуждение старой ошибки |
|
Связать несколько сессий |
Собрать причины архитектурного решения |
|
Учесть время |
Определить, какое решение действовало тогда |
|
Обновить знания |
Не использовать отменённую рекомендацию |
|
Признать отсутствие данных |
Сообщить, что подтверждений недостаточно |
Сам LongMemEval предназначен для долговременной памяти диалоговых ассистентов. Поэтому его результаты нельзя напрямую переносить на кодинг-агентов.
Но появилось и более близкое к программированию исследование.
VibeMemBench: помогает ли память действительно исправлять код?
В сентябре 2026 года авторы VibeMemBench предложили оценивать память на реальных задачах изменения репозиториев. В исследование вошли 111 задач из 90 репозиториев и 3634 исторические траектории работы. Успешность определялась исполняемыми тестами, а не только правильностью пересказа прошлого.
Авторы сравнивали работу агентов без памяти, с непосредственно предоставленным ранее проверенным опытом и с системами, которые должны были самостоятельно извлечь этот опыт из истории.
Результат оказался показательным.
Непосредственная передача проверенного опыта улучшила выполнение задач у четырёх из пяти протестированных исполнителей. Однако в 11 из 12 сочетаний агента и системы памяти автоматическое извлечение опыта не превзошло соответствующий вариант без памяти.
Это не означает, что системы памяти бесполезны. Задачи в бенчмарке были специально отобраны с учётом полезности исторического опыта в контрольных условиях, а проверялись конкретные реализации и модели.
Но исследование показывает существенный разрыв между двумя возможностями:
Полезный опыт существует в истории — и система действительно способна вовремя извлечь его так, чтобы агент лучше выполнил задачу.
Для меня это главный аргумент в пользу проверки не только точности Recall, но и конечного результата разработки.
Как проверить на собственном проекте
Для практического эксперимента я бы взял реальный проект, в котором за несколько месяцев обсуждались разные способы решения задачи.
Одному агенту предоставил бы актуальный репозиторий и документацию. Второму — дополнительно архив истории. Третьему — заранее подготовленную проверенную выжимку.
Затем сравнил бы правильность решений, источники, расход токенов, время и объём ручной подготовки.
Передачу прерванной сессии и работу нескольких агентов пришлось бы проверять отдельно: это другие задачи. Пока таких измерений нет, объявлять один инструмент победителем было бы преждевременно.
Какой подход выбрать
После изучения разных решений у меня получилась такая таблица.
|
Ситуация |
С чего начать |
|---|---|
|
Небольшой проект одного разработчика |
|
|
Большая кодовая база |
Структурная навигация и поиск по коду |
|
Долгоживущий проект |
ADR, спецификации, проверки соответствия коду |
|
Несколько параллельных агентов |
Единое состояние задач и координация |
|
Прерванная работа |
Handoff, журналы, контрольные точки |
|
Потеря доступа к прежнему агенту |
Архив локальных сессий и исторический поиск |
|
Повторяющиеся ошибки |
Проверенная процедурная память |
|
Устаревшие решения в памяти |
Статусы, источники и сверка с актуальным проектом |
Необязательно устанавливать всё перечисленное.
У меня сейчас Hansard закрывает практическую задачу поиска по истории, поэтому deja-vu я оставил в списке альтернатив.
Дополнительные индексы, MCP-серверы и хуки тоже требуют сопровождения и могут дублировать друг друга.
Выбирать инструмент разумнее под конкретную проблему, а не по количеству функций.
И ещё о конфиденциальности
Локальный архив не обязательно означает полностью локальную обработку.
Если облачный агент получает через Recall исторический фрагмент, он может передать его провайдеру модели вместе с запросом.
Кроме того, журналы способны содержать конфигурации, рабочие пути, внутренние сведения и секреты.
Поэтому важно проверять, какие данные индексируются, куда они передаются, что исключается из хранения и как удаляются записи.
Точно так же размещение документации в Git не гарантирует её безопасности или актуальности.
К чему я пришёл
Началась эта история с простой задачи: после блокировки Claude Code сохранить возможность продолжать разработку в Codex.
Но благодаря обсуждению выяснилось, что под памятью ИИ-агентов скрывается целый набор инженерных проблем.
История диалогов помогает восстанавливать прежний опыт. Документация и спецификации описывают актуальные знания. Рабочие планы позволяют передавать задачи. Оркестраторы управляют несколькими исполнителями. Автоматическая память пытается извлекать и сохранять полезный опыт.
У каждого подхода свои ограничения.
Архив может возвращать устаревшие сведения. Документация — отставать от кода. Агент-контролёр — ошибаться при подготовке выжимки. А система автоматической памяти — исправно сохранять информацию, которой никто не пользуется.
Поэтому для меня главный вопрос теперь не в том, сколько данных способен запомнить агент.
Важнее, сможет ли он вовремя найти нужные сведения, проверить их и принять правильное решение.
Спасибо mist56, greenrus, anikin-v, becefi, aabyzov, TheHost и другим участникам обсуждения моей предыдущей статьи.
Отдельное спасибо RouR за самостоятельную публикацию с альтернативным подходом, а также авторам инструментов и исследований, которые делятся не только идеями, но и исходниками, методиками и результатами.
А мне интересно: как вы проверяете, что память вашего ИИ-агента действительно помогает разработке, а не просто хранит всё больше информации?
P.S> Пока разбирался со всеми этими подходами, сам уже начал внедрять XERJ в свои проекты — локальный поисковый движок для работы с кодом, документацией и другими данными.
Так что до сравнительных экспериментов с остальными системами памяти руки, скорее всего, дойдут не скоро. Пока интереснее посмотреть, как всё это работает в реальной разработке, а не в искусственных тестах. К результатам сравнения, возможно, вернусь позднее.
Автор: krox