
Одинаковые слоты в онлайн-записи — это скрытая переработка: считаем на симуляции
У нас сервисная сеть: тридцать две точки, семь городов, порядка ста десяти тысяч обслуженных клиентов в прошлом году. Клиент попадает к нам через шесть входов — форма на сайте, карточки в картографических сервисах, соцсети и телефон администратора, — и вот что мы увидели, когда впервые посмотрели на распределение по времени суток: около пятнадцати процентов броней ставится ночью, при закрытом салоне, и ещё примерно треть приходит с мобильных. Складывается почти половина записей, которые человек на нашей стороне не создаёт и не проверяет: клиент сам тыкает в свободную клетку сетки.
Это и есть место, где мы наступили на грабли, о которых дальше пойдёт речь. Сетка у нас, как почти у всех сервисов, была равномерная — слоты по два часа. Выглядит логично: удобно рисовать, удобно объяснять, удобно считать. Только в сервисе, где длительность обслуживания отличается в четыре раза от клиента к клиенту, равномерная сетка работает как сглаживание: она не убирает разброс, а прячет его — и он вылезает переработкой мастеров и дырами в расписании.
Ниже — модель этой задачи, симуляция на 2000 дней и числа, которые из неё выпадают. Скрипт целиком в конце, менять там надо ровно шесть констант.
Почему слот не равен слоту
Первое, что удивляет людей со стороны: длительность визита в груминге почти не зависит от размера животного. Она зависит от структуры волоса.
Гладкошёрстную таксу нужно помыть, высушить и сделать гигиену — сорок пять минут. Померанского шпица того же веса нужно вычесать, промыть в два захода, высушить с одновременным вытягиванием волоса и только потом оформить — почти три часа, причём сушка занимает больше времени, чем работа ножницами. Пуделя строят ножницами по всей площади: полтора-два с половиной часа в зависимости от стрижки.
Вот наблюдаемые средние по нашим салонам и доли этих типов в потоке записей:
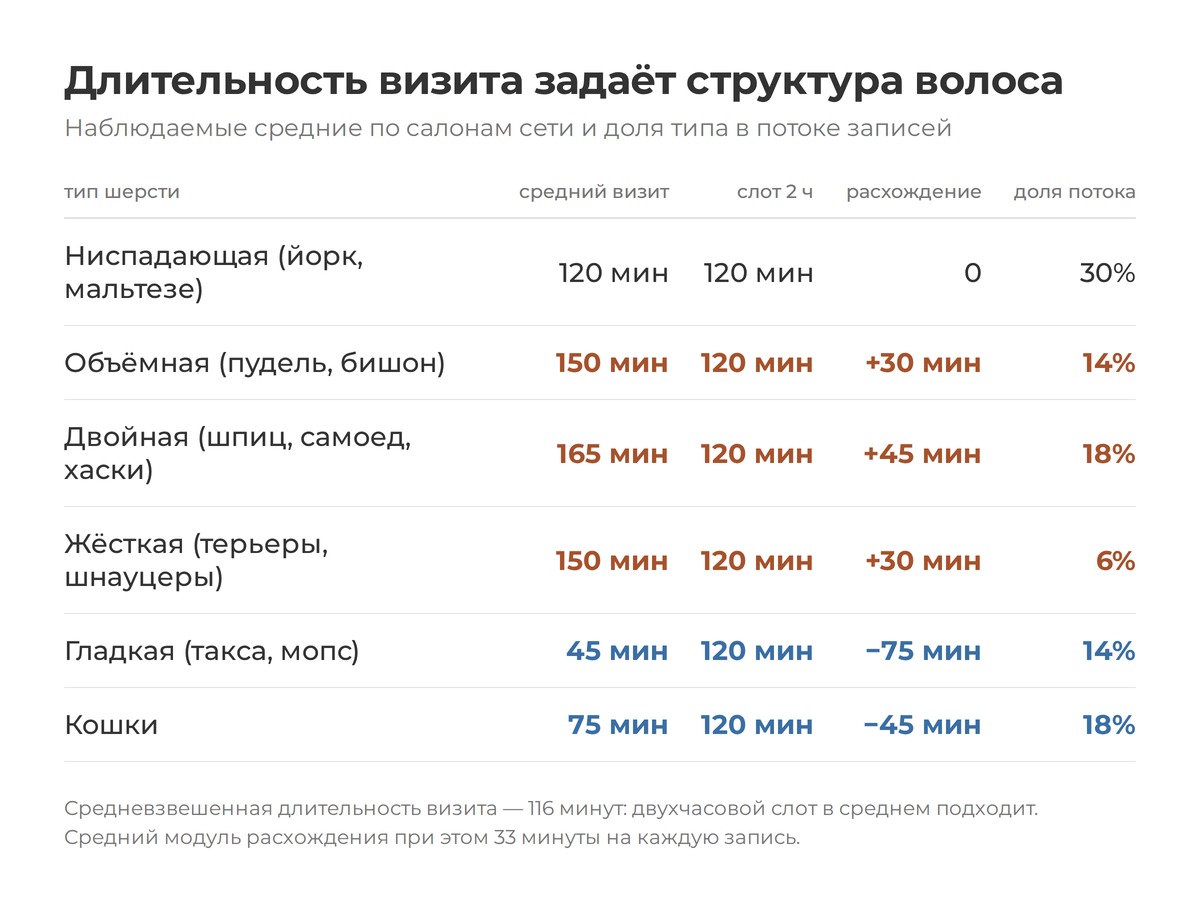
Те же числа лежат в константе ТИПЫ в коде ниже — их удобно скопировать и заменить своими.
Средневзвешенная длительность визита — 116 минут, то есть двухчасовой слот выбран не с потолка: в среднем он подходит. Но средний модуль расхождения — 33 минуты на каждую запись. Половина визитов не добирает до слота, половина из него вылезает, и «в среднем сходится» здесь — ровно та формулировка, из-за которой задачу и не замечают.
Модель
Симулируем рабочий день салона.
-
Три мастера, смена двенадцать часов (10:00–22:00).
-
Поток заявок за день задаём числом: 12, 15 или 18.
-
Тип каждой заявки разыгрывается по долям из таблицы выше.
-
Фактическая длительность визита — нормальная величина вокруг среднего типа, усечённая снизу третью среднего и сверху двумя средними: собака попалась спокойная или, наоборот, всё оказалось хуже, чем на осмотре.
-
Заявка уходит к мастеру с наименьшей забронированной загрузкой; если слот не влезает в смену, запись не принимается.
Сравниваем две сетки:
A. Равные слоты по два часа. Клиент выбирает любой свободный двухчасовой слот независимо от того, кого он привезёт.
B. Слот по типу шерсти. Длительность подставляется системой в момент записи из пары «услуга + порода» и округляется вверх до пятнадцати минут.
Метрики считаем три:
-
загрузка — доля полезной работы в фонде рабочего времени смены;
-
простой — минуты внутри смены, когда мастер свободен, потому что следующий слот ещё не начался;
-
переработка — минуты за пределами смены, когда мастер доделывает начатое.
Последняя метрика и есть то, ради чего всё считалось: в сервисе она оплачивается не деньгами, а текучкой.
Результаты
Один и тот же сид, один и тот же поток заявок, разные сетки. 2000 прогонов на каждую точку.
|
Заявок в день |
Сетка |
Загрузка |
Простой |
Переработка |
Принято |
Отказ |
Дней с переработкой |
|---|---|---|---|---|---|---|---|
|
12 |
A. равные 2 ч |
63,9% |
153 мин |
0,5 мин |
12,0 |
0 |
2% |
|
12 |
B. по типу |
63,9% |
70 мин |
0,2 мин |
12,0 |
0 |
1% |
|
15 |
A. равные 2 ч |
80,1% |
171 мин |
17 мин |
15,0 |
0 |
27% |
|
15 |
B. по типу |
79,8% |
78 мин |
7 мин |
14,96 |
0,04 |
16% |
|
18 |
A. равные 2 ч |
96,1% |
195 мин |
110 мин |
18,0 |
0 |
78% |
|
18 |
B. по типу |
90,6% |
82 мин |
29 мин |
17,14 |
0,86 |
49% |
Что здесь важно.
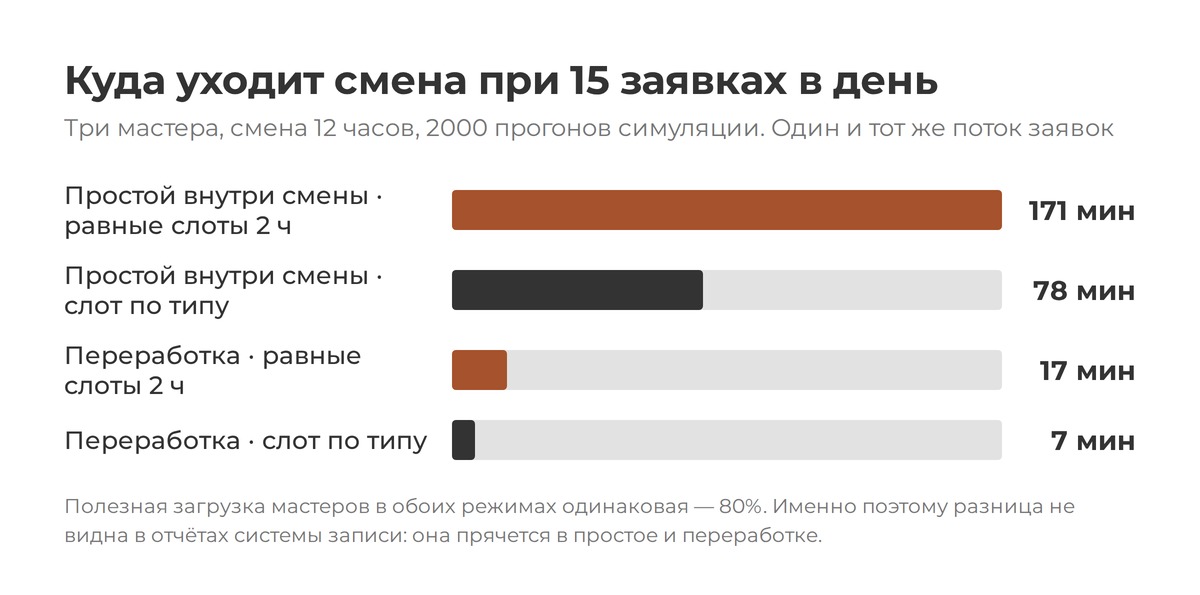
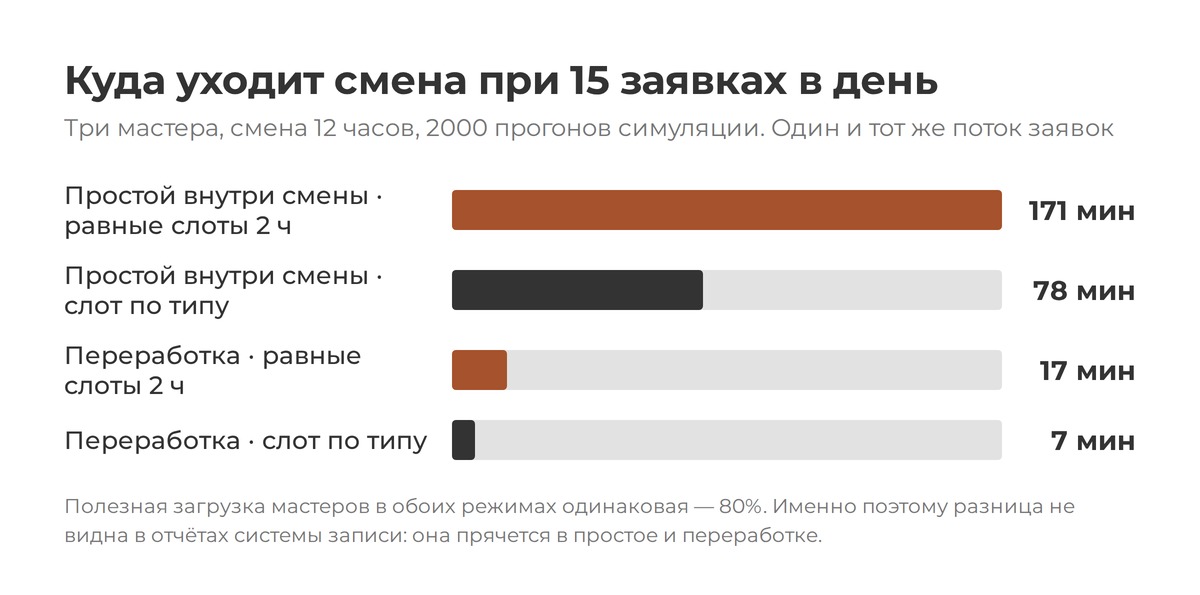
Загрузка почти не отличается. Именно поэтому задача годами не видна из отчётов: если смотреть на процент занятости мастеров — а это первое, что показывает любая система записи, — две сетки выглядят одинаково. Разница прячется в двух других колонках.
Простой отличается вдвое с лишним. 153 минуты против 70 при двенадцати заявках, 171 против 78 при пятнадцати. Это не абстракция: это два часа в день, за которые мастеру платят и в которые он ничего не делает, потому что следующая запись начнётся в 16:00, а он освободился в 15:05.
Переработка отличается в разы. При пятнадцати заявках — 17 минут против 7 в день, при восемнадцати — 110 против 29. И, что важнее среднего, меняется частота: на плотном дне равная сетка даёт переработку в 78% дней против 49%.
И самое неприятное. При восемнадцати заявках сетка B отказывает в среднем 0,9 заявки в день, а сетка A — ни одной. Со стороны бизнеса это выглядит как проигрыш: одна потерянная запись. На деле это честность: заявка, которую сетка B не приняла, в сетке A принимается и превращается в два часа переработки. Пропускную способность равномерная сетка не увеличивает: она лишь перекладывает превышение на людей.
Причём тут ночные записи
Пока запись создаёт администратор, разницы между сетками почти нет: он знает породу, знает мастера и руками ставит нужное время. Модель выше описывает мир, в котором так и происходит — с одной поправкой: у нас почти половина записей создаётся без него.
Отсюда практическое требование к системе, которое звучит скучно, а стоит дорого: длительность должна выводиться из услуги и породы в момент выбора слота, а не подставляться администратором постфактум. Иначе ночной клиент выбирает двухчасовое окно под самоеда, и утром администратор либо звонит и переносит, либо оставляет как есть и закладывает переработку.
Второй вывод из той же точки: если каналов записи несколько — сайт, карты, соцсети, — все они должны писать в одну очередь, а не в свои. Иначе к неверной длительности добавляется двойная запись на одно место, и здесь страдает уже не экономика, а клиент, который приехал зря.
Чего модель не умеет
Раздел, ради которого стоит читать любую симуляцию.
Нет очереди с ожиданием. У нас запись, а не живая очередь: заявка либо помещается в сетку, либо не принимается. Классическая теория массового обслуживания сюда прикладывается плохо — там клиент ждёт, здесь он уходит.
Нет перерывов, уборки и дезинфекции между животными. В реальности это 10–15 минут, которые съедают часть «простоя» из таблицы. То есть разрыв между сетками в жизни меньше, чем в модели, — но он не исчезает, а сдвигается.
Нет распределения заявок по времени дня. У нас поток равномерный, а в жизни он двугорбый: утро и вечер плотнее середины дня. Это скорее усиливает эффект, потому что переработка накапливается именно на вечернем горбу.
Нет привязки мастера к типу. В модели любой мастер делает любую собаку с одинаковым средним. В салоне это не так: у кого-то быстрее идут пудели, у кого-то кошки.
Нормальное распределение — допущение. Логнормальное было бы честнее: длительность не бывает отрицательной, а правый хвост у неё длиннее. Мы взяли усечённую нормаль ради читаемости кода; на порядок величин это не влияет, проверяли заменой распределения.
Код целиком
import random
import statistics
from dataclasses import dataclass

СИД = 20260917
МАСТЕРОВ = 3
СМЕНА = 12 * 60        # минут
ДНЕЙ = 2000
РАВНЫЙ_СЛОТ = 120      # «универсальная» сетка в режиме A
ОКРУГЛЕНИЕ = 15        # шаг сетки в режиме B

# тип → (среднее время визита, стандартное отклонение, доля в потоке)
ТИПЫ = {
    "ниспадающая": (120, 25, 0.30),
    "объёмная":    (150, 30, 0.14),
    "двойная":     (165, 45, 0.18),
    "жёсткая":     (150, 30, 0.06),
    "гладкая":      (45, 10, 0.14),
    "кошки":        (75, 20, 0.18),
}


@dataclass
class День:
    работа: float
    простой: float
    переработка: float
    принято: int
    отказано: int


def длительность(тип, rnd):
    среднее, разброс, _ = ТИПЫ[тип]
    v = rnd.gauss(среднее, разброс)
    return max(среднее / 3, min(среднее * 2, v))


def поток(rnd, заявок):
    типы = list(ТИПЫ)
    веса = [ТИПЫ[т][2] for т in типы]
    return rnd.choices(типы, weights=веса, k=заявок)


def слот_равный(_тип):
    return РАВНЫЙ_СЛОТ


def слот_по_типу(тип):
    среднее = ТИПЫ[тип][0]
    return -(-среднее // ОКРУГЛЕНИЕ) * ОКРУГЛЕНИЕ


def прожить_день(rnd, заявки, слот):
    план = [0] * МАСТЕРОВ
    факт = [0.0] * МАСТЕРОВ
    принято = отказано = 0

    for тип in заявки:
        нужно = слот(тип)
        i = min(range(МАСТЕРОВ), key=lambda k: план[k])
        if план[i] + нужно > СМЕНА:
            отказано += 1
            continue
        план[i] += нужно
        факт[i] += длительность(тип, rnd)
        принято += 1

    конец = [max(п, ф) for п, ф in zip(план, факт)]
    return День(
        работа=sum(факт),
        простой=sum(max(0.0, min(к, СМЕНА) - ф) for к, ф in zip(конец, факт)),
        переработка=sum(max(0.0, к - СМЕНА) for к in конец),
        принято=принято,
        отказано=отказано,
    )


def прогон(слот, заявок_в_день):
    rnd = random.Random(СИД)
    дни = [прожить_день(rnd, поток(rnd, заявок_в_день), слот) for _ in range(ДНЕЙ)]
    ёмкость = МАСТЕРОВ * СМЕНА
    return {
        "загрузка": statistics.fmean(д.работа for д in дни) / ёмкость,
        "простой": statistics.fmean(д.простой for д in дни),
        "переработка": statistics.fmean(д.переработка for д in дни),
        "принято": statistics.fmean(д.принято for д in дни),
        "отказано": statistics.fmean(д.отказано for д in дни),
        "дни_с_переработкой": statistics.fmean(д.переработка > 0 for д in дни),
    }


if __name__ == "__main__":
    for заявок in (12, 15, 18):
        for имя, слот in (("A", слот_равный), ("B", слот_по_типу)):
            р = прогон(слот, заявок)
            print(заявок, имя, {к: round(v, 2) for к, v in р.items()})
Один сид на оба режима — это важно: иначе сравниваются не сетки, а два разных потока клиентов. Подставьте свои длительности и доли из выгрузки своей системы записи, и числа станут вашими.
Что мы поменяли у себя
Три вещи, в порядке отдачи.
Длительность выводится из пары «услуга + порода» в момент записи. Клиент видит не «свободно с 14:00 до 16:00», а конкретное окно нужной длины. Это единственное изменение, которое вообще что-то дало на потоке ночных записей.
Сетка стала пятнадцатиминутной. Не потому, что кто-то записывается на 14:15, а потому что на такой сетке округление вверх стоит в среднем семь минут вместо получаса.
Тип шерсти хранится у животного, а не у услуги. Питомец у нас отдельная сущность с историей визитов, и длительность берётся из неё. Побочный эффект оказался сильнее основного: стало видно, что один и тот же йорк у разных мастеров стрижётся за разное время — и это уже разговор об обучении, а не о расписании.
Вывод
Если у вас сервис, где время обслуживания отличается в разы, а сетка записи равномерная, то у вас есть скрытая переработка, и в отчётах по загрузке её не видно. Проверяется это за вечер: выгрузите фактические длительности визитов за месяц, разложите по типам клиентов, прогоните симуляцию выше и сравните две сетки на своём потоке.
Мы ожидали, что выигрыш будет в пропускной способности. Его там нет — принять больше записей за смену не получилось. Выигрыш оказался в другом месте: люди перестали задерживаться после смены, а свободные часы внутри дня перестали быть случайными. Для бизнеса, где себестоимость услуги — это час мастера, второе важнее первого.
Автор: DanilRyndevich