
Я всем помогал, а в отчёте пусто. Как ИИ-агенты вспомнили за меня полгода работы
Я всем помогал, а в отчёте пусто. Как ИИ-агенты вспомнили за меня полгода работы
В июле пришло время отчёта за полугодие. От меня ждали побед и результатов, а лучше всего с цифрами. Две строчки я написал за час. На третьей остановился и завис: не мог вспомнить, чем был занят.
Я открыл календарь и полистал назад. Июнь, май, апрель. Встречи, созвоны, планёрки. Март как будто вырезали, хотя в марте я точно работал. «Непонятно…»
При этом я помню, что полгода был занят. Мне писали в личку, просили глянуть ТЗ одним глазом, звали созвониться на полчаса. Я глядел и созванивался. Иногда до ночи и по воскресеньям. А ещё внутри сидит самозванец: он обесценивает любую помощь и шепчет, что работой она не считается.
Только как это вписать в отчёт? «Помогал коллегам»? Звучит так, будто своего я ничего не сделал. Часть строк я в итоге собрал по чужим выгрузкам.
Тогда я и пошёл разбираться, почему полгода работы не помещаются в память (с годом всё ещё хуже) и что с этим делать. Подошёл к задаче системно, без лишней траты токенов: прочитал исследование Microsoft Research, наблюдения Глории Марк, метаанализ про обратную связь и всё, что попалось под руку. Вывод сделаю нескромный: способ восстановить период по следам есть. Конечно, если прилежно записывать каждый свой шаг, проблем с отчётом не будет вовсе. Но это не про меня.
Во второй половине статьи практика: два ИИ-агента ведут за меня рабочую память и собирают картину по продуктам. Покажу их логику и схемы, чтобы вы могли собрать таких же под свой трекер и свою вики.
Пятьдесят переключений в неделю
Первым делом я уточнил: это со мной что-то не так или со всеми?
В 2004 году в Microsoft Research одиннадцать человек неделю записывали в таблицу каждое переключение между задачами. Среди них были брокер, профессор информатики, разработчик, сетевой администратор и даже продавец лодок. Отмечали, что за задача, какие документы нужны, трудно ли было вернуться и что забыли.
Вот что у них получилось:
-
В среднем 50 переключений за неделю.
-
Тяжелее всего возвращаться к длинным проектам. Они вдвое дольше обычных задач (120 минут против 45), тянут больше документов и прерываются вдвое чаще.
-
13% записей заняло «отслеживание задач». Люди вели списки, копировали файлы и записывали диски перед уходом домой, лишь бы не потерять нить.
Среди ярлыков, которыми участники подписывали задачи, есть и «ежегодная оценка результатов». Ревью было отдельной задачей уже двадцать лет назад. К нему тоже приходилось возвращаться.
Глория Марк из Калифорнийского университета в Ирвайне три дня наблюдала за 36 специалистами. У человека было в среднем 12,2 параллельной «рабочей сферы» в день, и менялись они в среднем каждые 10,5 минуты. Больше 80% прерванной работы возобновляли в тот же день. Но до возврата успевали сделать ещё примерно две задачи.
Знакомо? Коллега с кружкой чая на кухне спрашивает, что там по статусу. Другой просит уточнить что-то по продукту. По сути это та же работа: консультация, и сделана она хорошо. Только в хронологии её потом нет.
Каждый такой разговор на кухне тоже прерывание, и Марк показывает, что оно меняет окружение. Возвращаешься к столу, а там открыты новые окна и лежат другие бумаги. Вспомнить, на чём ты остановился, уже труднее.
Кстати, про «23 минуты на возврат к задаче». Эта цифра кочует по статьям о продуктивности: будто после любого прерывания нужно 23 минуты, чтобы снова сосредоточиться. Я пошёл искать, откуда она взялась.
Оказалось, из того же интервью Марк. Марк измеряла, сколько времени проходит, пока человек вообще вернётся к брошенной задаче. В среднем выходило 23 минуты 15 секунд, и за это время он успевал сделать ещё две другие задачи. Сосредоточенность она не замеряла. Это в популярных статьях время до возврата превратилось во время, нужное, чтобы снова вникнуть.
Другие исследования эту цифру не подтверждают. У Iqbal и Horvitz в 2007 году к исходной задаче возвращались через 11-16 минут. А в статье самой Марк 2008 года люди с прерываниями справлялись с задачей даже быстрее, просто нервничали сильнее. Так что вернуться к работе можно и быстрее, особенно когда знаешь, где остановился. По мне, это и есть главное: помнить, на чём прервался, или иметь инструмент, который покажет, на каком этапе ты сейчас.
В опросе VK WorkSpace и Hi-Tech Mail на 4 тысячи россиян 42% признались, что периодически тратят больше времени на поиск нужного файла или переписки, чем на работу с ними. У Microsoft по телеметрии средний сотрудник получает 117 писем и 153 сообщения в мессенджере за день.
Получается, память и не рассчитана хранить полгода работы. Если за неделю набегает полсотни переключений, за полгода их больше тысячи. Удержать их все в голове не выйдет.
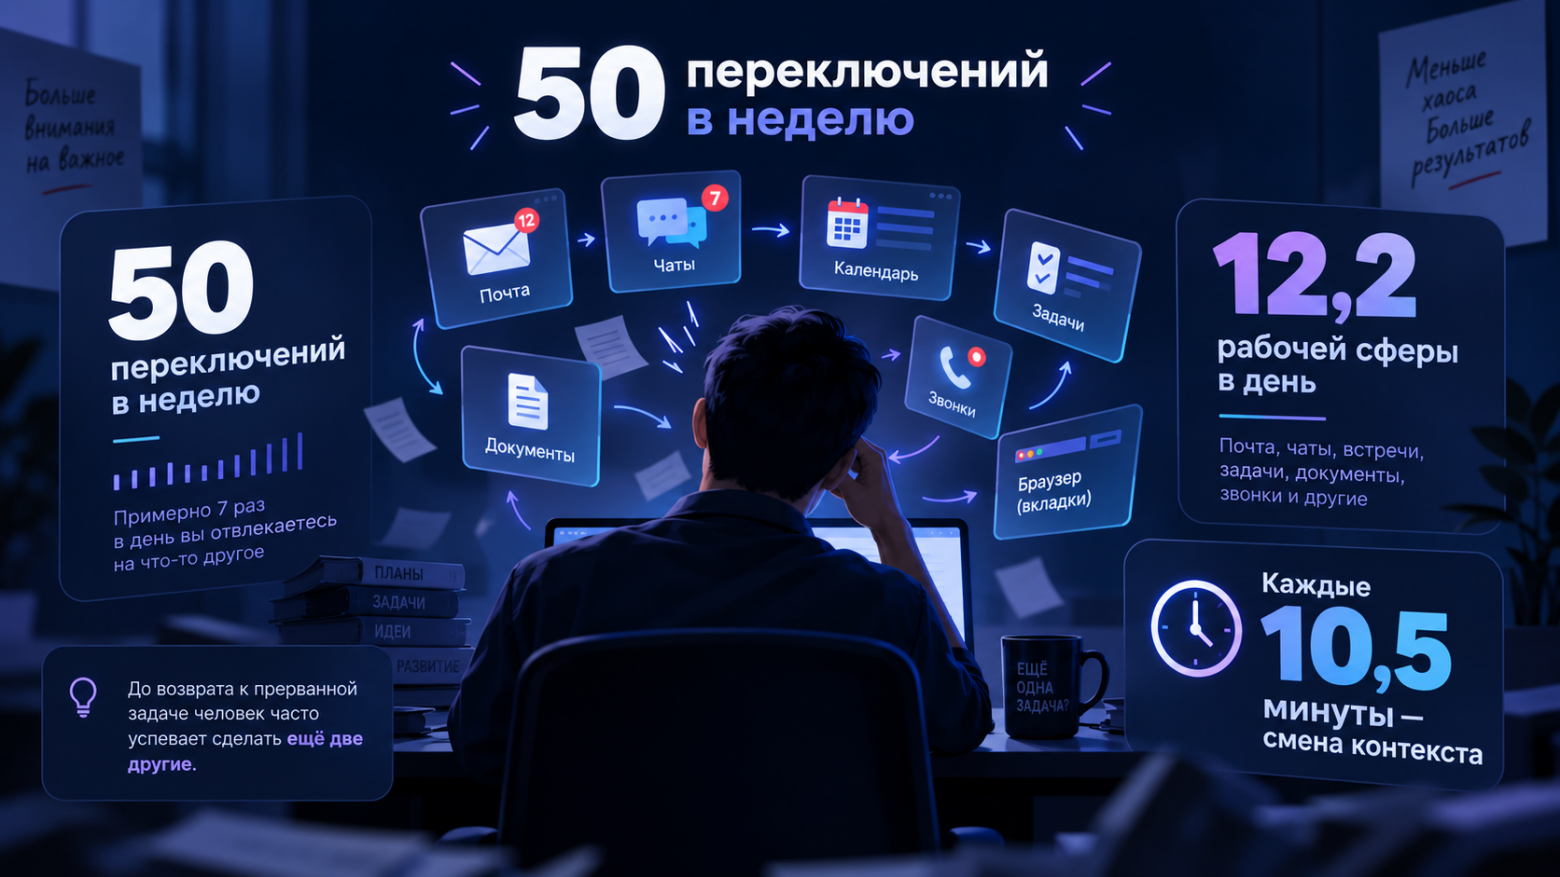
Таблица в чужом отчёте
Дальше мне попался доклад Тани Рейли «Быть клеем». Она рассказывает про инженера, которая два года помогала новичкам освоиться, выручала коллег, когда те застревали, вела протоколы встреч и разговаривала с пользователями. Рейли называет такую работу клеем: она склеивает команду, но в итогах её не видно. Ревью у инженера были отличные. А на повышении она услышала, что технического вклада нет.
Я прочитал это и узнал себя, только в меньшем масштабе: работа на команду есть, близкие коллеги её ценят, а вот в итогах её сложно разглядеть. У меня такой клей выглядит проще. Коллега пишет в личку: надо посчитать, кто после вебинара дошёл до личного кабинета. Я пишу запрос, собираю таблицу, отправляю. Час работы. За полугодие таких просьб набралось несколько десятков.
Таблица потом живёт в чужом отчёте. В моём от неё остаётся «спасибо, помогло» в личке.
Выходит, помощь почти не оставляет следов там, где потом ищут результаты. По данным «ЛидерТаск» и Strive это видно в цифрах:
-
Только 10% поручений содержат описание, ответственного и срок.
-
55% сотрудников ставят или получают задачи в чатах, 32% устно.
-
Руководители тратят на обсуждения 2,8 часа в день, рядовые сотрудники около полутора.
Просьба «глянь одним глазом» приходит в личку, ответ уходит туда же. В трекере от неё ничего нет. В календаре тоже, если созвон был на пять минут.
Отчёт собирают по задачам и релизам, а помощь живёт в переписке. Даже Gallup, который много лет изучает ревью, прямо пишет, что помощь коллегам нужно включать в оценку отдельно. Сама она туда не попадёт.
Где лежит память
Я вернулся к третьей строке отчёта и попробовал понять, что именно я забыл.
Первая мысль была неприятная: «Может, полгода и правда прошли впустую?» Нет. В «Отправленных» за этот срок набрались тысячи писем, в мессенджере сообщений ещё больше. Почти все про работу.
Тогда, может, плохая память? Тоже мимо. Стоило открыть конкретную переписку, и я вспоминал всё: кто просил, что сломалось, чем закончилось.
Так. Воспоминания на месте, не хватает входа в них.
Психологи давно заметили этот механизм. Когда человек знает, что информация сохранена, он хуже запоминает её саму и лучше помнит, где она лежит. Мозг экономит: зачем хранить содержимое, если есть адрес. (Не все учёные смогли повторить этот опыт. Но когда в 2024 году свели вместе 35 похожих исследований, эффект в целом подтвердился.)
Вышло забавно. Все полгода я добросовестно складывал память в почту и чаты, а над третьей строкой пытался достать её из головы.
Но чем дольше я об этом думал, тем меньше было смешно. Та же история случалась со мной не только с отчётами.
Год назад я поднимал открытую LLM на сервере с GPU, чтобы сравнить модели. Недавно меня спросили, как там был настроен инференс. Наизусть я вспомнил только саму модель.
Потом открыл чат со стендом и свои заметки. За полчаса восстановил остальное: версии, параметры запуска, почему отказались от первого варианта. Ответ лежал в следах.
Отсюда мой ответ на свой вечный вопрос, что важнее специалисту: знания или навыки. Я считаю, что навыки важнее. Поясню на своём примере. Под знаниями я понимаю саму информацию: все команды, чтобы поднять Llama и настроить OpenClaw. Под навыками понимаю умение пользоваться справкой через –help, читать документацию и сохранять накопленный опыт в инструкции, чтобы потом к нему вернуться. По-моему, сам спор однобокий. Его обычно ведёт тот, кто оценивает со стороны: он видит только результат и не смотрит, как человек к нему пришёл. У специалиста, который постоянно переключается, знания выветриваются неизбежно. Остаются умение восстановить контекст по следам, логика поиска и привычка оставлять следы заранее, а всё это навыки, которые тренируются так же, как любой рабочий инструмент.
Почему я за навыки? У меня есть давний пример. Когда-то я был активным участником форума Ubuntu под ником graddata и помогал новичкам разбираться с их задачками. Сообщество росло, и документацию мы с коллегами-форумчанами постоянно дополняли.
Что именно я тогда делал, я уже не помню. То ли патчил ядро, то ли писал драйвер для принтера. Зато у меня остался форум, и работает он как база знаний. Я без проблем найду поиском нужную ветку или сформулирую запрос, а ИИ-ассистент поможет собрать из неё скрипт или команду для bash.
Навык и накопленный опыт остались со мной. Знания, увы, забылись.
Впрочем, у внешней памяти есть подвох. В экспериментах психологов люди не замечали, что данные во внешнем хранилище подменили, и встраивали ложное в собственную память. Следы мало хранить, их приходится сверять. Особенно когда их пересказывает кто-то другой, например ИИ. Отсюда у меня практическое правило: сводка должна вести к первоисточнику. Тут так и тянет вспомнить про RAG, но это уже тема отдельной статьи. Меня не отпускает другой вопрос: где хранить истину, которую никто не подменит? Пока эталоном для меня остаётся напечатанная книга на полке, в которой годами не меняется ни строчка.
Раскопки по следам
Джулия Эванс описала ту же сцену ещё в 2019 году. Перед ревью она перебирала свои правки в коде, задачи в трекере, письма о запусках и проектные документы. И находила забытое: наставничество стажёра пять месяцев назад, проект по безопасности, помощь с миграцией. Она советует не полагаться на память и вести документ достижений.
У меня порядок похожий, только я начинаю с раскопок:
-
Календарь за полугодие. Выписываю разовые встречи с людьми не из своей команды: чаще всего это и есть помощь.
-
Отправленные письма. В отправленных лежит то, что я сделал, во входящих то, что хотели от меня. К тому же их меньше.
-
Личные сообщения в мессенджере. Ищу по словам «спасибо», «помогло», «заработало», «посчитал».
-
Трекер задач: закрытые задачи, ревью, комментарии.
-
Документы, которые я создал или правил: страницы вики, дашборды. У дашборда есть дата создания, это след с точным числом.
-
Для каждой находки одна строка: что сделал, для кого, что изменилось. Эванс советует не останавливаться на «выпустил новую функцию» и дописывать, к чему это привело.
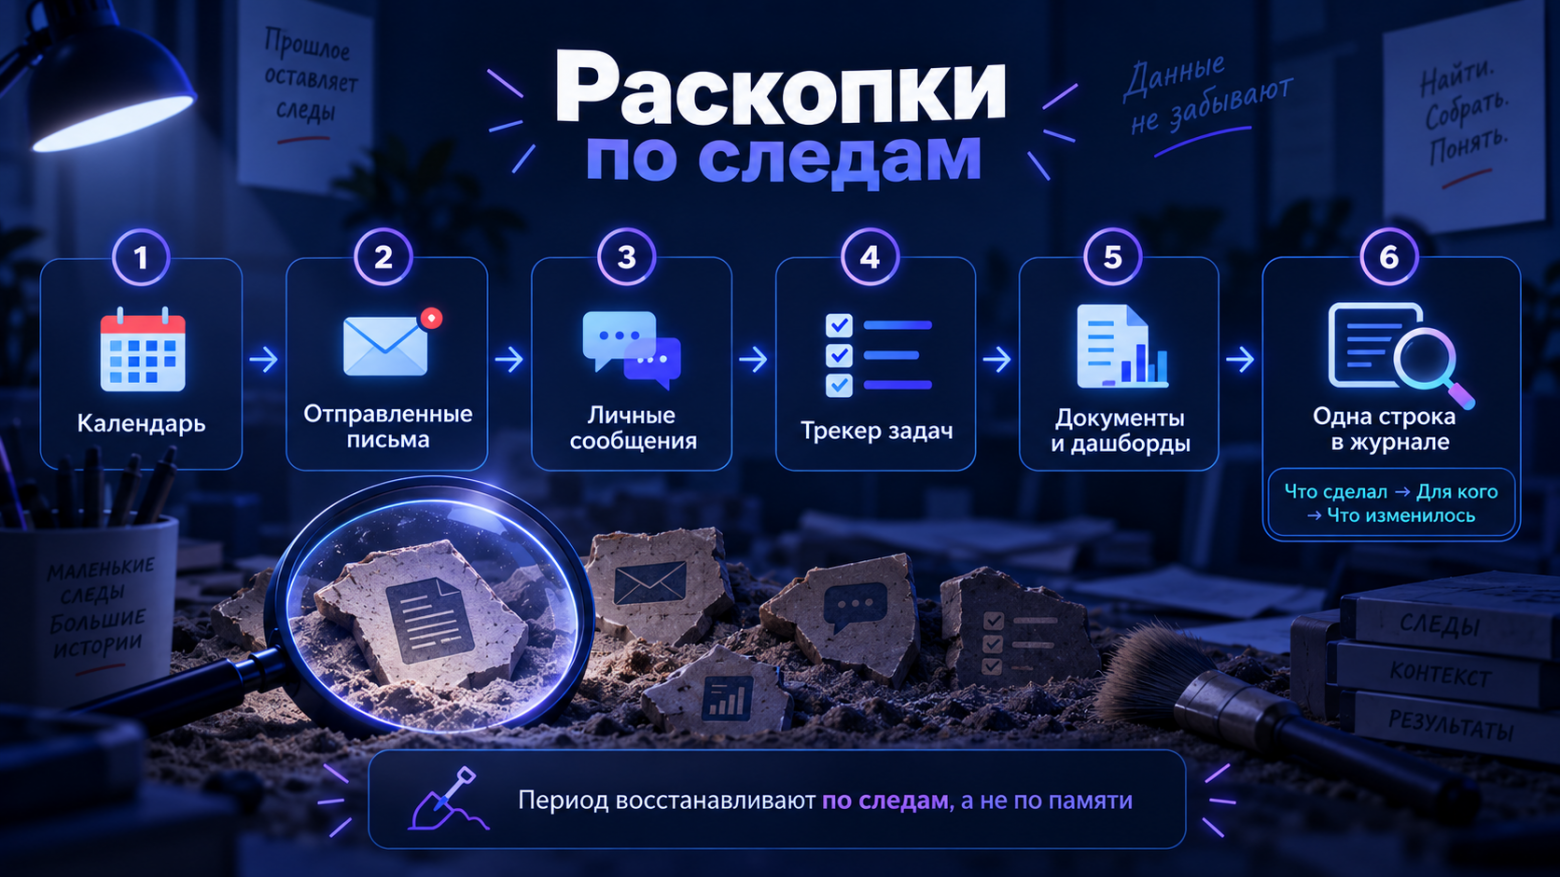
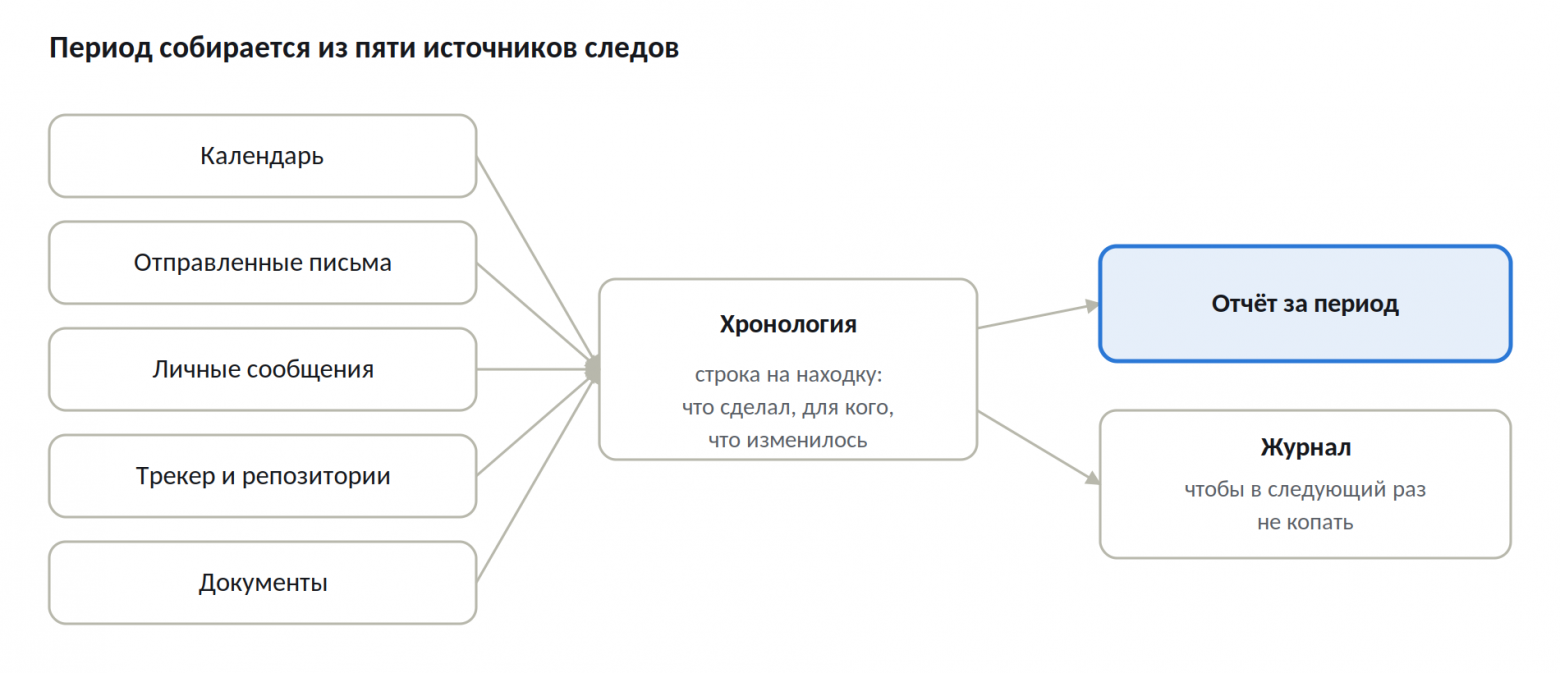
Пять источников сходятся в одну хронологию, из неё получаются и отчёт, и журнал на следующий раз.
Журнал в блокноте я пробовал вести и бросил через месяц. Сработало другое. Аналитические задачи я теперь сразу оформляю в трекере с запросом, источником и результатом, а часть из них заводит по расписанию небольшой скрипт с ИИ. К следующему отчёту эта часть хронологии соберётся сама.
ИИ как археолог
Руками раскопки заняли у меня вечер и ещё утро: часть данных пришлось просить у коллег. С ИИ тот же поиск сводится к нескольким запросам: спрашиваю, что происходило по проекту в марте, и получаю сводку.
Схема универсальная, у каждого свой набор источников. У меня в центре корпоративный ИИ, VK AI Space. Через MCP к нему подключены (сразу предупреждаю: для ИБ это красная зона, почти как привилегированный доступ, поэтому у меня это отдельный процесс и каждый запрос ассистента я согласую сам):
-
VK WorkSpace со всеми чатами, проектами, презентациями и картинками: на работе я живу в нём на ноутбуке, в телефоне и даже в уведомлениях на смарт-часах, это мой основной инструмент для общения и планирования. У VK WorkSpace есть собственный MCP-сервер: в коробочной версии он уже работает с мессенджером, в облачной появится совсем скоро; почту, диск и календарь коллеги обещают подключить следом. Остальное, включая диск с презентациями и картинками, я пока подключаю своими коннекторами.
-
Внутренний трекер задач, внутренняя вики и внутренняя BI-система.
-
Отчёты коллег на общем диске.
-
Репозиторий кода и другие рабочие хранилища.
-
Данные из наших же облачных проектов. Мы всё-таки айтишники, поэтому информацию по кластерам Kubernetes и виртуальной инфраструктуре я подтягиваю через OpenStack CLI, kubectl и дашборды Grafana: например, что происходило с ресурсами проекта за прошлую неделю и сколько бюджета уже потрачено по данным биллинга.
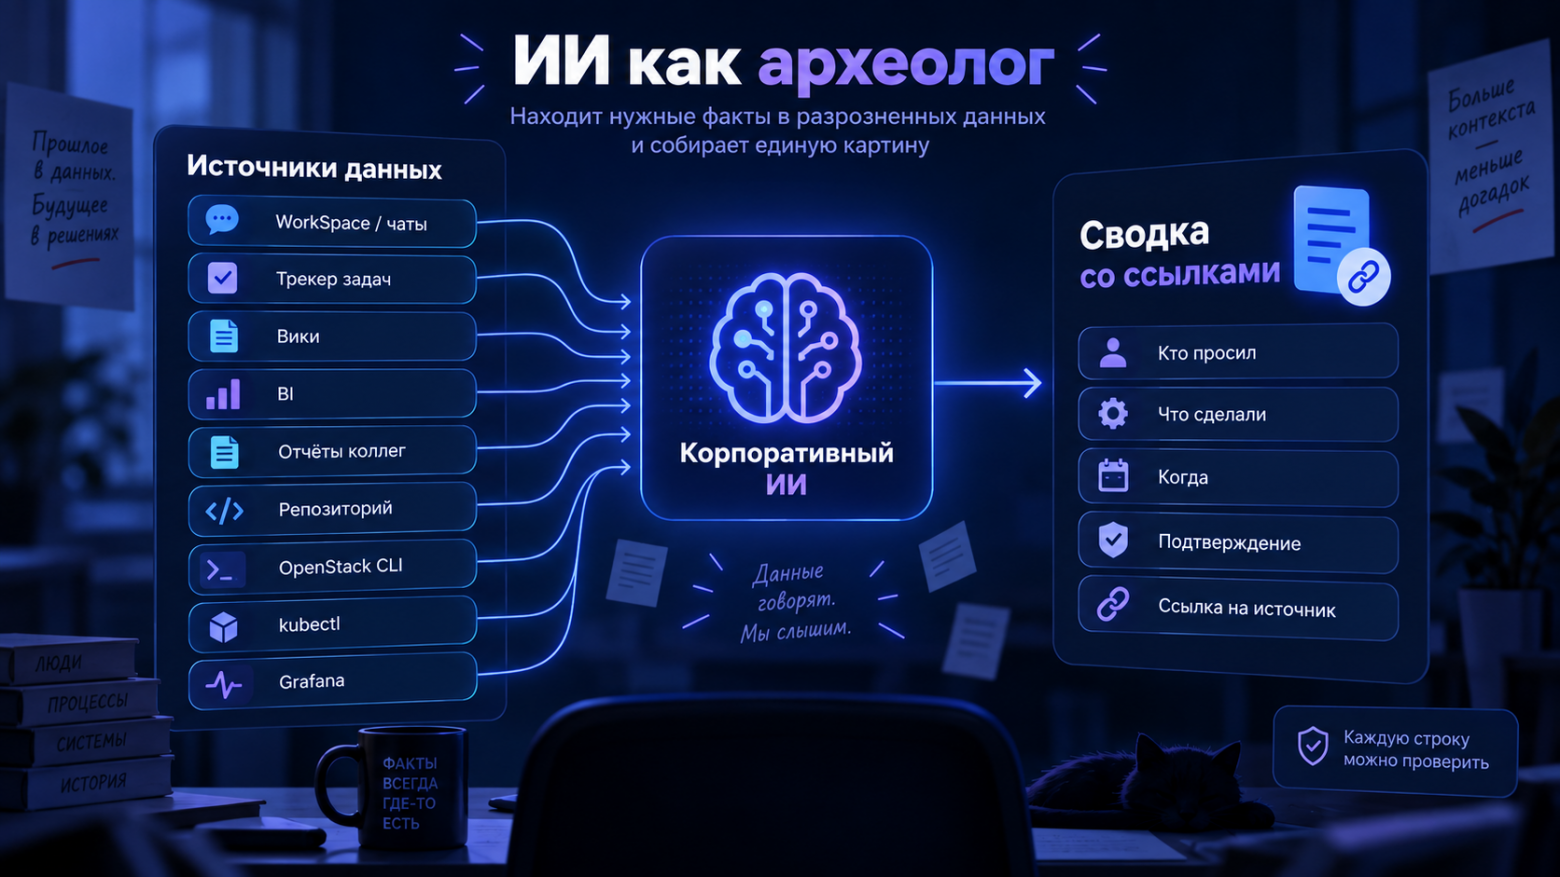
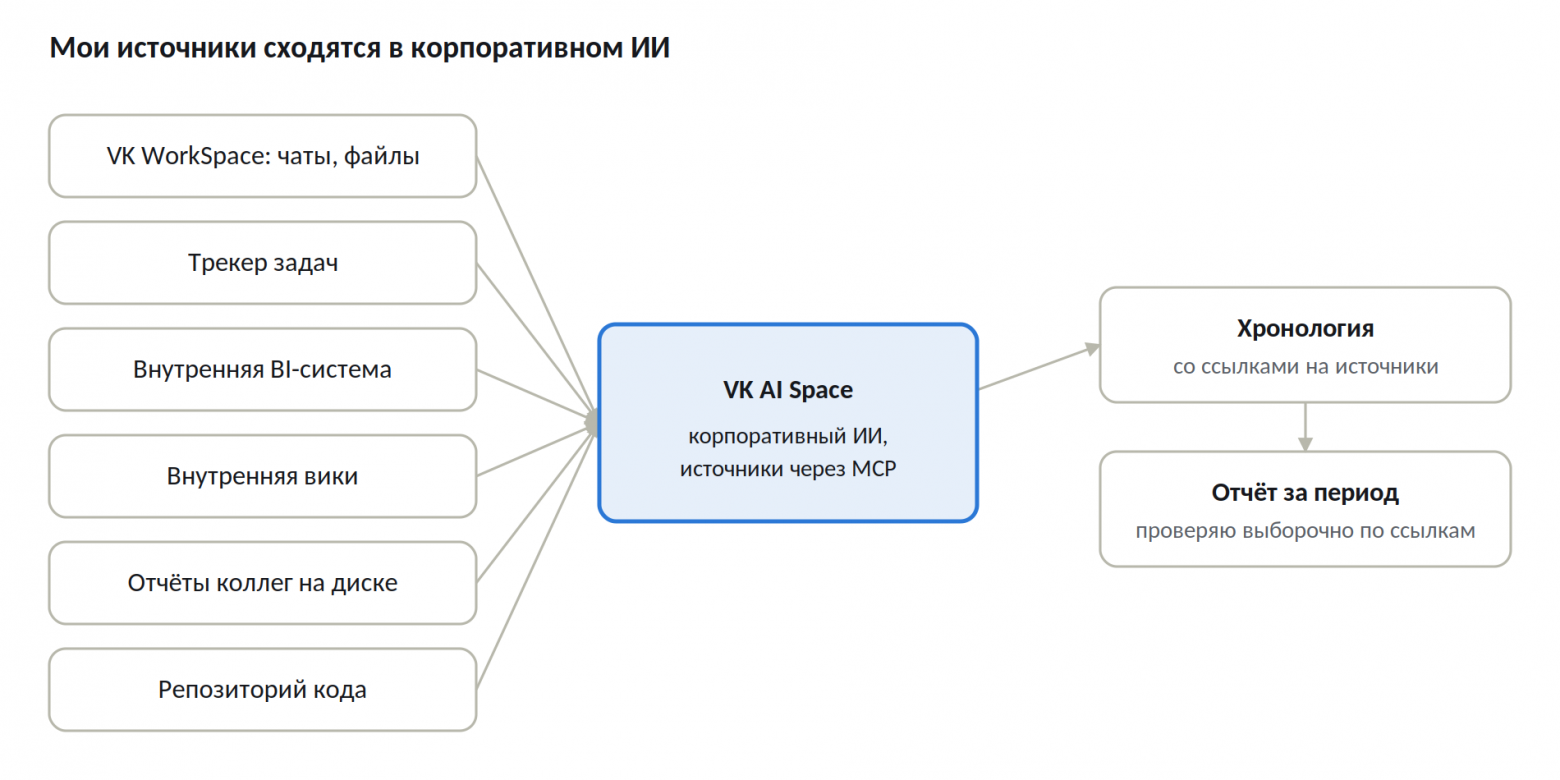
Главное моё условие: сводка идёт со ссылками на исходные сообщения, чтобы любую строку можно было проверить. Иначе пересказ незаметно подменит факт, как в тех опытах с внешней памятью. Механизм и оформление я проверил один раз, дальше выборочно заглядываю по ссылкам.
Как такие агенты устроены изнутри, покажу ниже на двух своих навыках. А про безопасность всей этой конструкции расскажу отдельно, после практики.
Два агента, которые можно собрать у себя
Я пользуюсь корпоративным ИИ-ассистентом, про который писал выше. Ресерч для отчёта за полугодие сжался до нескольких запросов: с кем встречался вне команды, кому что считал, что обсуждали по проектам. Жаль только, что разговоры на кухне так не оцифруешь. ИИ-очки и ИИ-диктофон у меня в планах, но записывать, конечно, только с согласия собеседников.
Покажу два навыка для ИИ-агента, которыми пользуюсь сам. Названия систем опускаю намеренно: логика одна и та же в любом стеке, а трекер, чат и систему аналитики у каждой команды свои. Под навыком я понимаю набор инструкций, который агент загружает и выполняет одинаково у любого, кто его запустил.
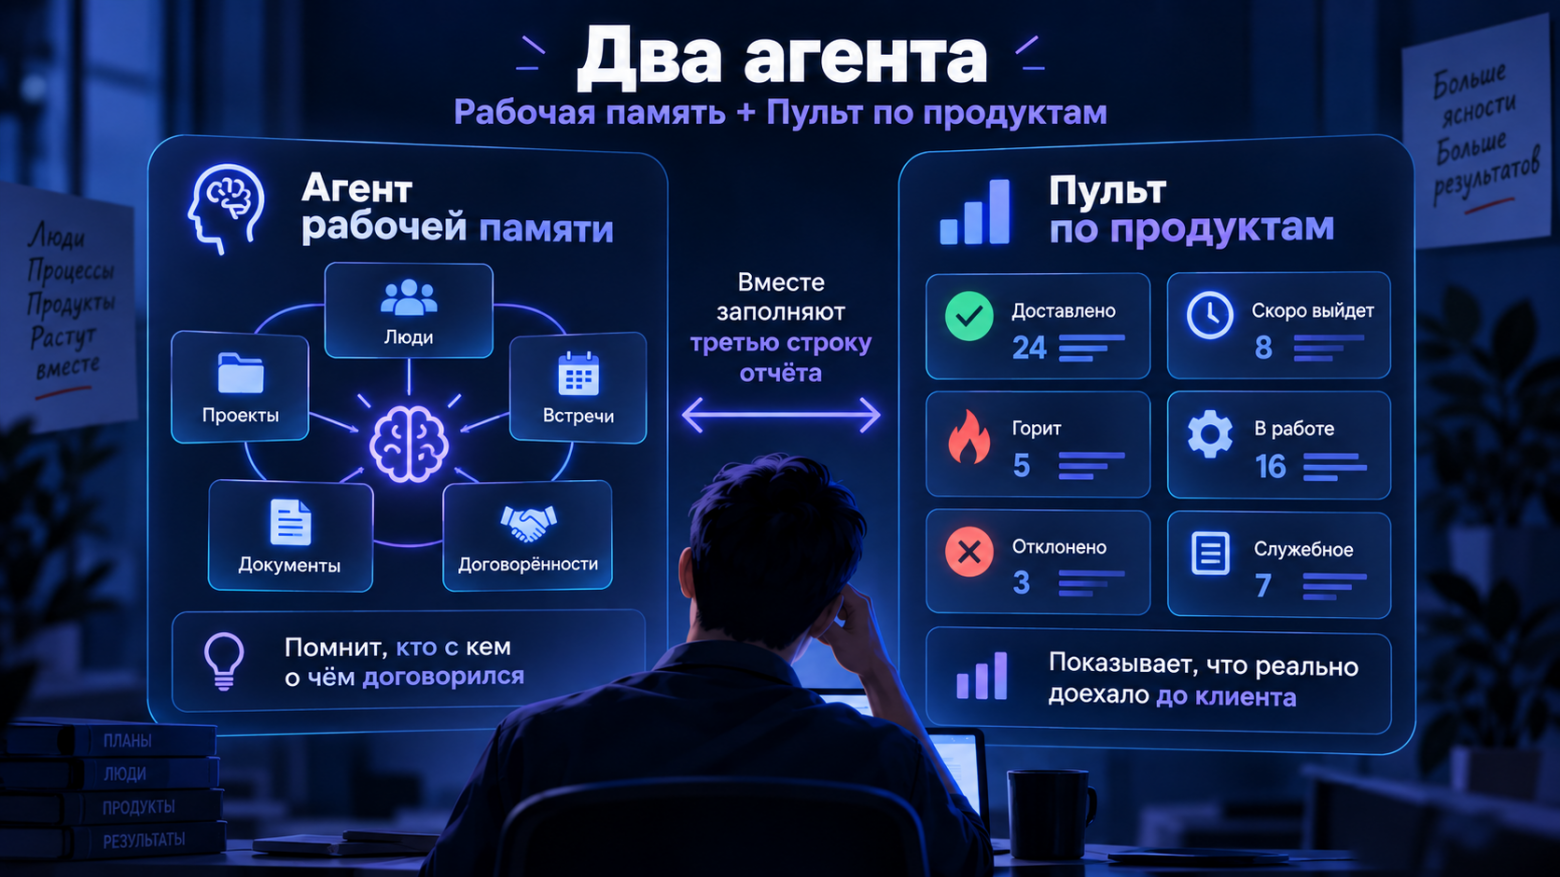
Первый агент помнит людей и договорённости. Второй собирает картину по продукту: что доставлено, что горит и что вот-вот выйдет.
Агент рабочей памяти
Представьте руководителя проекта, который ничего не забывает: протоколы встреч, версии документов, обещания, сроки и историю совместной работы. Агент рабочей памяти делает эту работу за меня.
Главная его идея в раскладывании по полкам. Каждое касание с коллегой, будь то сообщение, задача, правка документа или встреча, агент относит к проекту и к человеку и копит, а не пересказывает один раз. Со временем у каждого проекта появляется своя сводка, а у каждого коллеги своя история общих дел.
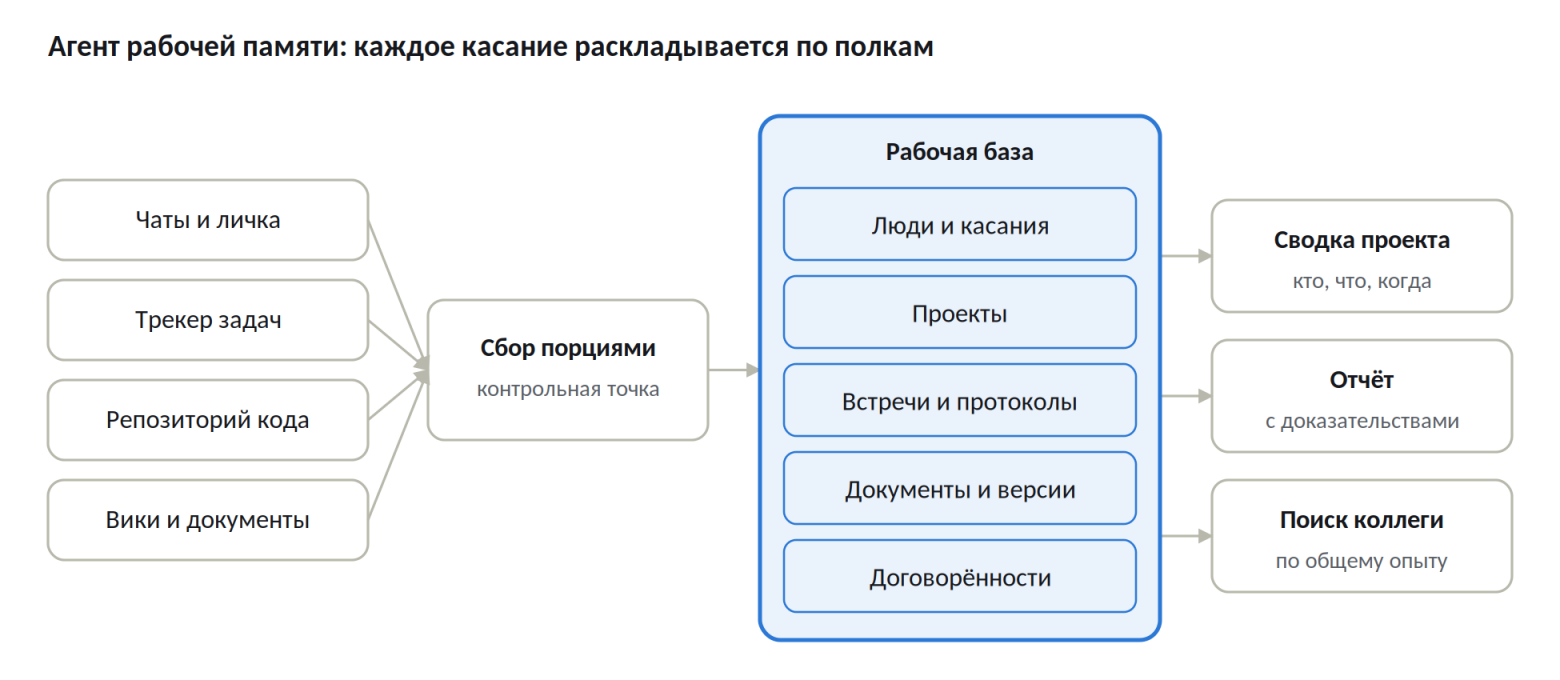
Что лежит на полках:
-
Люди и касания. У каждого коллеги своя карточка: роль, отдел, общие проекты и история, кто к кому с чем приходил. Нового коллегу агент изучает по роли и рабочим пересечениям, без анкет и сообщений ему.
-
Проекты. Отдельный рабочий чат рождает проект, и его идентификатор не меняется, даже если чат переименовали. Личка и общие каналы могут относиться к нескольким проектам сразу.
-
Встречи и протоколы. Плановая и фактическая дата, участники, программа, протокол и решения. Перенос встречи сохраняется в истории и не затирает старую дату.
-
Документы и версии. Каждая версия хранится отдельно вместе с извлечённым текстом и привязана к проекту и встрече. Автор конкретной правки проверяется отдельно: дата последнего изменения страницы его не доказывает.
-
Договорённости. Запрос, принятие, срок, передача, подтверждение. Запрос без принятия остаётся запросом, а не чьим-то обязательством.
Так выглядит фрагмент отчёта по вымышленному проекту «Вебинар по объектному хранилищу»:
|
Задача и исполнитель |
Даты |
Состояние и подтверждение |
|---|---|---|
|
Передать план доклада, автор доклада |
принято 08.10, срок 10.10 |
Передано 09.10: план в сообщении, получение подтверждено ответом |
|
Согласовать заголовок, координатор |
принято 09.10, срок не указан |
Выполнено 10.10: есть явное согласование |
|
Подготовить финальные слайды, автор доклада |
принято 10.10, срок 15.10 |
Принято, выполнение пока не подтверждено |
|
Опубликовать запись, исполнитель не назначен |
запрос 11.10 |
Запрос без принятия, нужен ответственный |
В конце отчёта агент пишет покрытие: сколько сообщений получено, сколько отфильтровано как служебные, что осталось непроверенным. Полнота относится к прочитанному, а не ко всей работе над проектом.
Правила, на которых он работает:
-
Каждый результат опирается на проверяемый объект: сообщение, задачу, версию документа, слияние кода. Нет подтверждения, запись остаётся неопределённой, а не невыполненной.
-
Передать текст, согласовать его и опубликовать: для агента это три разных действия, и он их не склеивает.
-
Короткое «ок» или «готово» закрывает задачу только вместе с исходным запросом. Приветствия и бытовые реплики в разбор не идут.
-
Участник определяется по стабильному идентификатору, а не по имени. Совпадения фамилии мало, связи между системами фиксируются с основанием.
-
Чтение идёт порциями. Контрольная точка сдвигается только после того, как порция сохранена, поэтому после сбоя агент продолжает с того же места, а не читает всё заново.
-
До массового чтения агент показывает найденный объём и примерное время. Запускаю я, а не он.
Что это даёт команде:
-
Тимлиду: кто что пообещал, где застряло и какой срок уже уехал.
-
Продуктологу: история договорённостей по продуктовой задаче от первого сообщения до релиза.
-
Разработчику: слияния кода и закрытые задачи как готовые строки отчёта.
-
Всем: поиск коллеги по подтверждённому опыту, а не по упоминанию темы в названии доклада.
Как собрать такой у себя (для инженеров):
-
Создайте папку навыка и главный файл с режимами: первичное обучение базы, обновление за период, обзор обязательств, поиск коллеги.
-
Опишите схемы карточек: проект, задача, обязательство, мероприятие, материал. Данные храните отдельно от навыка, в папке с маркером базы, чтобы навык можно было отдать коллегам без чужих переписок.
-
Подключите коннекторы только на чтение и проверьте реальные поля: идентификаторы, постраничную выдачу, треды, историю версий. Список доступных инструментов не заменяет успешного вызова.
-
Прогоните пилот на одном проектном чате и одном периоде. Потом повторите на той же базе с новой порцией и проверьте, что идентификаторы сохранились, а статусы обновились.
-
Перед широким запуском проверьте на вымышленных данных: повтор порции не создаёт дублей, переименованный чат остаётся тем же проектом, неоднозначное «ок» не закрывает задачу.
Пульт по продуктам
Второй агент отвечает на еженедельный вопрос: что уже доставлено клиенту, что вот-вот выйдет, что горит и куда движется продукт. Руками это разбор тысяч задач в трекере. Пульт собирает такой отчёт за минуты. Источники у него только внутренние: трекер и вики.
Всё, что пульт знает о продуктах, живёт в вики, а не в агенте. Агент знает только порядок действий и адрес главной страницы пульта. Продукты, запросы и формы отчёта команда правит прямо в вики. Следующий прогон идёт уже по новой версии, без переустановки навыка.
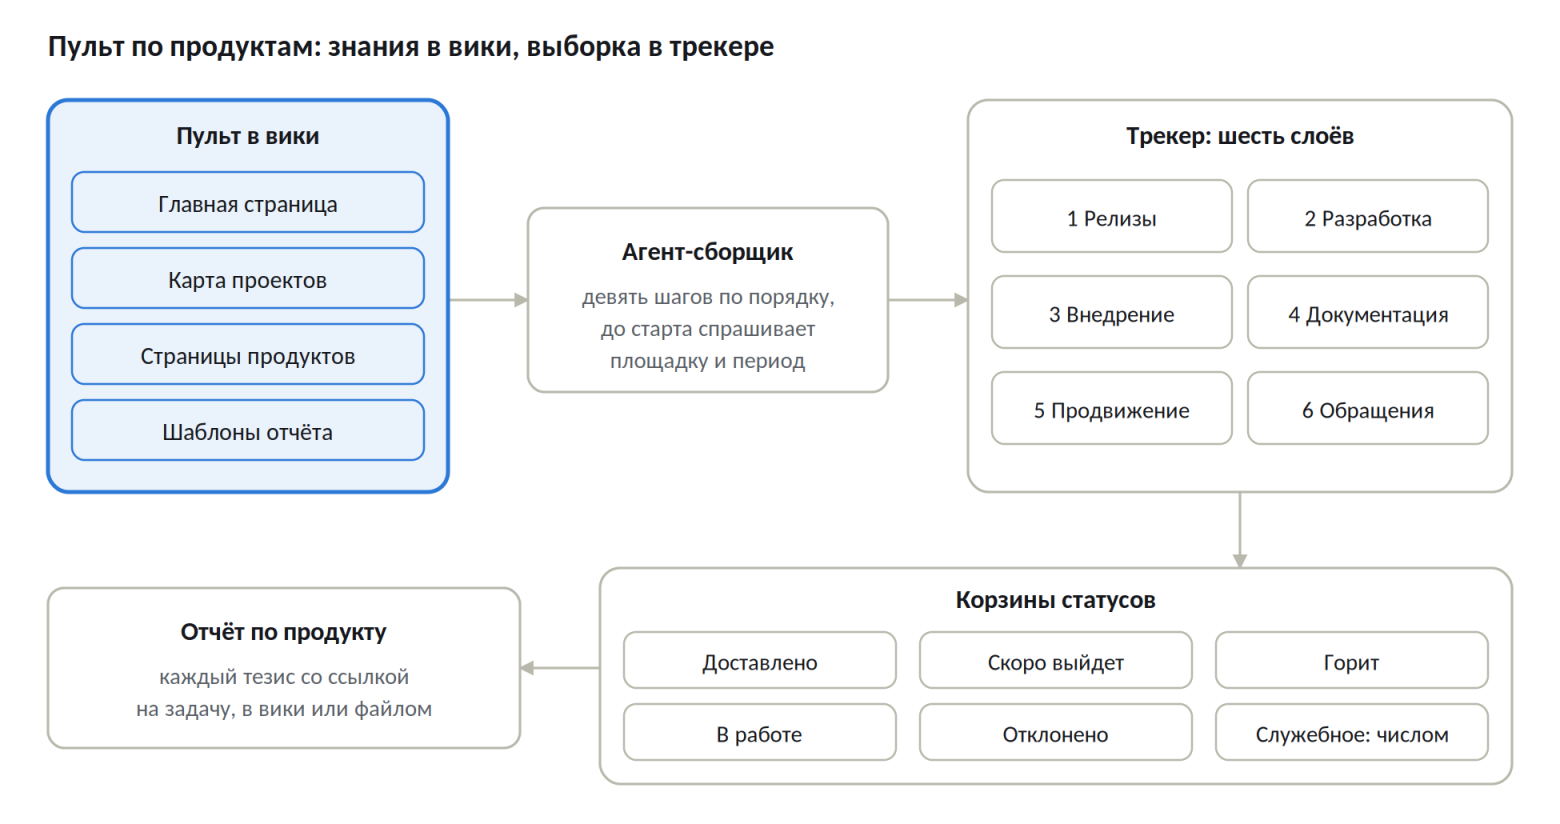
Что лежит в вики:
-
Главная страница с инструкцией сборки. Агент читает её первым, всё остальное находит по ссылкам.
-
Карта проектов трекера: в каких проектах какая работа и какие проекты только называются похоже на продукт.
-
Страница на каждый продукт: его границы, сетка «что ищем × на какой площадке» с готовым запросом в каждой ячейке, подпродукты и темы внутри продукта.
-
Справочник компонентов: что это за система, с пояснением для непосвящённых.
-
Шаблоны отчёта и папка с готовыми отчётами по продуктам.
Продукт при этом не равен проекту в трекере. Один проект обслуживает несколько продуктов, один продукт живёт в нескольких проектах. Поэтому продукт задаётся срезом: проект плюс компонент, поле справочника или слово в названии. У каждого среза своя пометка точности: «точно», если выборка идёт по полю, и «примерно», если по тексту.
Дальше агент обходит шесть слоёв трекера, начиная с релизов: релизы, разработка, внедрение у клиентов, документация для поставки в закрытый контур, продвижение и обращения клиентов. В отчёт попадают все слои с числом найденного, включая нули: ноль по слою тоже результат.
Найденное агент раскладывает по корзинам статусов, на каждый вопрос отдельный запрос:
-
Доставлено: задачи с датой решения в периоде, отдельно новые функции, релизы и исправления.
-
Скоро выйдет: ревью, тестирование, готово к выкату.
-
Горит: критичные и блокирующие задачи, уязвимости, инциденты, только открытые.
-
В работе: крупные эпики, без мелких задач.
-
Отклонено: что не доехало и почему.
-
Служебное: автотесты, инфраструктура, техдолг. Этот поток сворачивается в одно число.
Каждое из этих правил появилось после ресерча. По одному из продуктов за период шло движение больше чем по 3000 задачам. Выборка по дате последнего изменения утонула в ботах и автотестах, и до отчёта дошли единицы новых функций. Запрос по дате решения нашёл больше 15. По другому продукту выборка внутри проекта разработки показала ноль задач за квартал, хотя на деле продукт перезапускали: три факта из четырёх лежали в проектах, куда никто не смотрел.
Жёсткие правила пульта:
-
Один отчёт про одну площадку: разные варианты поставки продукта в одном отчёте не смешиваются.
-
Статус пишется дословно. «Готово к выкату» и «выкатывается», «отклонено» и «сделано» означают разное, и пересказ эту разницу стирает.
-
Каждая цифра и каждый тезис со ссылкой на задачу. Пустой срез означает «без изменений» и тоже попадает в отчёт.
-
Имена клиентов и сотрудников в отчёт и в выгрузку не попадают, клиент маскируется отраслью (ИБ).
-
Текст, который написала модель, помечается и проверяется перед показом наружу.
Кому пригодится:
-
Тимлиду: что горит, что застряло на ревью и тестировании, что отклонено и почему.
-
Продуктологу: что за период реально доставлено клиенту на конкретной площадке, с готовым текстом для релизных заметок.
-
Разработчику: свои релизы в контексте всего продукта, а служебный поток не забивает картину.
Как собрать такой у себя (для инженеров):
-
Подключите коннекторы к трекеру и вики на чтение. Начните с одного продукта и одной формы отчёта.
-
Заведите в вики главную страницу с инструкцией сборки и пять разделов: продукты, компоненты, справочники, шаблоны, готовые отчёты.
-
Составьте карту проектов: какие слои есть у вас и какие проекты только похожи на продукт по названию.
-
Сделайте страницу первого продукта и прогоните её запросы на реальных данных, результат запишите на отдельную страницу проверки.
-
Напишите главный файл навыка: адрес главной страницы, порядок из девяти шагов и жёсткие правила. Запросов и формы в навыке быть не должно, они живут в вики.
-
Соберите первый отчёт и сверьте с тем, что знает владелец продукта. Каждый ресерч запишите правилом в вики, потом тиражируйте страницу на остальные продукты.
Как они стыкуются
Агент рабочей памяти хранит, кто с кем о чём договорился и чем это подтверждено. Пульт по продуктам показывает, что из этих договорённостей реально доехало до клиента, со ссылкой на каждую задачу. Вместе они заполняют третью строку отчёта: моя помощь коллегам видна в договорённостях, а её результат в доставленных релизах.
Доступ под присмотром
Этот раздел для ИБ и для инженеров. Оба агента читают чаты, задачи и документы, поэтому вопрос «а безопасно ли это» здесь главный.
Доступ к источникам я даю точечно: только на конкретную сессию и только после дополнительного подтверждения вторым фактором. Да, служба безопасности бдит, и это правильно. Каждый запрос ассистента к чатам, задачам и документам журналируется и мониторится, так что ИИ видит ровно то, что я разрешил на этот раз. По сути это логика PAM-систем для привилегированного доступа: права выдаются на время, под подтверждение и с записью всех действий.
Модель работает там, где лежат данные, внутри контура компании, и видит только то, что доступно мне по правам.
Подключить MCP не так просто, как выглядит в анонсах. Для каждого источника нужен свой коннектор, согласование с владельцем системы и с ИБ, настройка прав и проверка, что ассистент видит только разрешённое. Кнопки «подключить всё» здесь нет, каждый источник заводится отдельно.
Свежие отчёты показывают, чем кончается обратный путь, когда рабочую переписку копируют в публичные чат-боты:
-
По данным «Солара» за первое полугодие 2026 года, почти в 40% обращений к публичным ИИ есть конфиденциальные данные.
-
По данным «Информзащиты», 20% организаций с утечками связали их с ИИ вне контроля ИБ. Год назад таких было около 12%.
Скопировать полгода переписки в публичный чат-бот ради красивого отчёта значит устроить ровно такой инцидент своими руками.
Разговор о работе
Знаю, что мне возразят: ревью давно ругают, так стоит ли под них подстраиваться? Но сам отчёт за период остаётся обязательной задачей, одной для всех сотрудников, так что уйти от него не получится.
Ругают, наверное, справедливо, особенно когда сотруднику не дали инструмента и не выделили время на отчёты, а привычку вести их никто не привил. По Gallup, лишь 14% сотрудников полностью согласны, что ревью вдохновляют их расти. Kluger и DeNisi свели 607 эффектов обратной связи: в среднем она улучшает результат, но больше трети эффектов оказались отрицательными.
Чем сильнее обратная связь уводит внимание от задачи к вопросу «какой я», тем слабее эффект. Конкретные комментарии по задаче поднимали результат. Оценки только повышали тревогу за себя.
Получается, проблема не в самом отчёте. Она начинается, когда вместо разговора о задачах начинают оценивать человека. Отчёт по следам как раз про задачи: что сделано, для кого, что изменилось.
И нужен он не только к ревью. Эванс замечает, что менеджер помнит ещё меньше тебя и без такого документа не сможет тебя защитить. Тот же документ пригодится при смене руководителя, при передаче проекта и просто чтобы увидеть, куда ушли полгода.
Короче говоря, для заметки:
-
Полгода работы не помещаются в память: за неделю набегает полсотни переключений, а консультации на кухне и в личке следов не оставляют. Период восстанавливают по следам, а не по памяти.
-
Что я наблюдаю: работу на команду близкие коллеги ценят, но в трекер она не попадает. Ресерч для отчёта я начинаю с календаря и отправленных писем.
-
Протоколы встреч и договорённости я сразу складываю во внутреннюю вики, а агент рабочей памяти раскладывает каждое касание с коллегами по людям и проектам. К отчёту эта часть хронологии уже собрана.
-
Что реально доехало до клиента, показывает пульт по продуктам: знания о продукте живут в вики, выборка идёт по корзинам статусов, каждый тезис со ссылкой на задачу.
-
ИИ-помощника я проверяю один раз на механизме сбора и оформлении, дальше он работает сам. Доступ к источникам даю точечно, на сессию и со вторым фактором, каждый запрос согласую (ИБ).
-
Знания выветриваются, навыки остаются. Поэтому вопрос «знания или навыки» я для себя решил в пользу навыков, и звучит он теперь иначе: где лежат мои следы и смогу ли я их найти?
Станислав Погоржельский
Автор: GRADDATA