
Полигон гипотез: как понять, что я не сделаю бесполезную фичу?
ИИ научил нас придумывать гипотезы быстрее, чем мы успеваем их проверять. Узкое место сдвинулось с идеи на проверку до запуска — к сожалению, это дорого, как и раньше… Из этого следует вывод: выигрывает тот бизнес, у кого больше гипотез доходит до полезного импакта.
Конечно, шарманка за 20 баксов в месяц слепит идеальную с виду гипотезу из любого контекста — настолько красивую и точную, насколько случайную и бесполезную. Да я и сам запускал, пока однажды это не стоило нескольких команд и бюджета на промо.
Генерацию гипотез ускорили, а проверка осталась такой же, как в 2020-м. Попробуй скажи вслух «давайте сначала проверим» — станешь тормозом, человеком из прошлого, луддитом.
В статье расскажу, как полигон гипотез выглядит в работе: как устроена система, как оркестратор ведёт задачу, откуда берутся данные, почему всё собрано именно так и какие задачи решает полигон.
Как я слил бюджет на трёх красивых гипотезах
Я хотел зайти к средним компаниям с оптовым сбытом и стать для них партнёром сразу по нескольким задачам. Ставка была на три гипотезы: клиенты ни к кому не привязаны, их задачи никто не закрывает разом, а увидев комплексное решение, они переключатся. Исследования, оценка рынка, корпус контекста — всё по правилам. Гипотезы провалились: ушли ресурсы нескольких команд, бюджет на промо и несколько месяцев общих трудов.
Потом я скормил системе тот же бриф и тот же контекст, один в один. Шесть шагов, ноль рублей на трафик и пять дыр:
-
первая гипотеза держится на сигнале, который одинаково объясняет и «ни к кому не привязан», и «привязан, только не к нам»;
-
вторая опровергает сама себя: у конкурентов эти продукты есть, просто не с тем UX;
-
третья склеивает «уйти насовсем» и «добавить второй сервис», а заявка с лендинга их не различает;
-
гипотезы опираются друг на друга, а проверялись как независимые;
-
и пятая, о которой я даже не спрашивал: лендинг в принципе не мог ответить на наш вопрос, сколько промо в него ни лей. Система предложила начать с пары коротких интервью.
Для чистоты — результатов теста во входных данных не было, только то, что лежало у меня на столе до запуска.
Погнали, расскажу, как устроена эта система.
Знакомьтесь: Полигон гипотез
Это система ИИ‑агентов, которая помогает:
-
отсеивать до запуска: каждая идея проходит через контекст продукта, рынка и прошлых проверок, и остаются только те, под которыми лежит то, что реально случилось;
-
доводить до проверки за один прогон: слабое отсекается на бумаге, сильное уходит в эксперимент усиленным, а человеку остаётся согласовать задачу.
Вот как это работает:
-
Кладёшь в папку проекта всё, что есть о продукте, клиентах и рынке: интервью, выгрузки, описание сегмента. Нет ничего — система пойдёт в открытые источники.
-
Пишешь задачу как есть: «почему уходят клиенты», «найди ниши под цель», «проверь мои гипотезы».
-
Система собирает ТЗ и показывает: как поняла задачу, что прочитала, чего не хватает. Ты правишь и согласуешь — иногда в несколько кругов.
-
Дальше она работает сама и отдаёт артефакты по каждому шагу и итоговый отчёт в той форме, которую вы согласовали в ТЗ.
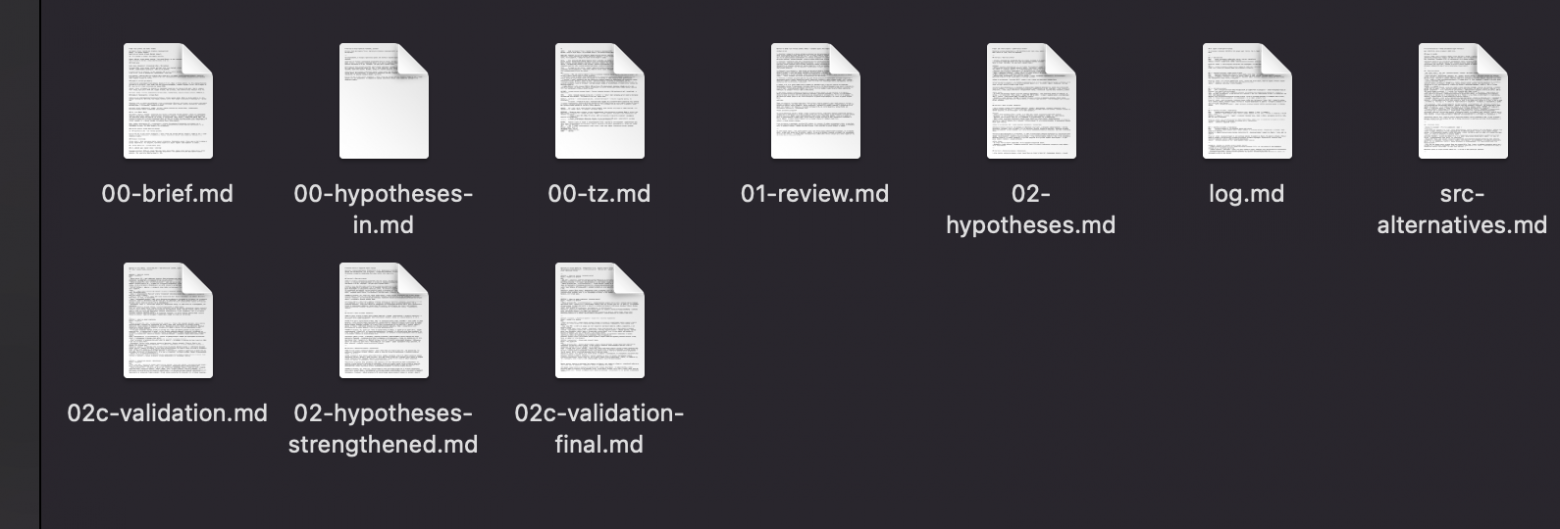
Всё, что происходит, система записывает в папку проекта. Вот как выглядит задача средней сложности:
Под капотом: проектная команда
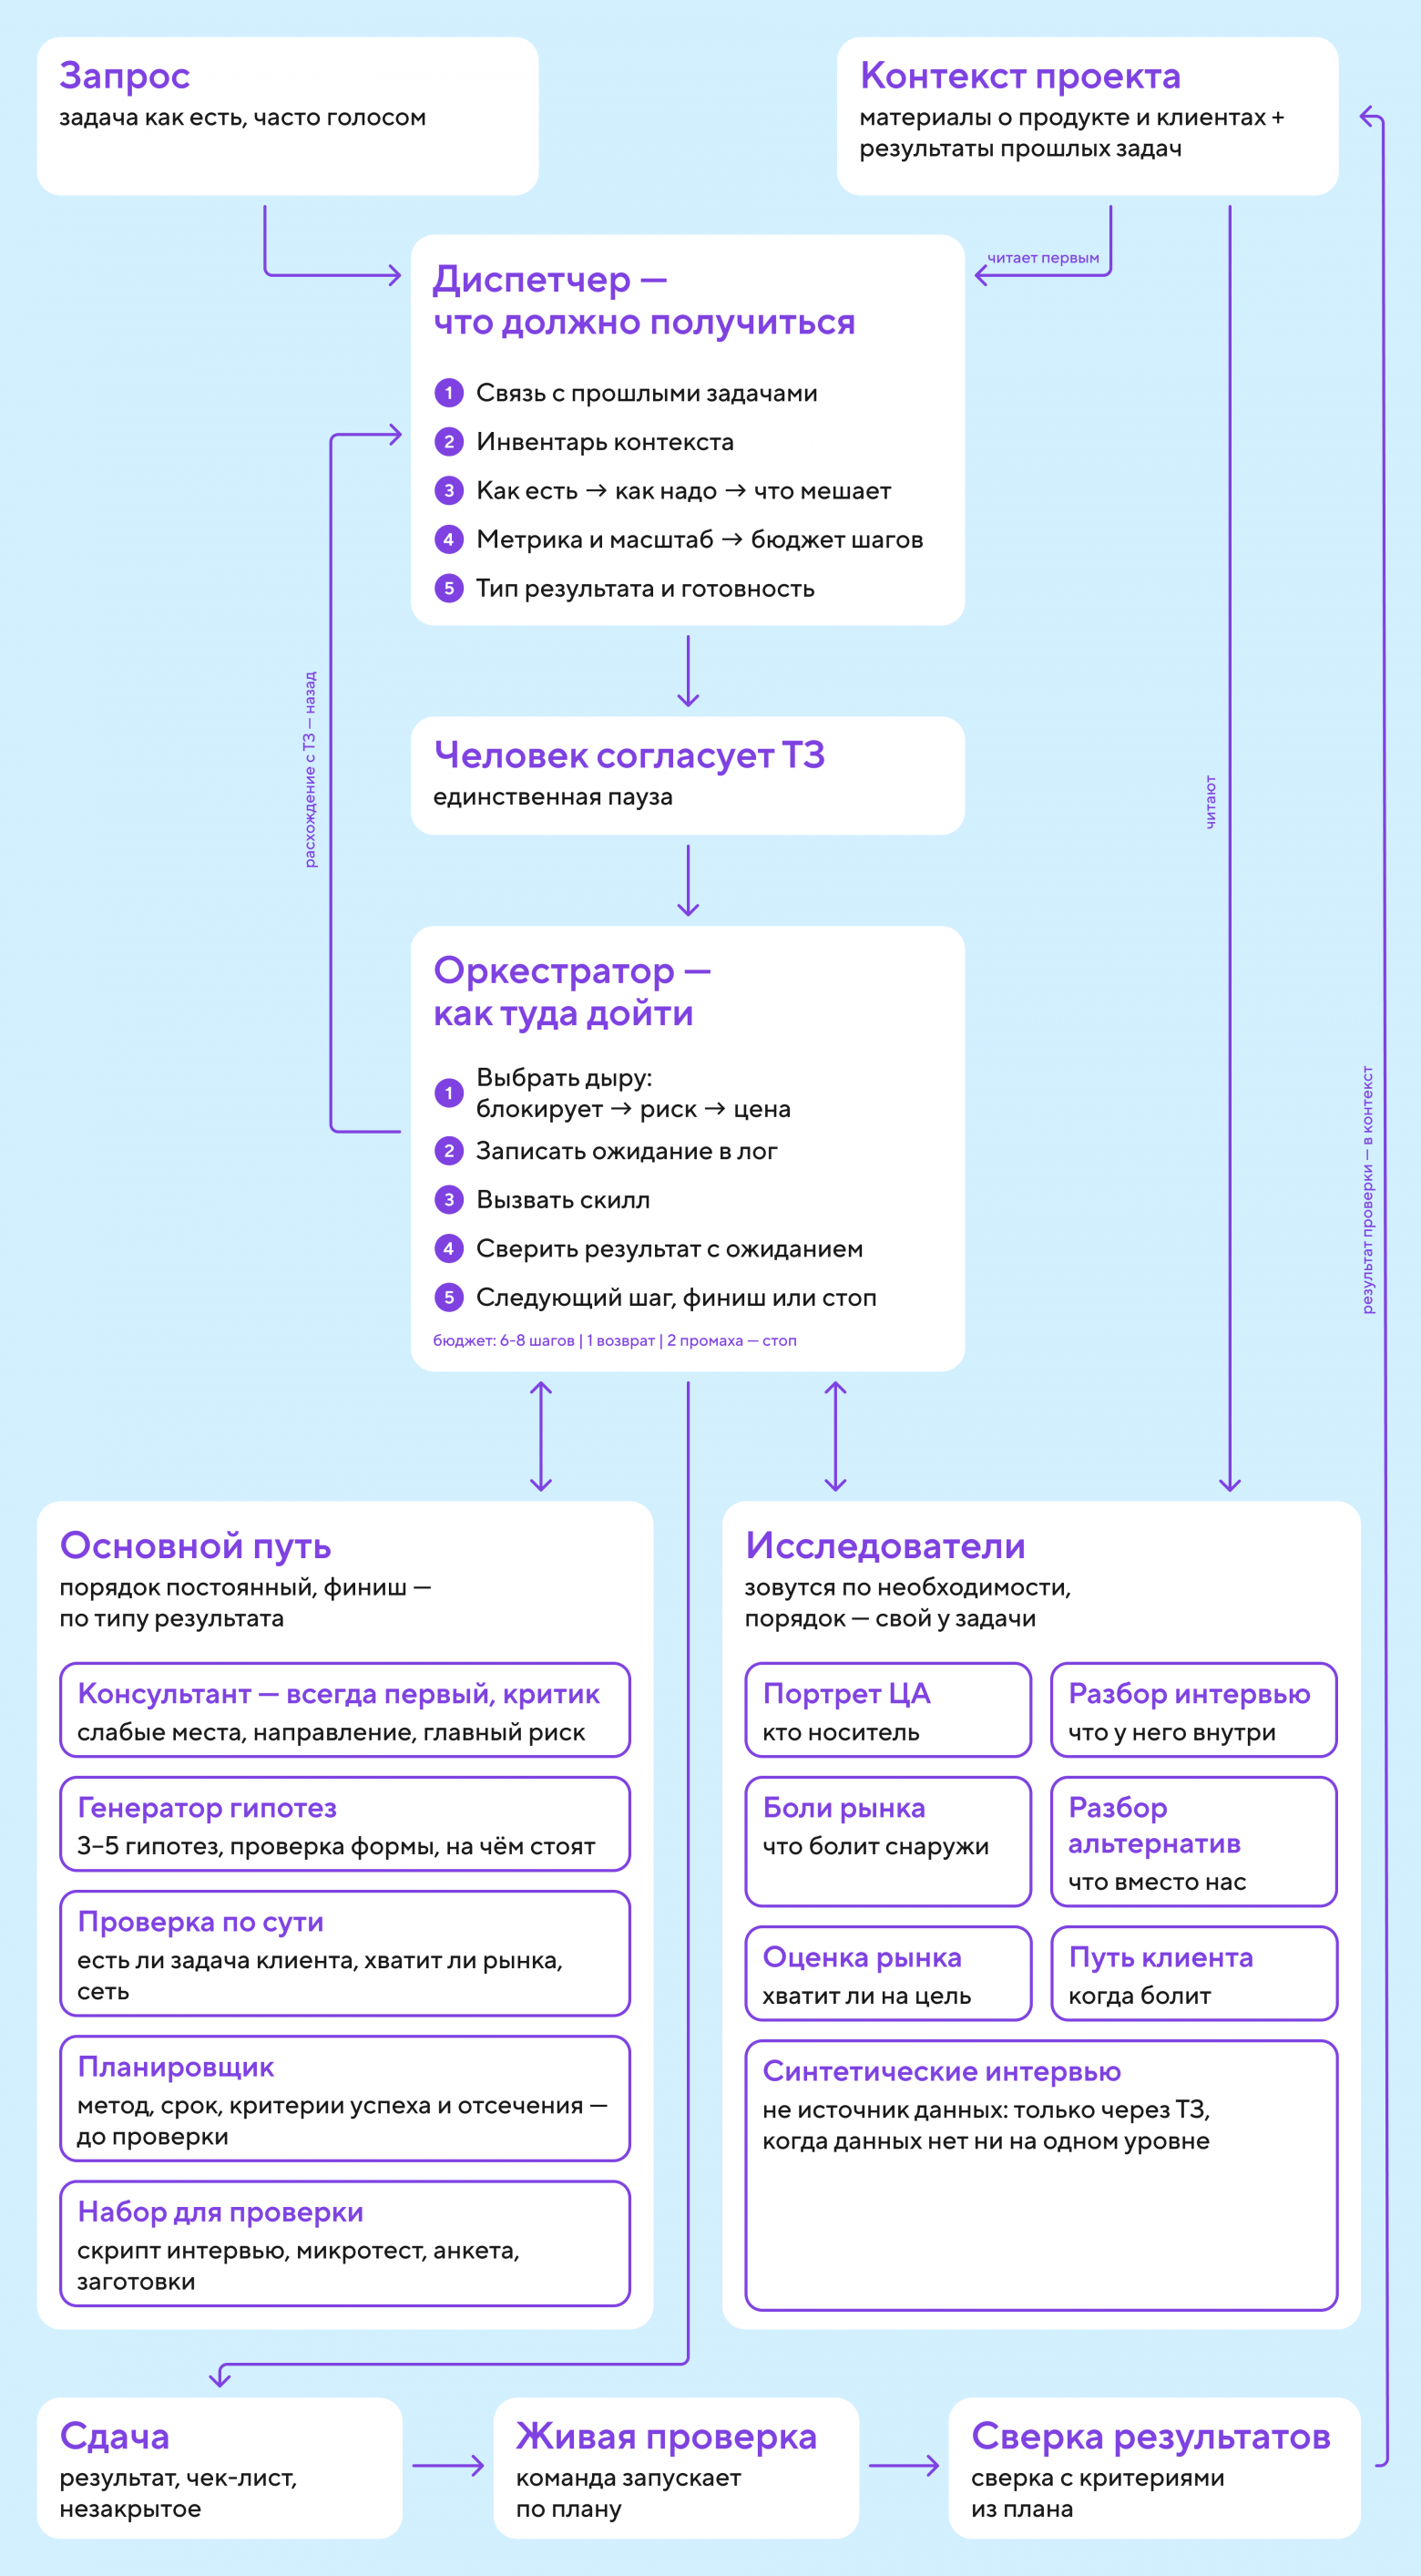
Система устроена как проектная команда: у каждой роли своё место, свои правила и доступы.
Диспетчер — бизнес-аналитик: выясняет, что просят, и пишет ТЗ. Ты как заказчик его согласуешь.
Оркестратор — менеджер: после каждого шага читает результат и решает, кого звать дальше.
Исполнители. Первым всегда идёт консультант — критик, который ищет слабые места и главный риск. Дальше по ситуации: генератор гипотез, валидатор, планировщик проверки. Если в данных дыра, оркестратор подключает шесть исследователей: сначала они смотрят в контекст проекта, потом идут в сеть за опровержением.
Провёл проверку вживую — результаты возвращаются в контекст, и следующая задача стартует с того, что уже известно.
Душная ремарка: каждая роль — это скилл, то есть инструкция в
SKILL.md. Оркестратор запускает её отдельным агентом в своём контексте, поэтому я и называю роли агентами; если среда не умеет запускать несколько агентов, один играет роли по очереди. Методология — фреймворки и протоколы вроде «как ходить в сеть» — лежит в одном месте, агенты открывают её как справочник, и правка доходит до всех сразу. Правила короткие: агент пишет только свой файл, чужие не трогает, инструкции не правит. По-инженерному вся эта обвязка называется харнессом.
Первый шаг — диспетчер
Всё, что система сделает дальше, она сделает под то, как поняла задачу. Поэтому ошибка в ТЗ дороже всех остальных, и именно здесь нужен человек: с ТЗ работаем, пока оно не станет чётким.
Настоящий бриф той истории я показать не могу, поэтому покажу механику на задаче попроще. Вот мой запрос и черновик ТЗ после первой итерации. Да, так я иногда формулирую задачи — и диспетчер вежливо показывает, что полнота у этого 1 из 5.
ТЗ (черновик, не согласовано)

ЗАПРОС:     «Давай расширим: давай соберем пул гипотез, которые могут
            расширить нам канальное проникновение в сегмент среднего и
            малого бизнеса исходя из контекстных ограничений»
ПОНЯЛ ТАК:  Нужен набор проверяемых гипотез о том, через какие каналы
            продукт может дойти до малого и среднего бизнеса, с учётом
            ограничений, которые ещё не названы.

AS-IS:      ? какой продукт, какие каналы работают сейчас и какая доля
              SMB (нет данных)
TO-BE:      Пул из 3–5 гипотез, у каждой указан механизм. Дальше их
            проверяет валидатор (без живой проверки они остаются кабинетными).
GAP:
  1. Неизвестно, какие каналы у вас уже есть и что они дают в SMB.
  2. Неизвестно, кто в SMB принимает решение о покупке: владелец,
     бухгалтер или ИТ-специалист.
  3. Неизвестно, какие ограничения считать жёсткими (бюджет, команда,
     сроки, продажи только через партнёров и т. п.).
  4. Неизвестно, кто из конкурентов и альтернатив уже занял эти каналы.
  5. Если у вас есть цель по числу клиентов или ARR: хватит ли
     компаний в сегменте.

СВЯЗЬ:      прошлых задач нет
КОНТЕКСТ:   прочитано — ничего (папка пуста)
            не хватает — описание продукта и цены; текущие каналы с
            долей выручки и клиентов по ним; причины потерянных сделок
            в SMB; 2–3 интервью с SMB-клиентами или отказавшимися
ПОЛНОТА:    1/5 — цель есть; нет AS-IS, клиента и фактов
ДОПУЩЕНИЯ:  — «канальное проникновение» понято как дистрибуция: партнёры,
              реселлеры, маркетплейсы, интеграции. Если вы имели в виду
              каналы привлечения (реклама, контент, outbound), скажите.
              [расшифровка спорная]
            — «контекстные ограничения» принято как ограничения
              вашего проекта; какие именно, вы не сказали.

МЕТРИКА:    доля SMB в новых клиентах (на каком уровне целей — уточню)
ТИР:        Tier 1 (новый сегмент), 8 шагов
ТИП ВЫХОДА: гипотезы
ТЗ отвечает на три вопроса:
-
Как поняли задачу.
ЗАПРОСхранит твои слова дословно,ПОНЯЛ ТАК— то, как их поняла система. Следи, чтобы в этой строке осталась твоя мысль, а не галлюцинация. «Канальное проникновение» можно понять и как дистрибуцию, и как каналы привлечения, поэтому диспетчер вынес это вДОПУЩЕНИЯ. Допущение, которое ты не поправил, дальше работает как факт. -
Что известно.
AS-IS,КОНТЕКСТиПОЛНОТАпоказывают, что система прочитала и чего ей не хватает. Полнота 1/5 значит: известна только цель, опереться не на что. Тут заказчик обычно подкладывает материалы, и ТЗ пересобирается.СВЯЗЬговорит, решали ли вы это раньше: уже отсечённое второй раз проверять не будут. -
Что решаем.
TO-BEиGAP— главное. GAP — список дыр, и каждую система закрывает отдельным шагом. «Неизвестно, кто в SMB принимает решение о покупке: владелец, бухгалтер или ИТ‑специалист» — хороший пункт: сразу понятно, кого звать. «Непонятна аудитория» — плохой.ТИРзадаёт бюджет шагов, чтобы система не ушла в цикл, аТИП ВЫХОДА— где закончится маршрут.
Согласованное ТЗ ложится в папку задачи файлом 00-tz.md с последней строкой СОГЛАСОВАНО: <дата>. Без неё оркестратор не стартует и возвращает задачу диспетчеру.
Оркестратор — мозг проекта
Самая сложная часть системы. Оркестратор не гонит задачу по конвейеру: после каждого шага читает результат и решает, кого звать дальше. Закреплён только первый шаг — консультант. Перед стартом оркестратор читает реестр агентов registry.md: что каждому нужно на вход, что он отдаёт и как выглядит его плохой результат. Из ТЗ берёт тир: у нашей задачи Tier 1, бюджет в восемь шагов, консультант входит в это число.
Шаг 1: консультант
Перед каждым вызовом оркестратор записывает в журнал log.md, зачем зовёт агента и чего ждёт:
ШАГ 1 — b2b-consultant
Дыра:     сама постановка задачи и главный риск (слабые места → GAP)
Слой:     зависимость — без разбора консультанта выбор дальше не начинается
Модель:   сильная
Ожидание: названо не меньше одного слабого места как разрыв логики,
          есть самое рискованное допущение и вопрос на проверку первым
Консультант работает в отдельном контексте и отдаёт четыре вещи: слабые места, рекомендованные направления, самое рискованное допущение и вопрос, который надо проверить первым. В шаблоне его вызова есть строка, которая потом оказалась важнее, чем выглядит: «Верни мне: путь к файлу, резюме в 3–5 строк и сигналы».
Цикл после каждого шага
-
Сверка. Оркестратор сравнивает результат с ожиданием из журнала и пишет «совпал» или «промах». Промах — когда ответ похож на плохой результат этого агента, а он описан в реестре заранее. Например, консультант назвал слабые места категориями вроде «нужна сегментация», а не разрывами в логике.
-
Стоп-сигналы — о них ниже.
-
Выбор следующего шага по открытым дырам (пять пунктов GAP плюс слабые места консультанта) и трём приоритетам: сначала то, без чего дальше нельзя; потом то, за чем стоит самое рискованное допущение; при равенстве — что дешевле.
-
Сразу следующий вызов — без остановки ради человека.
Как может пойти маршрут
Точный порядок заранее не знает даже оркестратор: он зависит от ТЗ и от рисков, которые увидит консультант. Для нашей задачи с пустой папкой контекста — скорее всего, так:
-
Сначала исследователи. Генератору нужны закрытые дыры, поэтому данные идут до него. Разбор альтернатив берёт пункты GAP 1 и 4: какие каналы есть и кто их занял. Портрет ЦА — пункт 2: кто в SMB принимает решение. В
context/пусто, поэтому оба идут в сеть поweb-protocol.md: искать не подтверждение, а опровержение, и ставить метки уверенности. Оценку рынка оркестратор, скорее всего, пропустит: она нужна только при цели в цифрах, а её нет. -
Потом генератор. 3–5 гипотез по слотам: кто, что меняем, какой эффект, через какой механизм. Каждая привязана к пункту GAP, а одну он нарочно строит мимо направления консультанта — это контрольная гипотеза. Плохой результат: четыре из пяти выросли из одной мысли. Вариантов нет, есть одна идея в разных обёртках.
-
Потом валидатор. Отдельный контекст, обязательный поиск опровержения в сети и вердикт каждой гипотезе: «держится на бумаге», «сузить» или «не держится». Плохой результат: согласился со всеми и не нашёл ни одного замечания. Скорее всего, не проверял, а поддакивал.
-
Остаток бюджета — запас на возврат назад, если понадобится.
Стоп-сигналы
Оркестратор останавливает маршрут, если:
-
консультант показал, что ТЗ ставит не ту задачу;
-
контрольная гипотеза оказалась сильнее остальных: значит, консультант ошибся;
-
валидатор нашёл противоречие с основанием ТЗ, например SMB через партнёров в такой форме не существует;
-
два промаха подряд;
-
кончились шаги.
ТЗ оркестратор сам не меняет. Он приносит человеку разбор и варианты с ценой каждого — оставить как есть, сузить, сменить тип результата, — и выбирает человек. Не всякое противоречие останавливает маршрут: если портрет ЦА и оценка рынка называют разный размер сегмента, расхождение уходит в журнал, а валидатор получает обе версии с метками уверенности.
Финиш
Чек-лист готовности оркестратор проходит механически: не меньше трёх гипотез прошли проверку формы, у каждой есть наблюдение, которое могло бы её опровергнуть, привязка к GAP и вердикт. Не сошлось — один автоматический возврат, например повторный вызов генератора. Возврат потрачен или шагов нет — остановка с описанием причины. Человек получает пул гипотез, чек-лист, маршрут, незакрытое из GAP и замечания к самой системе.
С чем приходить
Маршрут выше — для задачи типа «гипотезы». Но приходить можно с задачей в том виде, как она звучит у тебя в голове: диспетчер сам разберёт, какой нужен результат, а от этого зависит, где закончится маршрут.
|
Как звучит задача |
Что получаешь |
|---|---|
|
«Что не так с этой идеей?» |
разбор: слабые места, главный риск, что проверить первым |
|
«Что делать с проблемой X?», «Почему уходят клиенты?», «Найди ниши под целевую выручку» |
3–5 гипотез с вердиктом и меткой уверенности; для оттока — ещё и точка слома, для ниш — гипотезы только по живым |
|
«Проверь гипотезы, которые я подготовил» |
аудит: какие держатся как есть, какие усилены (было → стало → почему), какие отклонены и почему |
|
«Доведи до проверки» |
критерии успеха и отсечения, скрипты интервью, тексты микротестов |
|
«Вот результаты теста» |
вердикты: подтверждено, переформулировать или отсечено; результат уходит в контекст |
Самый короткий маршрут — разбор: один агент, и всё. Самый длинный — аудит чужих гипотез: консультант, проверка формы, исследователи по дырам, валидатор, потом генератор усиливает выжившее, и валидатор проверяет ещё раз.
Готовых маркетинговых материалов система не пишет — ни текстов для сайта, ни памяток для продаж, ни плана запуска: упаковка идёт следующим шагом. И не гоняет весь маршрут ради «поправь заголовок на лендинге» — на такое отвечает коротко.
Звучит сложно — так оно и есть. Каждое правило здесь выросло из того, как агент однажды обманул сам себя.
Семь способов, которыми агент обманывает себя
-
Жёсткий маршрут промахивается. Задачи приходят разными: с готовой идеей, с одной цифрой, с результатами теста. Зашитый порядок на части из них пропустит нужное или сделает лишнее. Поэтому постоянен только первый шаг, консультант, а остальное решается по ходу. Как с оценкой рынка, которую в нашей задаче оркестратор пропустил.
-
Агент берётся не за то. Без правила выбора он хватается за то, что подвернулось первым, или за то, для чего ещё нет данных. Отсюда три приоритета из цикла и сверка с реестром вместо суждения модели.
-
Хороший ответ выглядит как финиш. На живых прогонах система вставала после консультанта: его разбор выглядел готовым, и агент вежливо ждал «продолжай». Поэтому выход любого агента идёт оркестратору, и отсюда та самая строка «верни мне: путь, резюме, сигналы». Человеку оркестратор пишет только при сдаче, остановке или вопросе о втором возврате.
-
Без тормоза агент перепроверяет себя бесконечно. Модели нравится «ещё раз уточнить» — как стажёру, который боится сдать работу. Поэтому ожидание записывается до вызова и так, чтобы его можно было проверить. Один агент не вызывается повторно на том же входе, а назад можно вернуться один раз самому, второй раз только с согласия человека.
-
Агент хватается за любую задачу. Исполнители любят предлагать «заодно разобрать сегмент B», и без фильтра это не закончится. Каждое такое предложение проходит через метрику и тир из ТЗ: не двигает метрику — не берётся, но в сдаче отмечается.
-
Упёрся — переписывает правила. Когда задача не решалась, оркестратор однажды начал править собственные инструкции, чтобы она «решилась». Запрет записан в трёх файлах: в инструкции оркестратора, в
AGENTS.mdи в реестре. Инструкции агентов и реестр по ходу задачи не правятся и не предлагаются к правке. Если правило мешает, оркестратор пишет замечание с пометкой[система]: оно уходит отдельным блоком в сдачу и в журналsystem-notes.md. Правила меняет человек. -
Инструмент пересказывает вместо страницы. Встроенный инструмент чтения страниц отдаёт агенту пересказ: страницу читает малая быстрая модель и сжимает до ответа на запрос. Представь аналитика, который цитирует не отчёт, а пересказ отчёта от практиканта. В нескольких итерациях я находил ошибки в цитатах, а иногда и выводы выходили наоборот. Поэтому правило протокола: пересказ — не свидетельство. Всё, на чём держится вывод — цифра, цитата, название, вердикт, — агент берёт из сырого текста страницы: скачивает, чистит от вёрстки и находит фрагмент поиском. Цитата, которой нет в сыром тексте дословно, не засчитывается. Пересказ годится для разведки — понять, куда смотреть.
Как не наделать глупостей
Вернёмся к моему провалу. Я собирал всё по правилам и всё равно проморгал пять дыр. Причин четыре, и все они про подход. На каждую в системе теперь есть правило.
-
Знание разрознено → три контекста. Каждая идея проходит через три слоя: что известно о продукте и клиентах, что происходит на рынке, что уже проверяли раньше. Первое лежит в папке контекста проекта, второе добывается в сети, третье система помнит сама: поле
СВЯЗЬв ТЗ показывает, решали ли вы это раньше, а уже отсечённое второй раз не проверяется. Память копится только из фактов: после сдачи оркестратор переносит вcontext/from-tasks/разборы исследователей и результаты живой проверки, но не гипотезы и не вердикты. Иначе через пару прогонов система начнёт цитировать собственные догадки как факты. -
Допущения не сверяли → засчитывается только случившееся. «Рынок большой» и «клиентам это нужно» в системе не считаются опорой. Свидетельство — это то, что реально произошло: «в марте нашли ошибку уже после отправки аудитору». «Я бы этим пользовался», «у всех так», статья вендора о боли рынка свидетельствами не являются. Синтетический респондент тоже: с придуманным собеседником ничего не случалось. Поэтому синтетические интервью включаются только через ТЗ, когда о клиенте нет данных вообще, и всё, что из них выросло, идёт на живую проверку первым. Отсюда же ещё два правила. «Держится на бумаге» — ещё не «подтверждено»: проверка на бумаге лишь готовит гипотезу к эксперименту, подтвердить её может только рынок. И критерии успеха записываются до проверки и после результатов не двигаются: пять из десяти при планке «семь» — не «почти успех».
-
Родительская любовь → кто строит, тот не проверяет. Генератор и валидатор — разные агенты в разных контекстах. Направление консультанта тоже проверяется — контрольной гипотезой. А модель сверяет, но не оценивает. Готовность, прогресс и промахи проверяются по пунктам, записанным заранее. Вопрос «хорошо ли получилось» модели не задаётся никогда — на него она всегда ответит «да».
-
Сеть подтверждает всё → сеть на опровержение. Каждый агент, который идёт в сеть, ищет не подтверждение, а то, что гипотезу убьёт. Найденное взвешивается по уровню источника: прямая речь клиентов весит больше отраслевого отчёта, а материалы вендоров как доказательство боли не засчитываются вовсе — они написаны, чтобы её утверждать. Высокая уверенность — три и больше независимых источника разных уровней, среди них прямая речь. Низкая значит: проверить вживую первым. И молчание сети гипотезу не опровергает: в узком B2B ничего не найти — нормально.
При этом решения всегда за человеком. Цель меняет только он, а система ничего не выбрасывает молча: отклонённые гипотезы видны в сдаче с причиной, и их можно вернуть.
Это всё ещё не скайнет
Модель, которая проверяет гипотезы модели, остаётся моделью — той самой шарманкой из начала, только с правилами. Раздельные контексты, правило свидетельства и поиск опровержения сужают зазор, но не закрывают его. Поэтому последнее слово всегда за живой проверкой, но теперь в неё выходишь подготовленным.
Гонял систему на разных моделях. На слабых результат, скажем так, другой: инструкции длинные, и не всякая модель дотягивает их до конца. Поэтому в сдаче есть чек‑лист готовности: по нему видно, выполнила модель инструкцию или проскользила по ней.
Понять заранее, что снова не ошибёшься, нельзя. Но можно сделать так, чтобы ошибка проявлась раньше и стоила пару разговоров, а не ресурсов нескольких команд и бюджет на промо.
В следующих материалах расскажу, как работать с контекстом, чтобы снизить галлюцинации и системно искать инсайты. Также — как правильно ходить в сеть и планировать исследования, чтобы получать реальные валидные данные, а не переработанный фарш. А если прогоните через систему свою гипотезу до запуска, напишите в комментариях, совпал ли вердикт с тем, что было дальше. Мне правда интересно, где она ошибается.
Автор: Dingzhibo