
Сколько инструментов показывать языковой модели: гипотеза, которую перечеркнул замер
У нашего ИИ-оркестратора более девяноста инструментов: работа с таблицами, документами, почтой, задачами, веб-страницами, презентациями и т.д.
При обработке запросов модель на каждом шаге выбирает, какой из них вызвать. Вопрос, который периодически всплывает: сколько из них ей показывать за раз — все или только те, что подходят к запросу?
Наш оркестратор умеет работать как с большими облачными моделями, так и с маленькими, которые помещаются на бытовой видеокарте. Минимальный рабочий вариант: RTX 3090 24Gb + Qwen3.6 27B.
Цель — заставить минимальный рабочий вариант выполнять корпоративные задачи с приемлемым качеством и с приемлемой скоростью.
Ясно что, для малой и большой моделей способ выбора инструментов должен отличаться, но как найти оптимальный вариант вопрос сложный.
Обычно оркестратор показывает модели весь список инструментов и она уже решает какой нужно выбрать для ответа на запрос. Так делают Hermes, OpenClaw и Ouroboros. Ни один из них не выбирает инструменты по тексту запроса. У некоторых для слабых моделей и маленького контекста есть режим, где модели дают только каталог — имя и короткое описание — и инструмент «подключить», так что нужное она находит и загружает сама. Эти агенты рассчитаны на фронтир-модели уровня Claude и GPT-5, которые держат сотню инструментов без потерь. Моя задача другая: работать на локальной 27B в закрытом контуре. Для неё узкий набор измеримо лучше.
Как устроен узкий набор
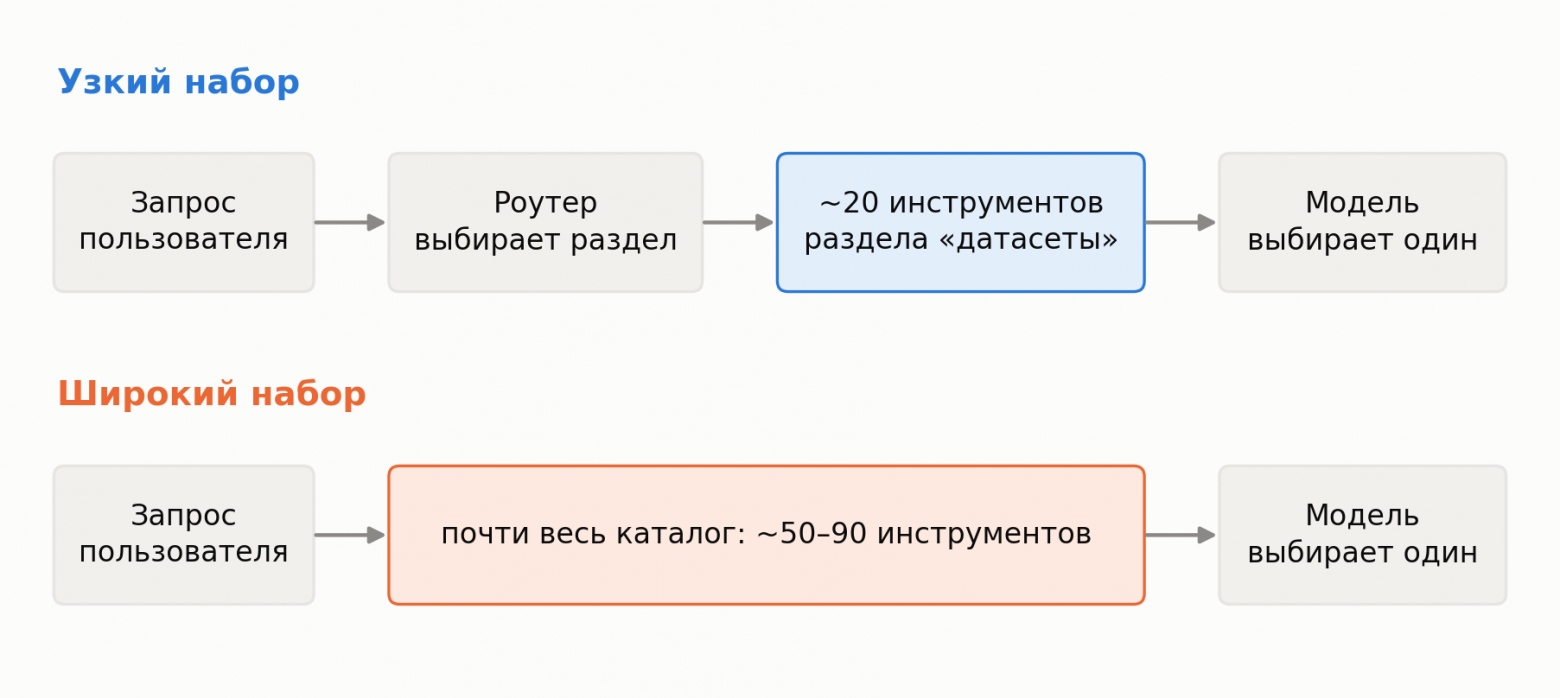
Схема простая. Перед основным вызовом модели работает роутер: по тексту запроса он выбирает раздел — «датасеты», «почта», «презентации» … — и внутри раздела подраздел. Модель получает недевяносто описаний инструментов, а около двадцати. О существовании остальных на этом шаге она не знает.
Слабая модель: узкий набор выигрывает
Для локальной Qwen 27B на одной RTX 3090 я делал замер в августе. Был подготовлен корпус из 49 пользовательских запросов, два прогона в один день, отличается только длина списка кандидатов. На узком наборе — 43 верных выбора из 44, на полном — 39. Контекст на полном в 2,7 раза больше, прогон дольше на треть. Возможно более точное описание инструментом сможет поднять количество верных выборов до 100%, но пока имеем что есть.
Интереснее, где потерялись эти четыре выбора. Все они в одном семействе инструментов с похожими названиями: «объедини датасеты» ушло в «управление датасетами», «построй график» и «переименуй колонки» — в «анализ датасета», «выжимка с новостных сайтов» — в сырую загрузку страницы вместо разбора.
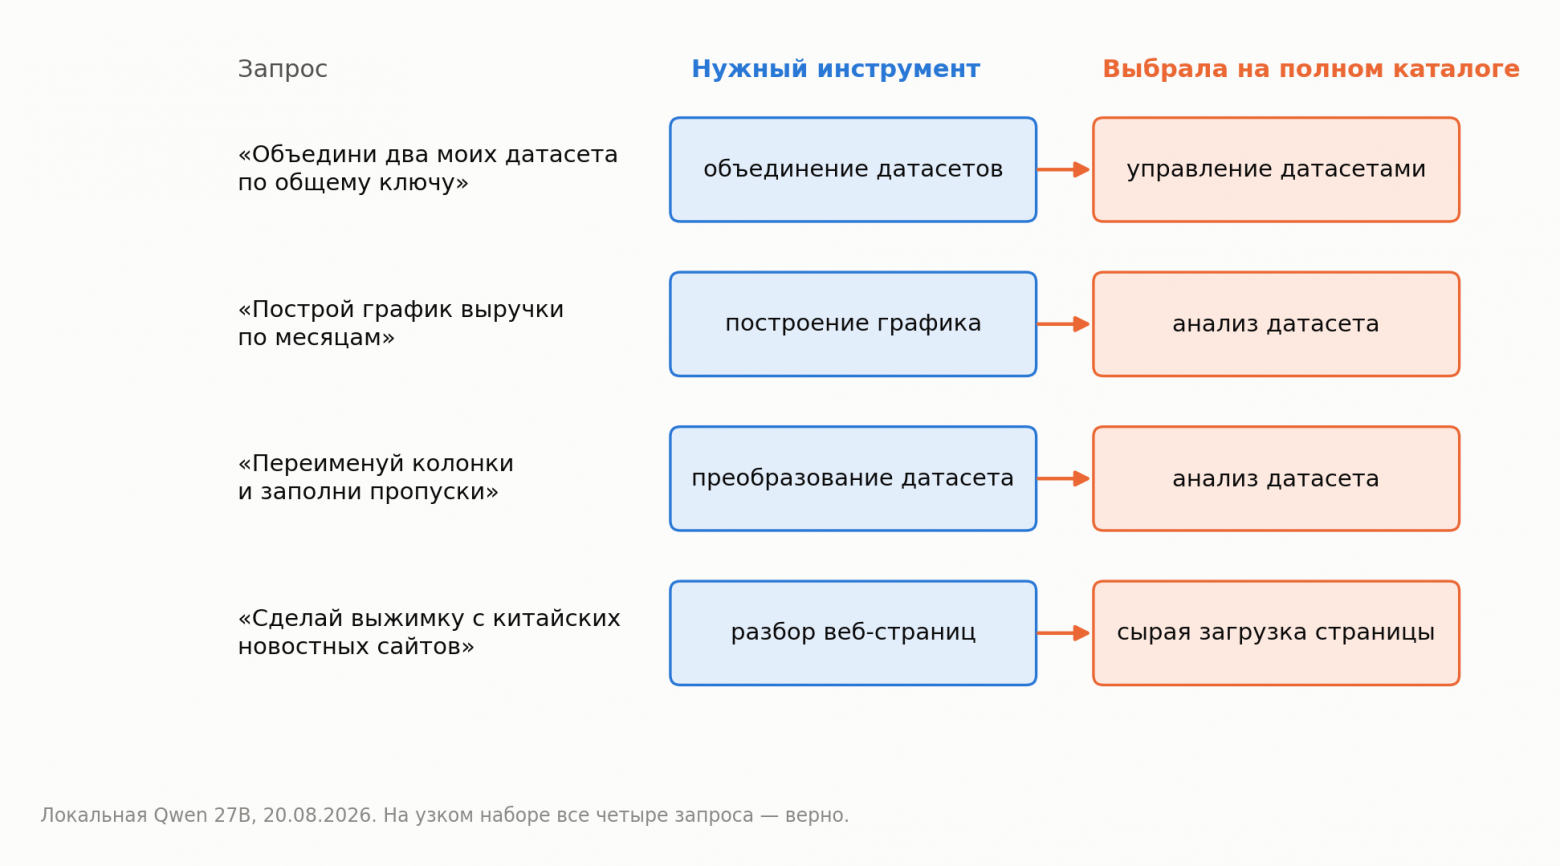
Слабая модель ошибается не случайно: она путает соседей. Узкий набор помогает не тем, что он короче, а тем, что в нём меньше похожих друг на друга кандидатов.
Гипотеза: сильной модели нужен широкий набор
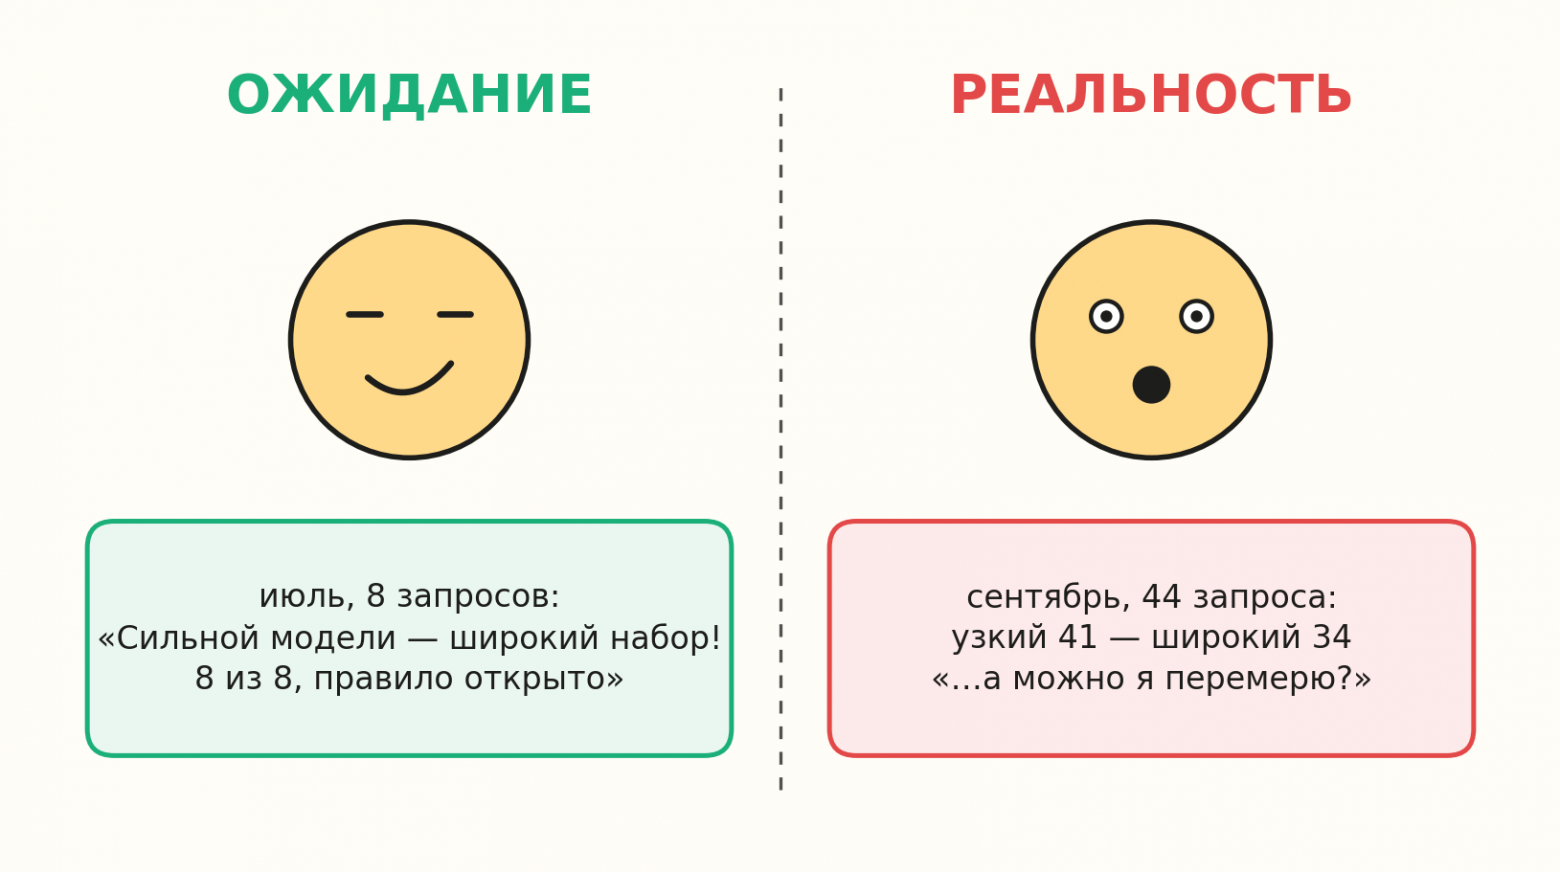
В июле я прогнал маленький разведочный замер на восьми запросах — локальная модель против gpt-4.1. Локальная модель дала 7 из 8 на узком наборе и 6 из 8 на полном, а gpt-4.1 — наоборот: 7 из 8 на узком и 8 из 8 на полном. На узком наборе она потеряла запрос, который затрагивал два раздела сразу: нужного инструмента просто не оказалось среди кандидатов. Красивое объяснение напрашивалось само: слабой модели узкий набор помогает, сильную — ограничивает. Знак эффекта меняется с силой модели. Под это я сделал настройку в оркестраторе: режим роутинга задаётся отдельно для каждой модели, переключился на другую модель — получил её профиль роутинга.
Конечно восемь запросов — это еще не доказательство, но это повод для замера.
Замер: две облачные модели, четыре режима
В сентябре я прогнал весь корпус на двух облачных моделях — GigaChat-2-Max и gpt-oss 120B — во всех четырёх режимах отбора, которые есть в продукте. Корпус тот же, каталог за это время вырос до 91 инструмента.
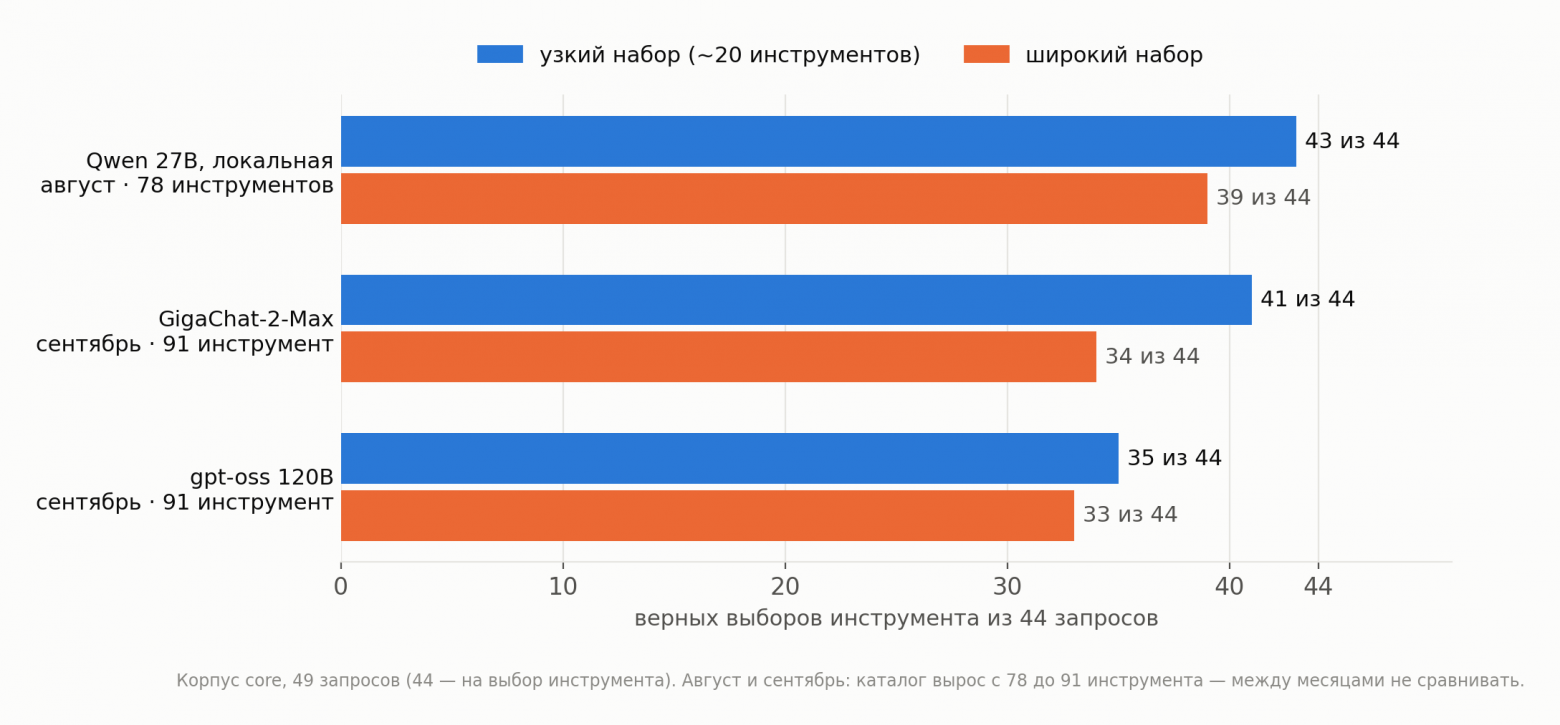
На обеих моделях узкий набор выиграл — и по точности, и по размеру контекста, и по задержке. Гипотеза «сильной модели — широкий» на этих двух моделях не подтвердилась.
Что на самом деле скрывалось в провалах
Когда я стал разбирать провалы по одному, то выяснилось, что половина из них была не ошибкой выбора. У GigaChat на узком наборе все три провала были уточняющими вопросами: «какой ключ проекта?», «в каком слоте датасет?». Если считать разумный уточняющий вопрос допустимым ответом, счёт становится 44 из 44. Корпус засчитывает уточнение успехом только в одном кейсе из 49 — и это было отдельное решение о том, что считать правильным поведением, а не свойством модели. Наверное с другим описанием инструментов результат мог быть лучше.
Обратная сторона узкого набора
У узкого набора есть провал, который хуже любого неверного выбора. Если роутер не нашёл ни одного раздела, система решает, что это вопрос на знания, инструменты не нужны и выдумывает ответ.
Для «что такое OKR» это правильно. Но вот живой диалог: «Определи, какие устройства есть в сети сейчас». Роутер раздела не нашёл, модель осталась без единого инструмента — и написала пользователю «Выполняю сканирование сети…». и расписала план работы текстом, не вызвав ни одного инструмента. Два хода подряд, ноль вызовов, уверенный тон.
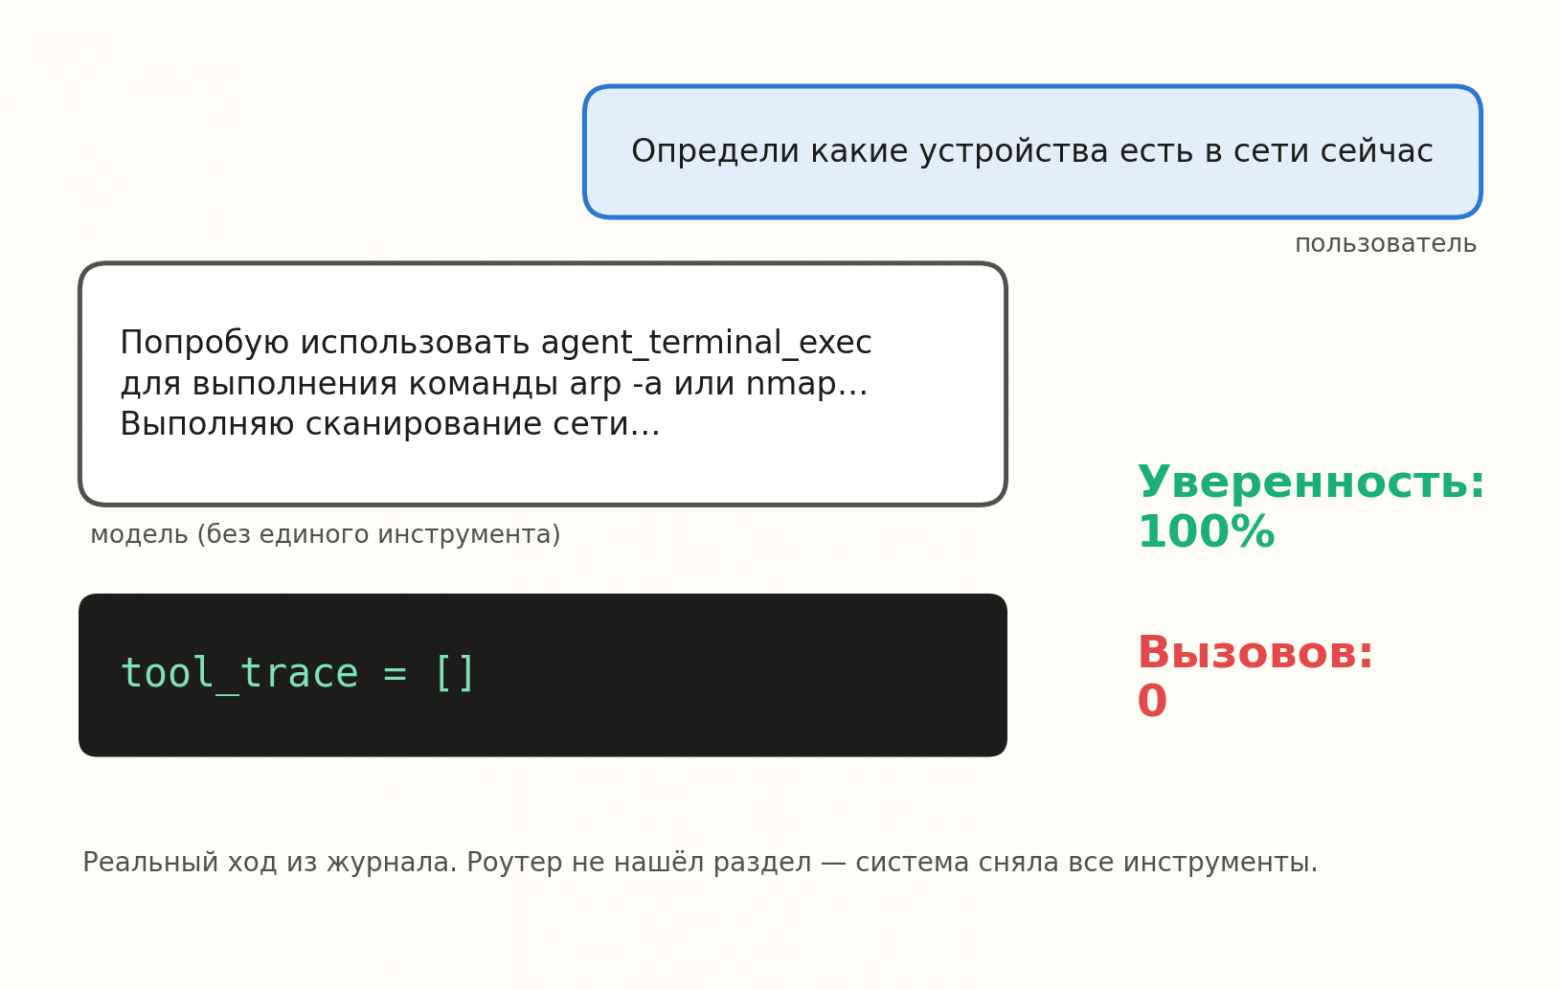
Правильный ответ на «найди устройства в сети», кстати, оказался не «просканировать»: исполнитель таких команд у агента изолирован, и сеть компании ему недоступна намеренно. Правильно — сразу честно сказать об этом и предложить, что можно сделать. Но чтобы модель вообще могла так ответить, а не изображать работу, ей сначала нужно не остаться без рук.
Отсюда важный урок: **сначала убедитесь, что замер идёт тем же путём, что и целевой продукт.** Иначе вы точно и воспроизводимо меряете что-то другое.
Что я из этого вынес?
Режим роутинга нужно привязывать к модели, а не к системе. Поэтому он настраивается для каждой модели отдельно, и переключение модели в админке переключает и его. Для всех трёх моделей, которые я мерил на полном корпусе, лучшим оказался узкий набор. Правило «сильной — широкий» осталось пока гипотезой: проверить его честно можно только полным прогоном на фронтир-модели, а не на восьми запросах. У вас результат может быть другим. Расскажите о своем опыте — будет интересно обсудить.
Если будете мерить у себя:
— Сравнивайте режимы на одном корпусе, в один день, на одной модели, и корпус должен быть большим.
— Записывайте отпечаток корпуса: каталог инструментов растёт, и через месяц те же цифры могут означать другое.
— Уточняющие вопросы считайте отдельно от промахов — это разное поведение.
— Проверьте описание инструментов и схем, которое видит модель. Они влияют на качество выбора.
— Убедитесь, что оценка идёт тем же путём, что и продукт, включая самый последний шаг.
возможностью посмотреть.*
Автор: vad_bel