
45% наших ИИ-отчетов получали тройку и ниже: как мы считали метрики и что нашли
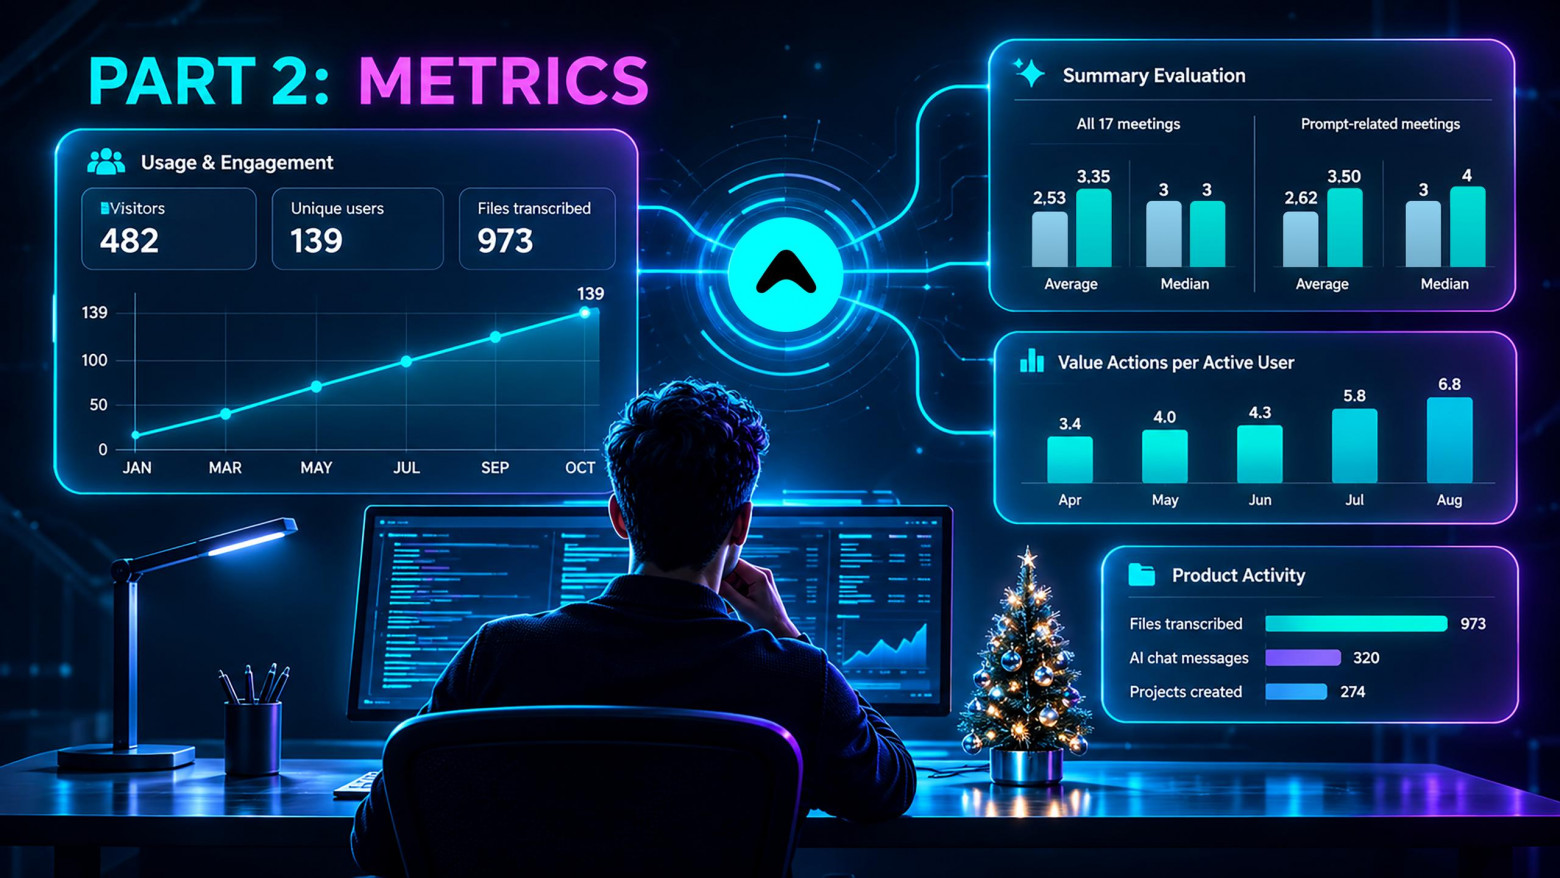
Когда мы впервые посмотрели на автоматические оценки ИИ-отчетов по рабочим встречам (по пятибалльной шкале), оказалось, что 45% из них получают тройку и ниже. Чтобы понять, плохо это или нет и где искать причину, нам сначала пришлось научиться считать: кто пользуется нашими сервисами, возвращается ли к ним и что в итоге получает. Об этом пути, от списка посетителей в админке до ручного разбора 56 отчетов, и расскажем в этой статье.
Всем привет, мы Юлия Ефимова и Майя Азарова, представляем продуктовую часть команды AI LAB в компании Атом. В предыдущей статье был рассказ о том, как Транскрибатор для UX-исследователей вырос в отдельное направление внутренних ИИ-сервисов. Сегодня расскажем о пути к метрикам для нашего портфеля внутренних ИИ-инструментов:
-
Transcriber — Транскрибатор, на его примере поговорим о метриках в этой статье;
-
Atom Intelligence — ИИ-чат для всей компании с подключением различных внутренних источников данных и корпоративной базы знаний;
-
DDM — смарт-мониторинг задач в Jira, формирование дашборда и отчетов по настройкам пользователя и напоминания о срочных задачах;
-
TAR — ИИ-ревью кода и генерация тестов в GitLab по слэш-командам в merge request.
Транскрибатор стал первым ИИ-продуктом, поэтому именно на нем мы изначально обкатывали набор метрик, которые в итоге оформили в общий каркас и решили единообразно распространить на весь портфель. То есть не совсем единообразно, конечно, но обо всем по порядку.
Когда мы поняли, что мало что знаем о наших пользователях?
Первой аудиторией Транскрибатора, как мы уже говорили, были UX-исследователи, а это около десяти человек с общим контекстом. Они сами сформулировали требования, работали с сервисом еженедельно и напрямую сообщали о возникающих проблемах. Продукт находился на ранней стадии развития и управлялся фактически вручную. Как только мы расширили целевую аудиторию на других сотрудников компании и добавили анализ новых типов встреч, мы поняли, что у нас нет ответа на целый ряд вопросов о нашем продукте, например:
-
приносит ли сервис пользу новой аудитории?
-
растет ли число активных пользователей?
-
коллеги ограничиваются первым визитом или возвращаются к инструменту?
-
сколько времени может экономить каждый созданный артефакт?
С этих вопросов и началась работа над метриками.
Список пользователей
Мы начали с самого простого анализа: отдельная вкладка в админ-панели со списком тех, кто заходил в сервис (их почта, дата первого визита, отметка о том, совершил ли сотрудник хотя бы одно действие). Мы сразу же заметили закономерность, что каждая публикация в нашем рабочем канале создавала волну заходов из 10–20 человек в течение часа. Однако такой список отвечал на вопрос, кто проявил интерес, но не на вопрос, что произошло дальше. Посмотрел пользователь интерфейс и закрыл вкладку или все-таки загрузил файл и забрал транскрипт — по таблице было не определить.
Параллельно мы собирали обратную связь прямо в продукте тремя способами: лайки и дизлайки на ответы ИИ-чата с указанием категории проблемы; комментарии в свободной форме; оценки артефактов по пятибалльной шкале, отдельно для ИИ-отчета, транскрипта и чата.
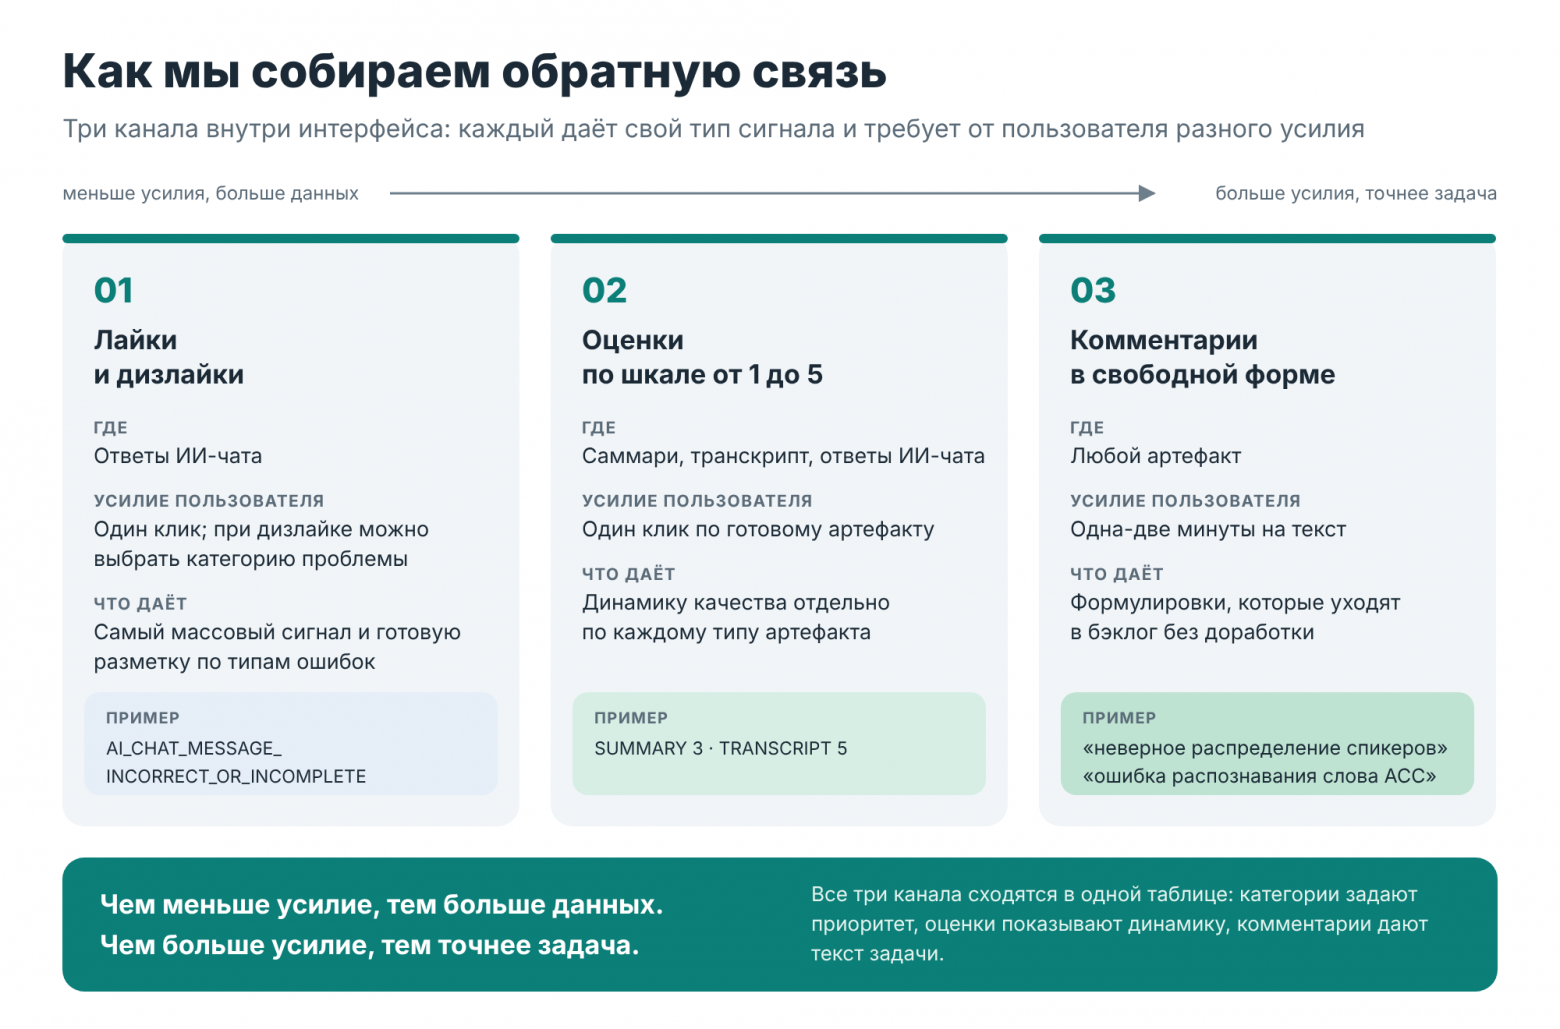
Самой полезной частью на начальном этапе оказались комментарии в свободной форме. Формулировки вида «неверное распределение спикеров», «формат минуток нужно изменить, добавить в начало все темы списком», «ошибка распознавания слова ACC» напрямую превращались для нас в доработки. Обобщенная оценка 3/5 такой возможности не дает.
Первые метрики
Мы начали выводить метрики, которые можно сразу смотреть в разных временных разрезах — за день, месяц, год и любой период по календарю.
В первой итерации набор метрик был простым:
-
посетители за период;
-
активные пользователи за период;
-
новые пользователи;
-
количество созданных проектов, загруженных и расшифрованных файлов.
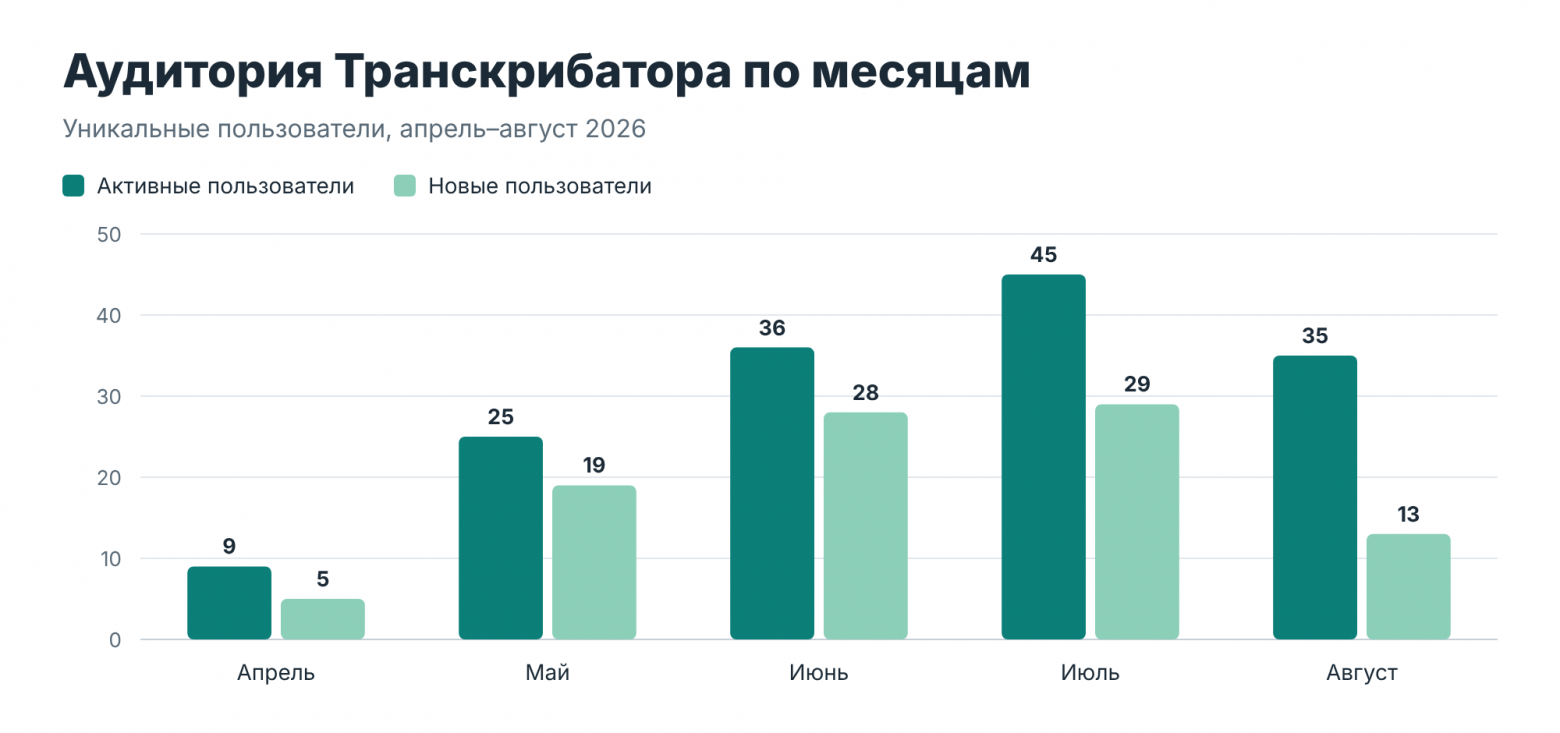
Активные и новые пользователи Транскрибатора по месяцам, апрель – август 2026
Этого набора хватило, чтобы увидеть динамику. Число новых пользователей в месяц выросло с 5 в апреле до почти 30 в июне и июле, а в августе снизилось примерно до 13.
В августе мы не выпускали новых функций: команда завершала рефакторинг и готовила следующий релиз. Суммарное число сотрудников, хотя бы раз выполнивших действие в сервисе, к концу августа достигло почти 100 человек. Однако полученные цифры по-прежнему не отвечали на два ключевых вопроса: приносит ли сервис пользу и возвращаются ли наши коллеги к инструменту?
Польза, возвраты и ошибки
Прежде чем строить следующий слой, мы договорились о терминах и определили, что считаем полезным, или ценностным, действием. Выделили набор ценностных действий, то есть таких, ради которых пользователь приходит в сервис: скачивание готового документа, получение транскрипта, посещение страницы ИИ-отчета (более одной минуты), обратная связь по артефактам, ответ ИИ-чата по материалам встречи. Все остальное, включая короткие визиты (менее одной минуты), посчитали служебными событиями.
Кроме того, добавили метрики DAU (daily active users, уникальные активные пользователи за день), WAU (weekly active users, за неделю), MAU (monthly active users, за месяц) и «липкость» (stickiness) — отношение DAU к MAU, а также среднее число ценностных действий на одного активного пользователя. Последний показатель особенно интересен, потому что он вырос примерно с 3,4 в апреле до 6,8 в августе.
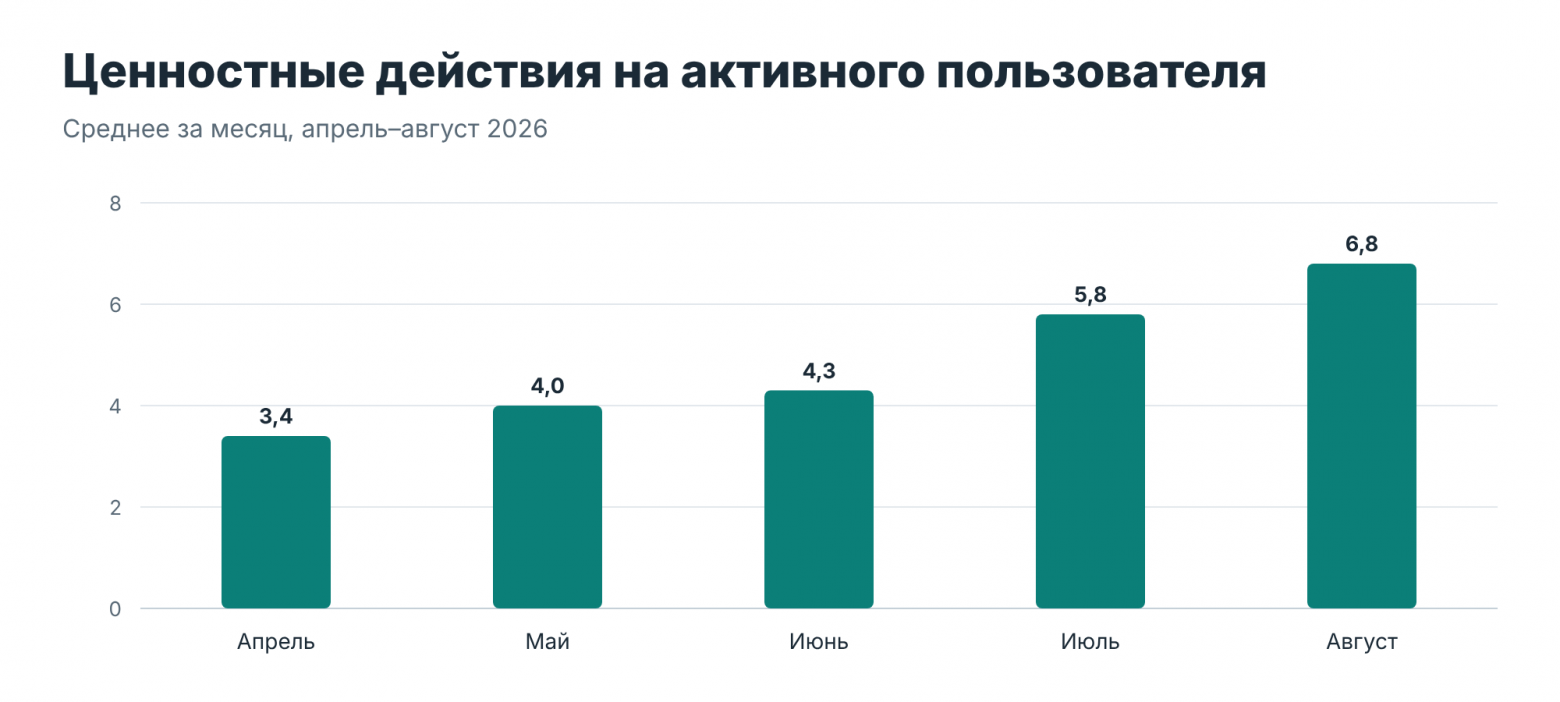
Среднее число ценностных действий на активного пользователя, апрель–август 2026
Аудитория за тот же период выросла в разы, и при этом глубина использования не размылась, а удвоилась. Если бы рост обеспечивали единичные визиты из любопытства, среднее пошло бы вниз. С 24 августа, когда данные о визитах стали полными (до этого часть заходов могла не попадать в статистику), доля посетителей, совершивших хотя бы одно действие, держится выше 80%.
«Липкость» в большинстве рабочих дней держится в диапазоне 10–25%, с отдельными пиками до 45% и нулями в выходные. Для Транскрибатора это нормально, потому что пользователи приходят тогда, когда у них прошли исследования, были важные встречи или звонки, требующие обработки. Естественный ритм здесь скорее недельный, а не ежедневный.
Отдельный блок нашего дашборда с метриками посвящен тому, что ломается. Мы добавили число ошибок транскрибации за период и отношение неуспешных вызовов к успешным.
Общая рекомендация: не забывайте выводить на дашборд не только позитивные метрики, но и метрики-противовесы, иначе у вас всегда будет только обманчиво приятная картинка. Также важно, чтобы вся команда согласилась, как интерпретировать полученные метрики и какое поведение пользователей конкретного продукта на конкретном этапе развития является нормой.
Куда мы движемся: от использования к бизнес-эффекту
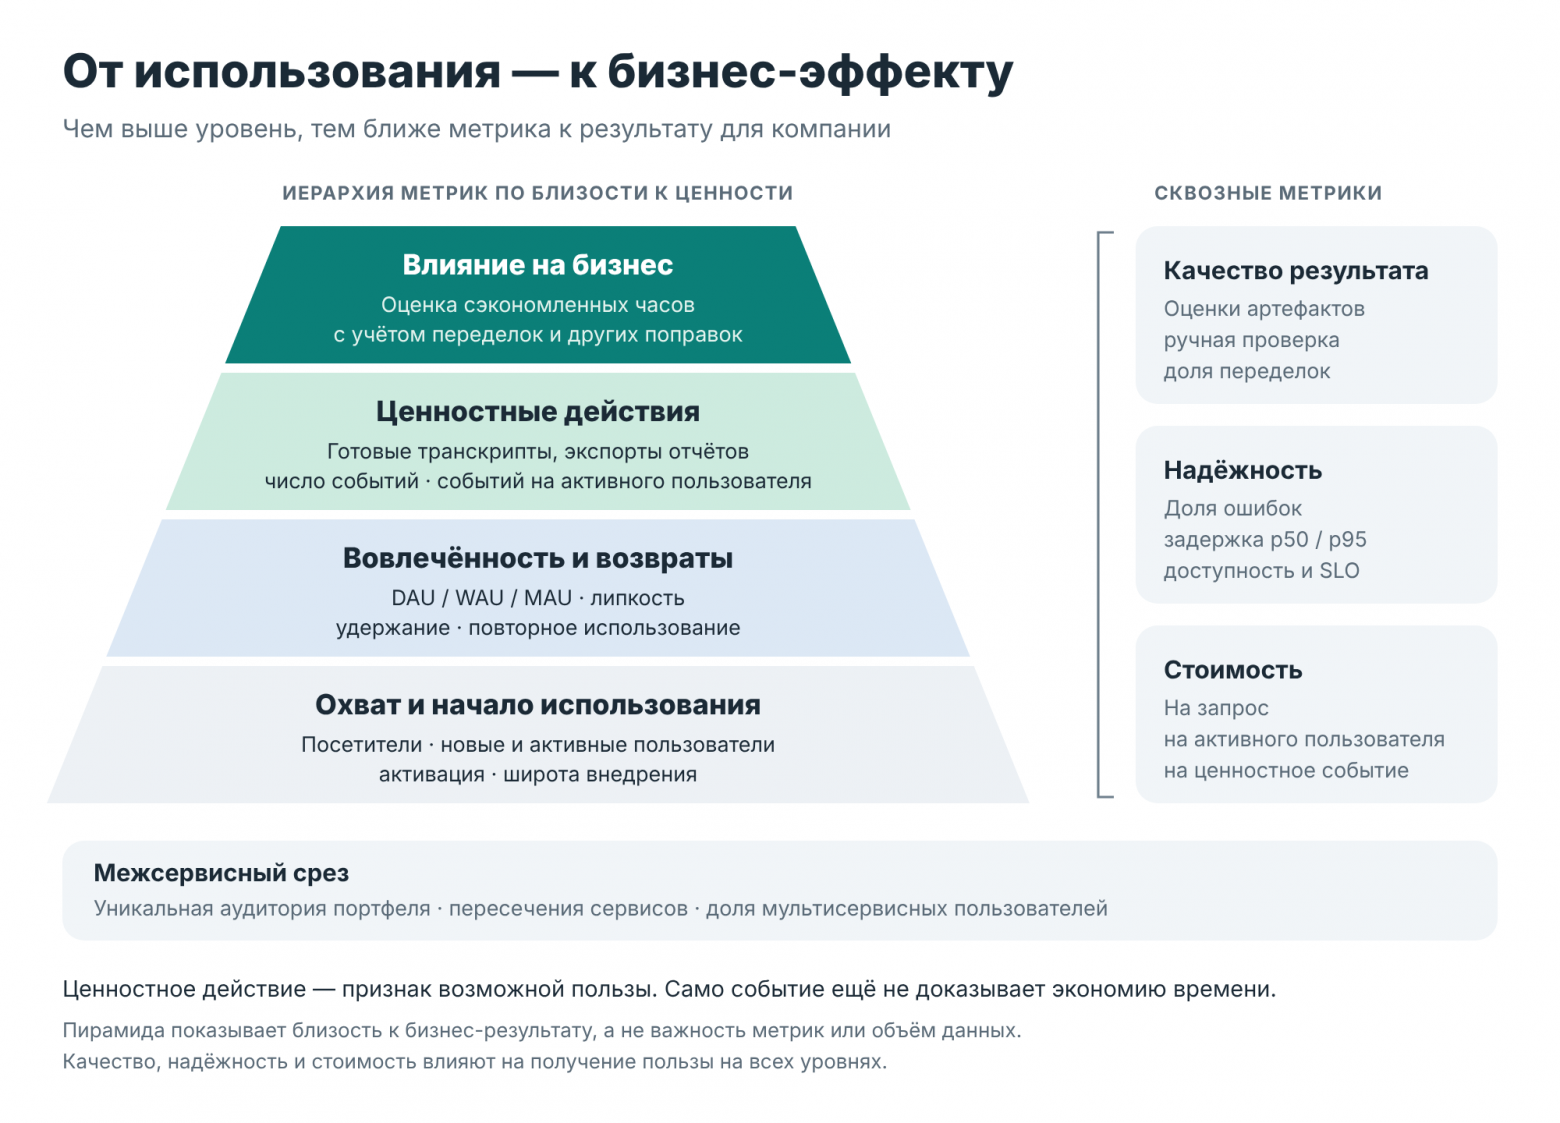
Постепенно метрики сложились в несколько слоев. Универсальный слой одинаков для всех сервисов: посетители, активные пользователи, коэффициент активации, DAU, WAU, MAU, «липкость», новые и возвращающиеся пользователи, ценностные события и глубина использования, объем обратной связи и доля позитивной. Поверх него есть межсервисный слой, который отвечает на вопрос, сколько сотрудников работает более чем в одном ИИ-сервисе и как пересекаются аудитории продуктов.
Слой эффективности и надежности считает количество вызовов модели, стоимость на запрос, на активного пользователя и на событие пользы, долю ошибок, задержку p50 и p95, доступность относительно SLO.
Слой влияния на бизнес решает проблему, общую для всех внутренних инструментов: они не увеличивают выручку напрямую, поэтому нужен прокси-показатель ценности. Мы считаем сэкономленные часы через объем выполненной работы, согласованные с командой базовые трудозатраты на единицу и поправочные коэффициенты на переделки и на то, что часть работы без инструмента никто бы не стал делать вовсе. Сам расчет сэкономленных часов по этой формуле — это тема отдельного разбора, здесь ограничимся ориентирами по стоимости и скорости.
На схеме те же слои разложены по близости к бизнес-результату: универсальные метрики — нижние уровни, а качество, надежность и стоимость проходят через все.
Сколько стоит один ИИ-отчет
Один ИИ-отчет обходится нам меньше чем в 100 рублей — точная сумма зависит от сложности записи и типа отчета. Часовая встреча обычно обрабатывается примерно за 15 минут, и все это время сотрудник занят своими делами, а не расшифровкой. Для сравнения: вручную час пользовательского теста превращается в несколько часов расшифровки, о чем мы писали в первой части.
Но главная ценность не только в сэкономленном времени, а в том, что транскрипт и отчет остаются в системе, к ним можно вернуться через полгода, найти, что на самом деле сказал респондент или о чем договорились на встрече, и использовать как материал для внутренней базы знаний. Без расшифровки эти записи, скорее всего, никто бы не пересматривал.
Где заканчивается единообразие?
Несмотря на стремление к единообразию, для каждого продукта необходимо было отдельно определить, что считать пользой и активностью. Наш текущий вариант показан ниже:
Продукт
Активность (действия пользователя)
Польза (достигнутый результат)
Транскрибатор
Загрузка файла; создание проекта; вопрос в чате
Готовый транскрипт; экспортированный отчет; ответ в чате по составу встреч
Atom Intelligence
Вопрос в чате; загрузка файлов; скачивание файлов
Ответ на вопрос по внутренним источникам или по приложенным файлам
TAR
Запуск ревью; запросы на помощь; комментарии
Завершенное ревью по merge request; внедренное предложение
DDM
Составление и открытие отчета; настройка оповещений себе; настройка напоминаний коллегам
Сформированный отчет; отправленное оповещение
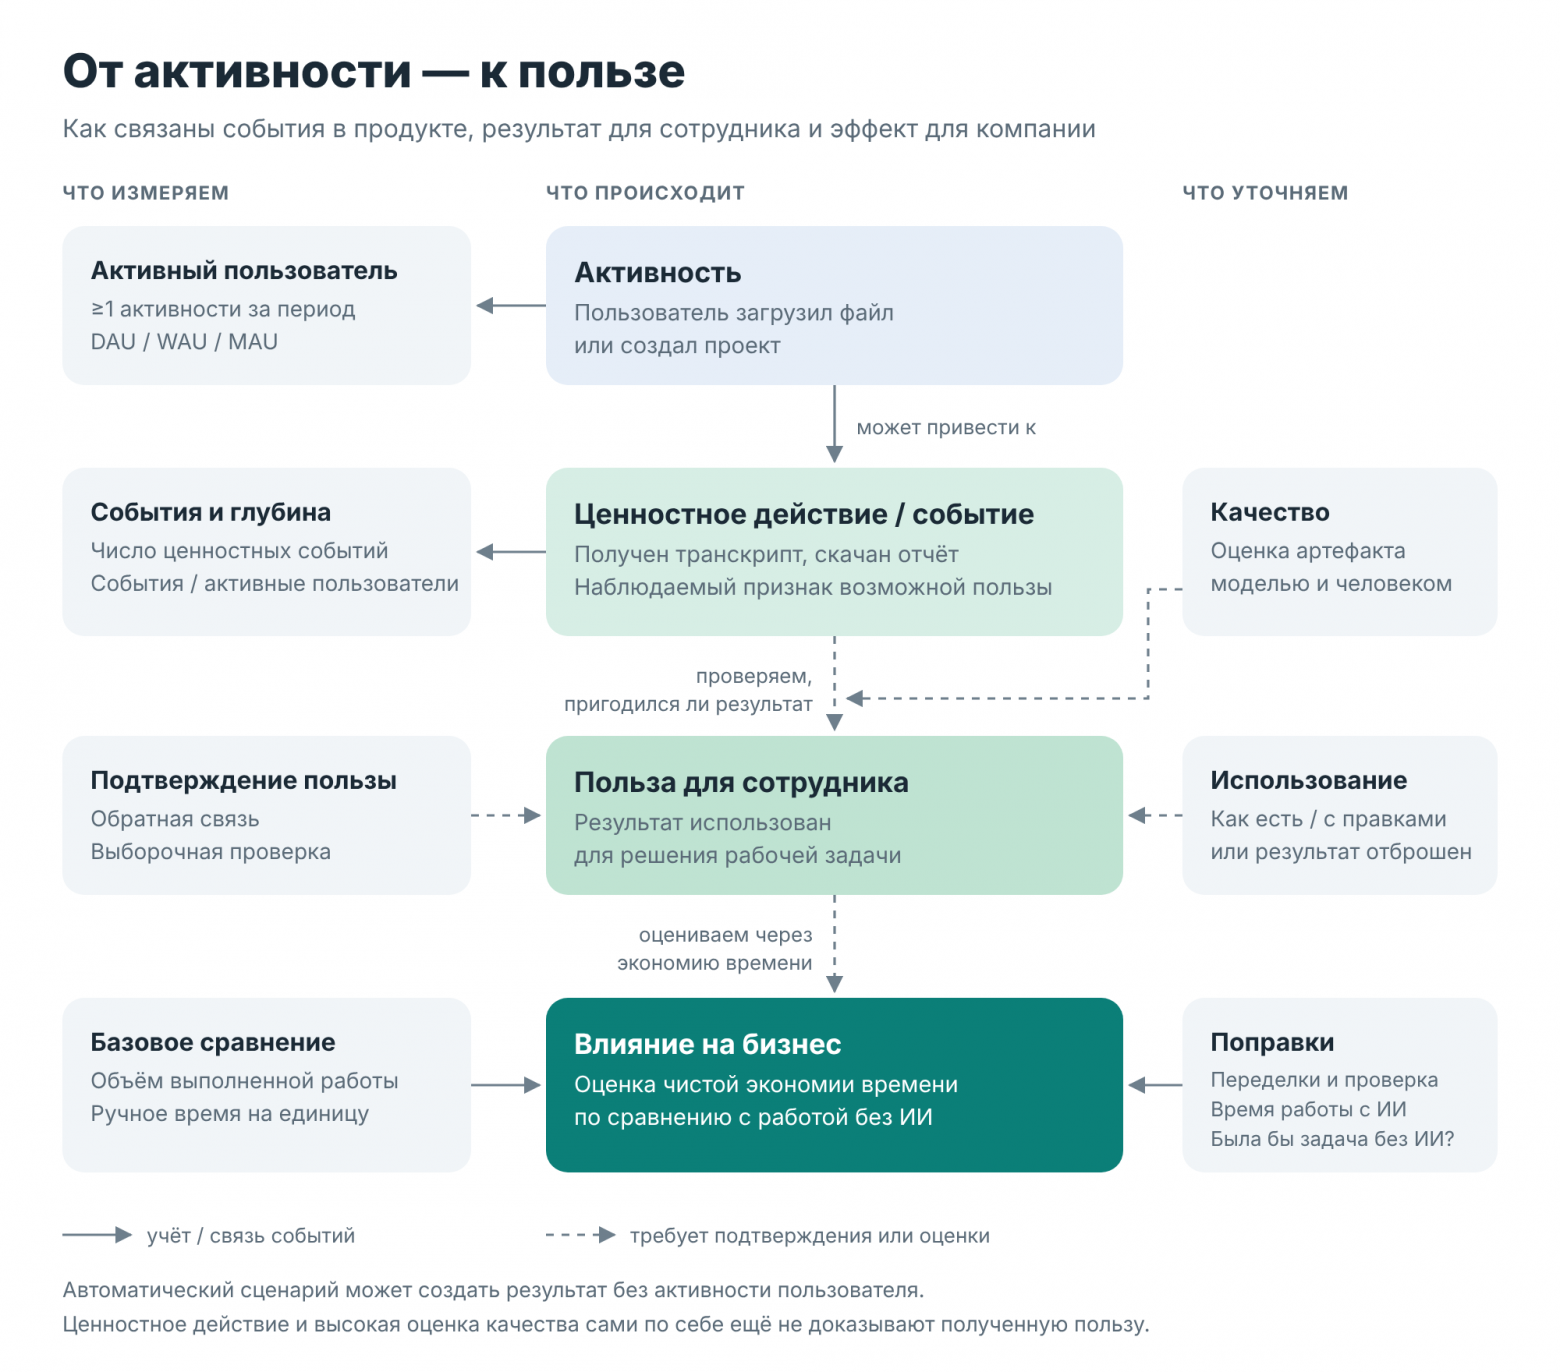
Здесь начинаются сложности, которые, судя по публичным обсуждениям, испытываем не только мы. Единого определения активного пользователя не существует, и каждый раз его приходится нащупывать заново. TAR умеет запускаться автоматически при открытии merge request. Пользователь не совершал никакого действия, но ревью получил и, возможно, применил часть предложений. Активный он или нет? DDM рассылает оповещения на почту, но некоторые их не читают… С другой стороны, есть пользователи, которые смотрят дашборд, но их действия изначально не регистрировались как активные. Сколько времени нужно смотреть на дашборд, чтобы это считалось осознанным пользованием, а не случайно открытой ссылкой? В Транскрибаторе сотрудник мог скачать ИИ-отчет, но в итоге не воспользоваться им и при этом нигде не отметить, что его не устроило качество.
Единого ответа мы пока не нашли. Так как сами продукты и метрики к ним находятся в процессе становления, в определенный момент мы изменим текущий набор метрик, опираясь на появление нового функционала, наблюдения и беседы с пользователями о том, как они реально используют продукт, и более систематическое использование тепловых карт.
Качество саммари: как мы оцениваем и улучшаем отчеты
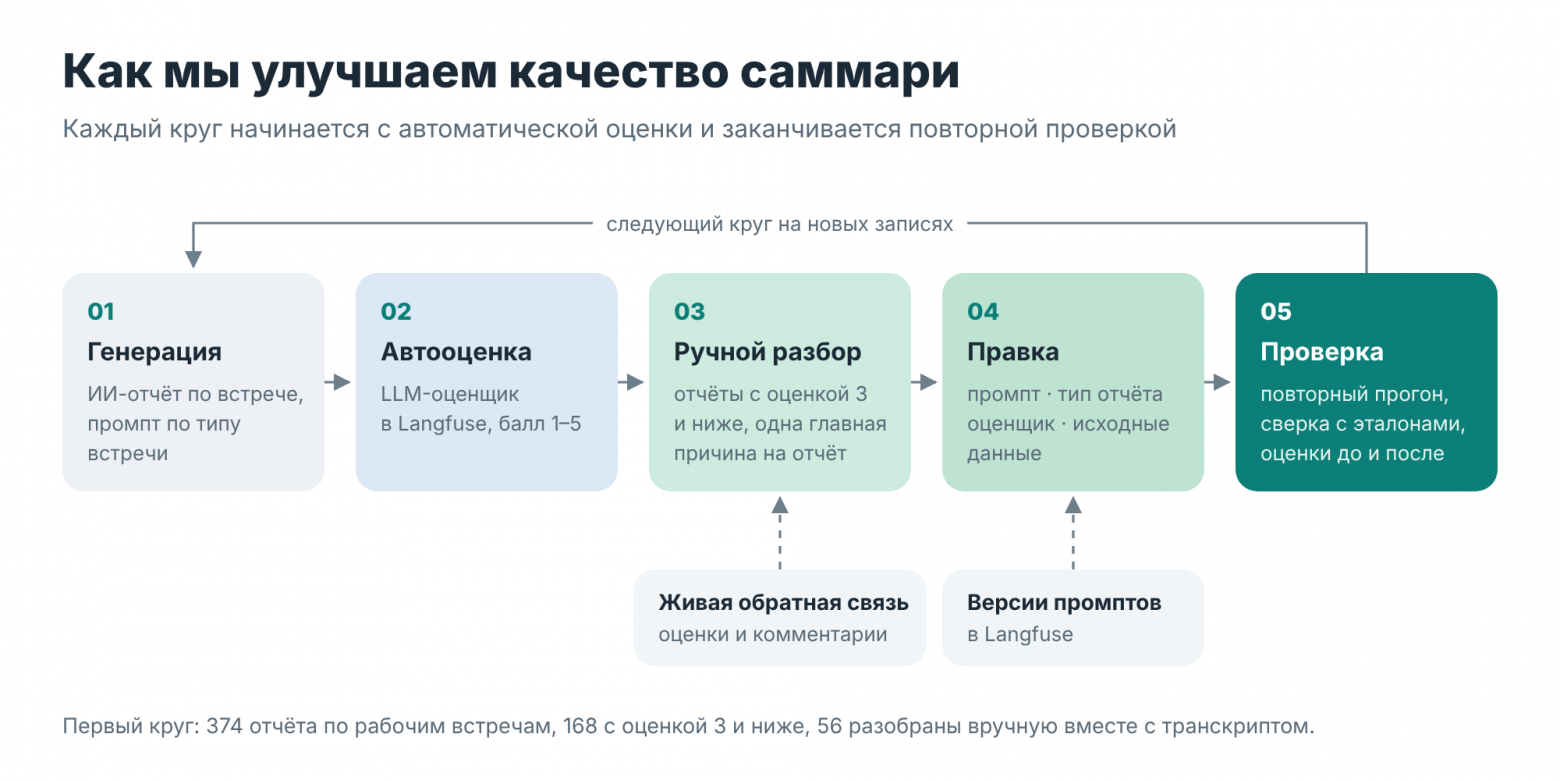
Все описанное выше измеряет поведение пользователей и бизнес-ценность. Ни одна из этих метрик, кроме текстовых и порой субъективных отзывов пользователей, не отвечает на вопрос: «А стал ли наш ИИ-отчет (саммари) лучше?»
Для этого мы настроили отдельный контур автоматической оценки качества в Langfuse — открытой платформе для трассировки и оценки LLM-приложений. Мы выбрали ее по двум причинам: это open-source решение, и в нем есть версионирование промптов, без которого не понять, какая правка промпта к чему привела.
Оценку выставляет отдельная модель-оценщик (подход LLM-as-a-judge): каждый сгенерированный отчет по встрече получает балл по пятибалльной шкале по внутреннему набору критериев. Детальная логика оценки под NDA, но принцип стандартный: критерии задаются отдельно для разных типов встреч. Чем выше балл, тем лучше отчет отвечает критериям для этого типа встречи.
Саммари по исследовательским встречам у нас стабильно получают четверки и пятерки. Объяснение простое: структура отчета для этого сценария создавалась вместе с исследователями, под конкретного заказчика и конкретный формат работы. Мы шли от требований пользователя, и результат этим требованиям соответствует. Оценки по остальным рабочим встречам распределены заметно шире, тройки там встречаются регулярно. Чтобы понять причины, мы провели большую аналитическую работу, в том числе ручной разбор логов.
Разбор плохих оценок
Мы собрали трейсы всех саммари, которые оценщик в Langfuse проверил с 3 июля по 22 сентября 2026 года: 424 отчета, из них 374 — по рабочим встречам. Оценку 3 и ниже получили 168 из 374, то есть 45%; остальные 206 получили 4 или 5. Исследовательские встречи в разбор не брали, так как целью было улучшение качества именно ИИ-отчетов по рабочим встречам.
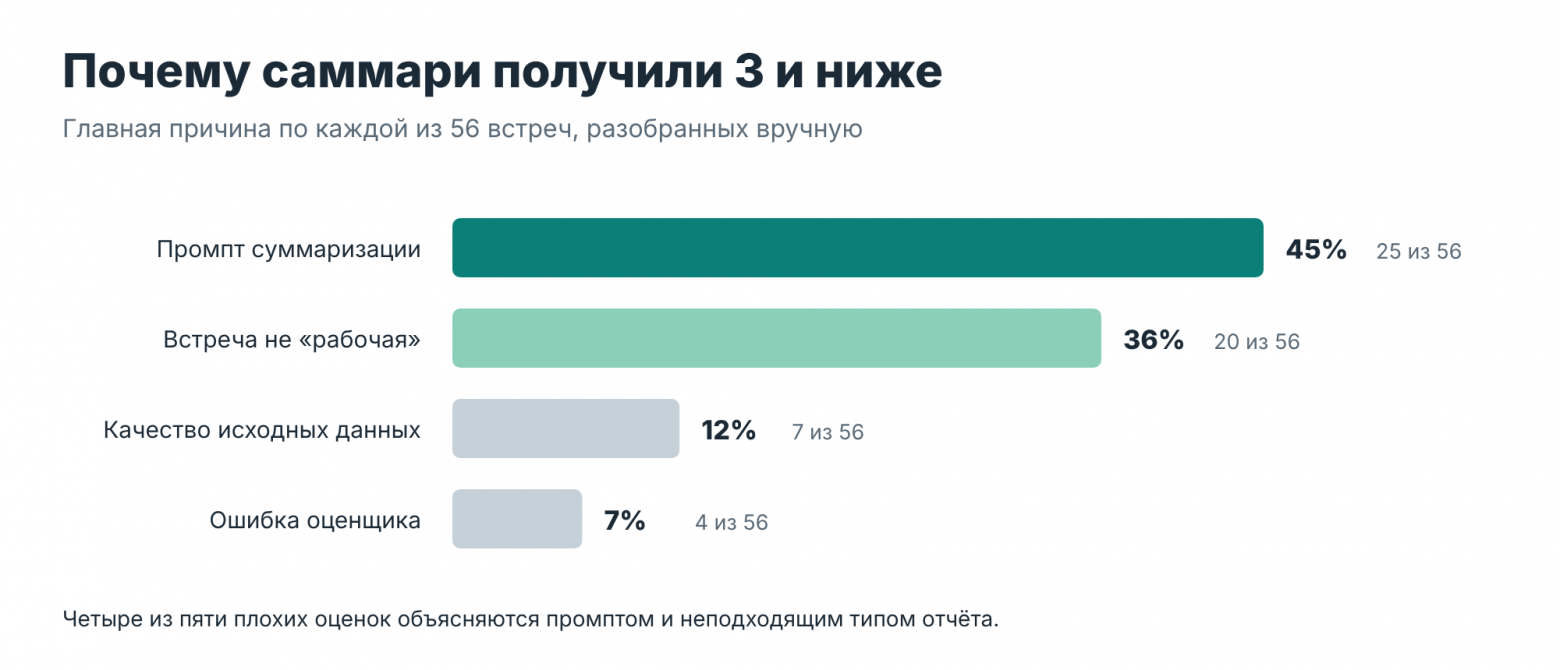
Целиком, вместе с транскриптом, было прочитано 56 отчетов: все 3 единицы, 22 двойки из 37 и 31 тройка из 128. По каждому саммари зафиксировали одну главную причину плохой оценки. А еще к каждому из 56 разобранных отчетов с помощью более сильной модели были написаны эталонные саммари — они потом пригодились как ориентир для сравнения.
-
Промпт суммаризации — 45%. Почти половина случаев вызвана качеством промпта модели суммаризации.
-
Встреча не «рабочая» — 36%. Тест-драйв с надиктованными инцидентами, демо продукта, статус-синк. Формат с темами, решениями и задачами им не подходит, и никакая правка промпта рабочей встречи этого не исправит.
-
Качество исходных данных — 12%. Английская речь, записанная русским транслитом (до появления английского языка в Транскрибаторе в сентябре), нечитаемые фрагменты, метки «Спикер 1» вместо имен.
-
Ошибка оценщика — 7%. Например, оценщик поставил единицу за корректный отказ, когда в записи вместо встречи оказался разговор с голосовым помощником о заказе продуктов.
Получается, что четыре из пяти плохих оценок дал не придирчивый оценщик и не сломанный транскрипт, а сам промпт и неподходящий тип отчета.
Что именно ломалось в отчетах по рабочим встречам?
В одном отчете обычно находилось сразу несколько проблем, в среднем 2,9, и самые частые из них зависят от наших промптов:
-
потерян главный вывод встречи — 28 отчетов из 56. Формально отчет корректный, но то, ради чего встречу будут читать, в него не попало;
-
мусор в задачах: то, что сделали прямо на встрече, бытовые мелочи, чужие поручения («расшарить экран») — 15;
-
разделы противоречат друг другу: в одном «нет значимых тем», а в соседнем пять содержательных пунктов — 15;
-
«решений нет», хотя они были, — 10, и обратная ошибка, придуманное решение, — 4;
-
раздутые открытые вопросы, среди которых есть закрытые прямо на встрече, — 10.
От версии к версии мы ужесточали правила, чтобы модель не выдумывала поручения, и она начала выбрасывать настоящие задачи. Соответственно, у нас деградировал раздел с описанием задач. Отчёт «нет активных задач» при назначенном дедлайне и договоренности о следующей встрече стал типичной картиной. Правило «лучше не написать, чем выдумать» звучит разумно, но без противовеса модель уходит в другую крайность. Для читателя потерянная договоренность так же плоха, как придуманная.
Что мы поправили и что получилось
-
Переписали промпт рабочей встречи. Каждая правка привязана к дефекту из разбора. Разделы обязаны быть согласованы между собой. Задача определяется по конкретным сигналам: обещанию в первом лице, поручению вслух, названному сроку. Организационный шаг и мнение одного участника не считаются решением, а если договоренность переиграли, в отчет идет последняя версия. Открытых вопросов не больше пяти, и только тех, на которые на встрече не ответили. Главный вывод и цифры, на которых строится решение, обязательны. Метки «блокер / важное / минорное» убрали совсем: неверная метка вредила больше, чем ее отсутствие, потому что читатель ей доверяет и не перечитывает тему.
-
Сделали отдельные типы отчетов для встреч, которые не укладываются в рабочий формат. Отчеты по тест-драйвам с клиентами и техническим заездам похожи на исследования, но требуют своих шаблонов, а саммари по лекциям — вроде бы и рабочие встречи, но тоже требуют других промптов.
-
Переделали оценщика. Наш первый оценщик наказывал корректный отказ и не отличал короткий отчет от пустого, поэтому опираться на его баллы при правке промпта было нельзя. Новый сначала проверяет, был ли в записи материал для отчета, и только потом оценивает качество.
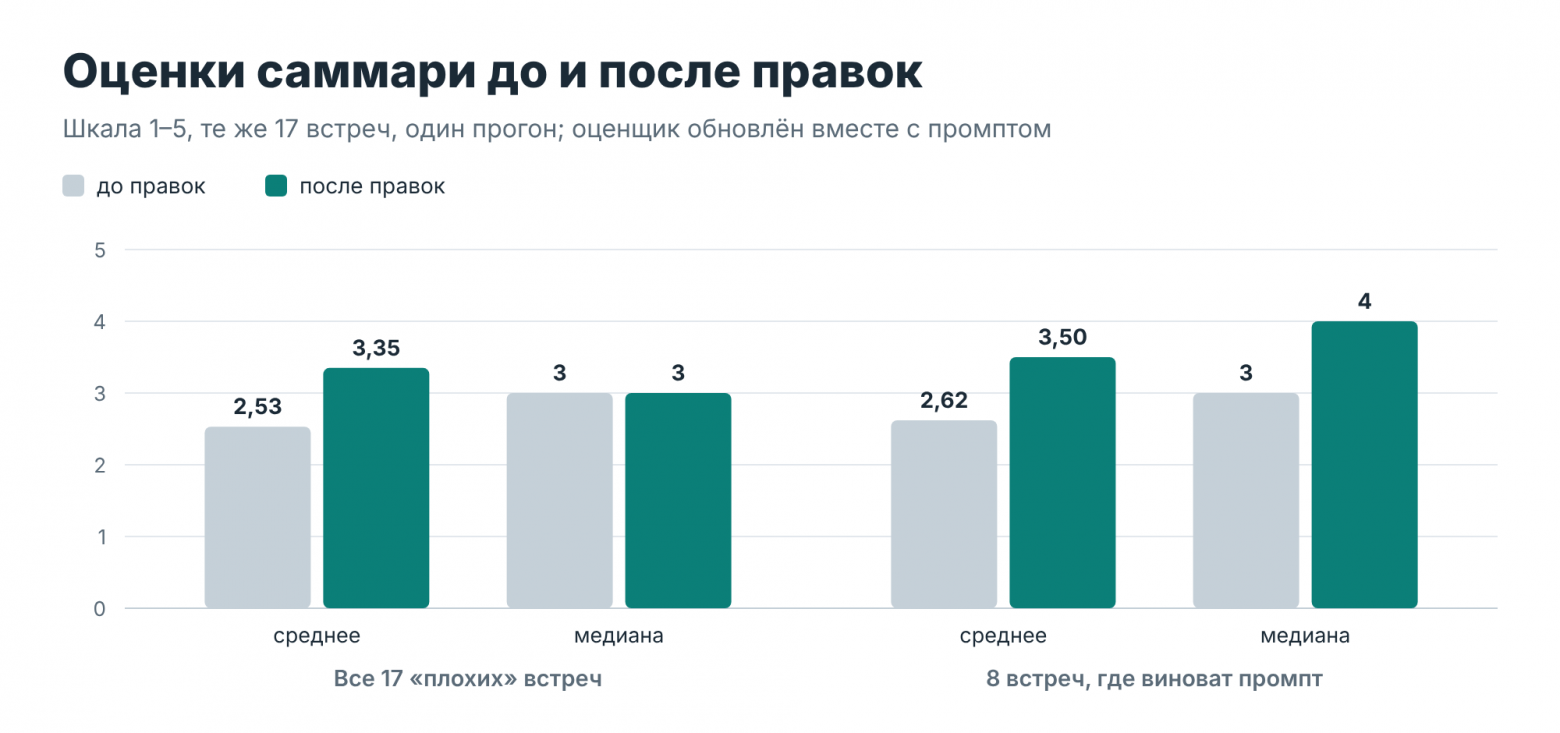
Новую версию — промпт, типы отчетов и оценщика — проверили на 17 из 56 разобранных встреч, в том числе на 8 из 25, где главной причиной был промпт. Новые отчеты сравнивали с эталонами, составленными при разборе, и смотрели на оценки. Средняя оценка «плохих» встреч выросла с 2,53 до 3,35, медиана при этом осталась на уровне 3. В восьми встречах, где главной причиной был промпт, среднее выросло с 2,62 до 3,50, а медиана — с 3 до 4. Всего четверку или пятерку получили 8 из 17 встреч; до правки все 17 были оценены на 3 и ниже — по этому признаку мы их и отбирали.
У эксперимента есть ограничения, и мы хотим назвать их прямо:
-
вместе с промптом сменился оценщик, поэтому баллы до и после сравнимы лишь приблизительно;
-
мы в данной итерации отбирали только самые слабые отчеты, не рассматривая те, которые получили высокий балл;
-
каждый отчет прогнали один раз, хотя и генерация, и оценка недетерминированы;
-
17 встреч — слишком мало, чтобы говорить о статистической значимости;
-
баллы оценщика мы пока не сверяли с оценками людей, а эталонные саммари написала более сильная модель.
Данный результат мы принимаем не как истину в последней инстанции, а как ориентир для будущих улучшений.
Что мы вынесли
-
Свободные комментарии полезнее оценок по шкале. «Неверное распределение спикеров» сразу превращается в задачу, а 3/5 — нет.
-
Метрикам нужны противовесы. Рядом с ростом аудитории должны стоять ошибки и неуспешные вызовы, иначе картинка всегда будет приятной.
-
«Активный пользователь» и «польза» определяются для каждого продукта отдельно, и эти определения придется пересматривать.
-
Правилу «лучше не написать, чем выдумать» нужен противовес. Иначе модель начинает терять настоящие договоренности.
-
Оценщик сначала проверяет, был ли материал для отчета, и только потом оценивает качество.
-
Не все встречи «рабочие». Тест-драйвам, лекциям и демо нужны свои типы отчетов.
Сейчас в работе эксперимент по сравнению отчетов, созданных людьми и с помощью нашего инструмента. Мы также планируем накопить записи как минимум за месяц и повторить разбор, параллельно продолжая собирать живую обратную связь от наших пользователей. Работа в процессе, и нам как никогда важно, чтобы метрики были не просто набором абстрактных цифр для отчетности, а отвечали на наши вопросы и отражали реальное использование. Если вы строите свои внутренние ИИ-инструменты и тоже решаете или уже в какой-то мере удачно решили часть проблем с качеством и оценкой, обязательно делитесь в комментариях.
Дополнительные материалы, если интересно почитать про Langfuse
-
Подробнее о настройке Langfuse на русском языке: LLMops дома: быстрое разворачивание и настройка инфраструктуры с помощью Langfuse — эксперты Data Feeling School показывают, как развернуть Langfuse в собственном контуре и решить проблему «черного ящика» в LLM-пайплайнах.
-
YADRO подробно описали свой опыт мониторинга и оценки качества LLM-приложений с помощью Langfuse.
-
LLMStart рассказывает, как измеряет и улучшает качество ИИ-агента для 1С:УНФ, храня датасеты для оценки и трейсы в Langfuse.
-
Sminex описывает, как построил корпоративную LLM-платформу, где Langfuse отвечает за трассировку, учет стоимости и версионирование промптов.
-
Автор: ATOM_Team