
Пять инженерных решений, которые нужно принять до генерации кода с AI
В платформе, над которой я работал несколько лет, каждый новый бренд мы собирали из общего кода, его собственной конфигурации, темы и выбранного набора модулей. У брендов были разные продуктовые требования и графики релизов. Задача состояла в том, чтобы эти различия не превращались в отдельную копию платформы для каждого клиента.
Первоначальная модель оформления казалась достаточной: есть базовая тема, и в конкретном бренде её можно переопределить. Затем переопределения стали выходить за пределы цветов. Одну визуальную задачу решали по-разному в нескольких местах, локальные особенности накапливались, общая стилизация постепенно теряла общность.
Мы перешли к SCSS-mixins, пути к которым разрешались в контексте конкретного бренда при сборке. У кастомизации появилась явная граница. Сделать такой переход для уже работающих продуктов оказалось дороже, чем сразу выбрать подходящую модель.
В этой истории главный вопрос: куда должно попасть следующее изменение? Если ответ — «в любое место, где удастся получить нужный результат», система с каждым релизом дорожает в развитии. На работающем продукте нельзя просто переписать несколько сервисов и выкатить обновление: каждый из них уже обслуживает пользователей. Возможность расширения закладывается до первой интеграции, а не после пятой. Скорость написания кода этот вопрос не решает.
Теперь значительную часть реализации можно поручить AI. Интерфейс, backend и работающий пользовательский сценарий появляются за часы. Вопросы о границах изменений, совместимости, данных и эксплуатации при этом никуда не исчезают — они просто могут не попасть в исходный запрос.
Человек без опыта сложных систем способен подробно описать, что хочет увидеть. Опытный инженер дополнительно формулирует условия, в которых решение должно продолжать работать, и свойства, которые нельзя потерять при следующем изменении. Об этой разнице и статья.
Разбираю её на двух проектах: мультибрендовой платформе и собственном автомобильном маркетплейсе. AI участвовал в более позднем развитии платформы, архитектурные решения в ней принимались до него. Маркетплейс — источник уроков, в том числе на моих собственных ошибках. Компактные примеры кода ниже учебные: они показывают, как эти уроки превращаются в сегодняшнюю постановку задачи.
Что именно я сравниваю
Под вайбкодингом я понимаю процесс, где человек описывает желаемый результат, последовательно просит его изменить и принимает работу по наблюдаемому поведению. Открыл страницу, прошёл сценарий, получил нужный экран — можно двигаться дальше.
Под инженерной работой с AI — процесс, где в задачу входят также ограничения существующей системы, допустимые изменения, условия отказа и способы проверки. Здесь тоже можно генерировать почти весь код. Разница в том, какие решения приняты осознанно и чем подтверждён результат.
Это рабочие методы, а не уровни. Начинающий разработчик может работать вторым способом, а человек с большим стажем — первым. Значение имеет опыт, который превратился в понимание зависимостей и последствий.
Почему я всё же связываю преимущество с опытом? Когда ты уже поддерживал общий компонент с несколькими потребителями, откатывал релиз или разбирал конкурентную запись, в новом задании сами собой появляются дополнительные вопросы. Они возникают до того, как написан код и получен первый дефект.
AI тоже способен предложить эти вопросы: разобрать риски, найти ограничения, сравнить варианты. Но кто-то должен оценить, какие ответы подходят конкретному продукту, где модель опирается на предположения и какие риски бизнес готов принять. Универсального списка, снимающего эту ответственность, нет.
Для одноразового прототипа визуальной проверки может быть достаточно: показать идею интерфейса, обсудить, выбросить. Обратная ошибка тоже существует: строить под гипотетический масштаб с первого дня. У каждой части системы должна быть объяснимая задача и цена сопровождения. Для сервиса с пользователями и данными запрос «добавь ещё одну возможность» уже меняет работающую систему, и его стоимость не сводится к времени генерации.
Поэтому сравнивать подходы стоит на второй, пятой и десятой итерации: сколько существующего поведения приходится затрагивать, какой контекст нужен для изменения, что надо перепроверить. Первый экран этой разницы не показывает.
Опыт становится вопросами в постановке
Пользовательское описание обычно правильно передаёт намерение. Но намерение не определяет все свойства реализации. Между «нужен чат» и проверяемым заданием на чат лежит несколько решений, о которых пользователь не обязан думать.
|
Что хочется получить |
Какой вопрос добавляет инженер |
Что появляется в задаче |
|---|---|---|
|
Ещё один бренд |
Какие различия уже выражаются конфигурацией? |
Место расширения и границы общей части |
|
Новый провайдер |
Где его формат превращается во внутреннюю модель? |
Контракт адаптера и правила ошибок |
|
Новое поле |
Кто ещё читает и записывает эту схему? |
Совместимость и порядок выпуска |
|
Пополнение баланса |
Что произойдёт при двух одновременных повторах? |
Однократный эффект и транзакционные границы |
|
Сообщение в чате |
Где находятся участники и что будет после рестарта? |
Топология, хранение и восстановление |
|
Удаление старых данных |
Что произойдёт при задержке или повторе задачи? |
Срок жизни и безопасное повторное выполнение |
|
Готовый релиз |
Как понять, что пользователь получил результат? |
Сигналы бизнес-сценария и условия остановки |
Цель — выбрать ограничения, которые меняют решение. Длина промпта сама по себе ничего не даёт.
Если задача локальна и обратима, постановка может быть короткой. Если изменение касается общего контракта, баланса или прав, пара уточнений до реализации способна изменить и модель данных, и транзакцию, и тестовый сценарий.
Ниже — пять решений, которые в разных проектах пришлось принимать до реализации: где заканчивается внешний контракт, как разделить общее и специфичное для бренда, как сохранить совместимость данных, какие гарантии нужны конкурентным операциям и как обеспечить доставку сообщений в реальной инфраструктуре.
1. Интеграции: определить границу внешнего контракта
Представим три части: А получает данные внешнего сервиса, Б реализует бизнес-правило, В показывает результат пользователю. На работающем продукте это часто отдельные сервисы или пакеты — со своими релизами, потребителями и пользователями, которые работают с системой прямо сейчас.
Если внешний формат проник во все три части, новый провайдер означает согласованное изменение А, Б и В, совместную выкладку и регрессию всех существующих сценариев. Просто поправить три места и выкатить обновление нельзя: каждое из них уже обслуживает подключённых провайдеров, и ошибка в любом ломает то, что работало.
Если А преобразует данные во внутренний контракт, новый провайдер — это новый адаптер. Б и В о нём не знают, существующие сценарии не затрагиваются, выкладывается одна часть системы.
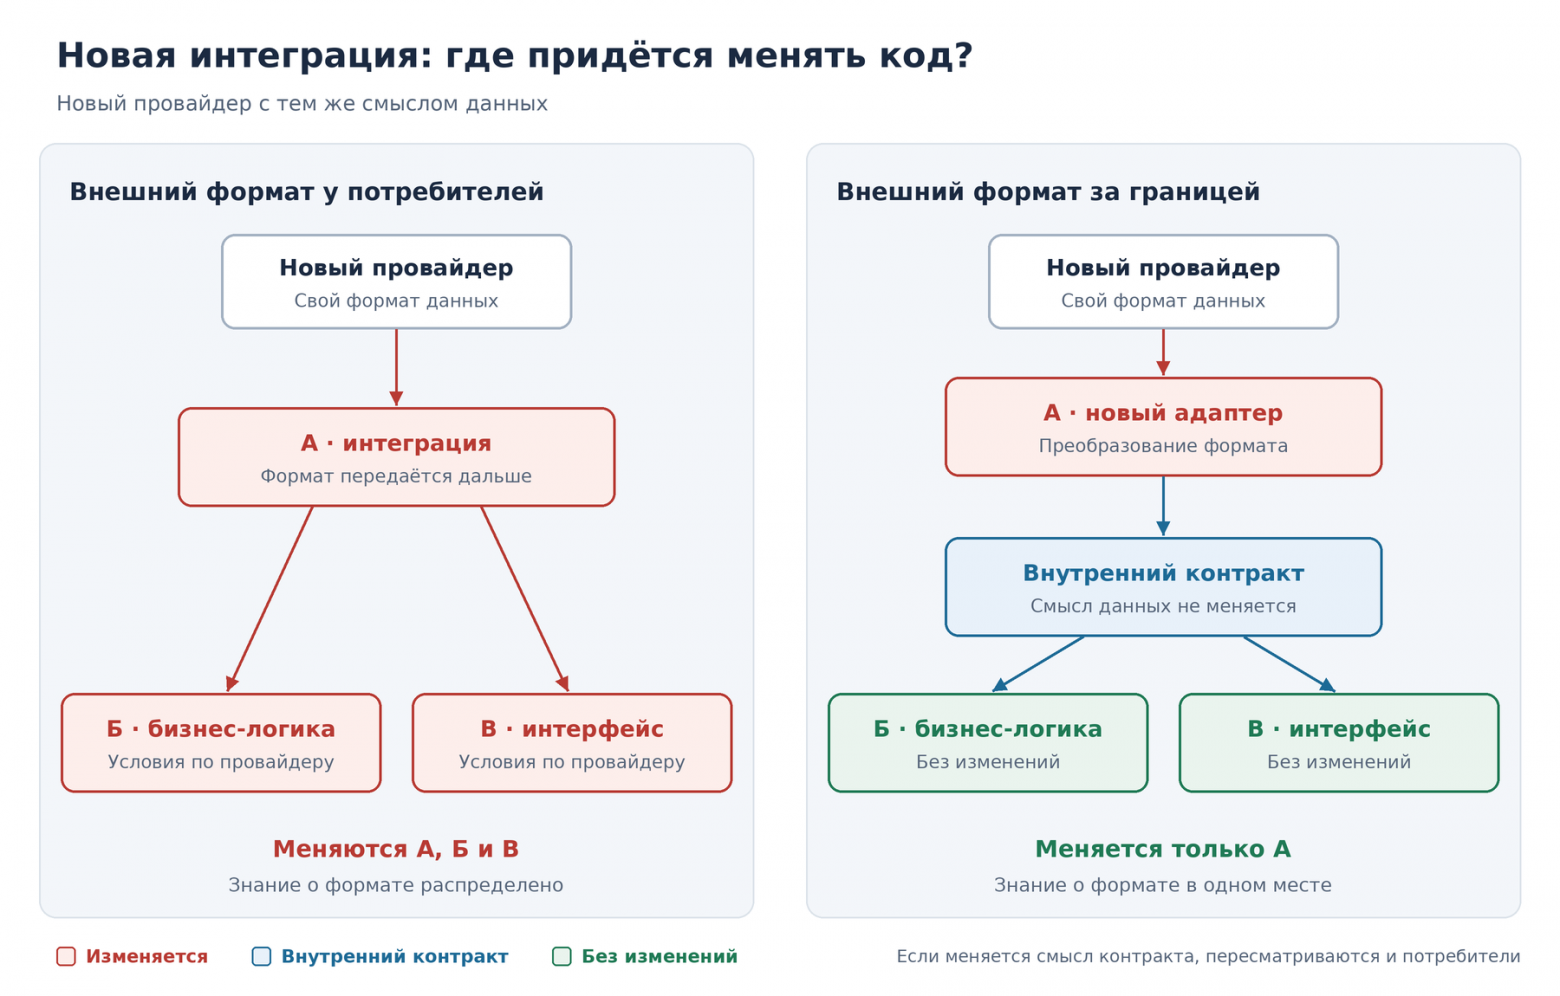
Новый провайдер с тем же смыслом данных. Слева знание о внешнем формате распределено, и меняются все три части. Справа изменение ограничено адаптером. Если меняется сам смысл контракта, потребителей придётся пересмотреть и во втором случае.
Возьмём каталог игр двух внешних провайдеров (учебный пример, не код платформы): у одного игра описана полями id и name, у другого — code и title. Если на старте не определили, где заканчивается внешний формат, получается такой код:
type RawA = { id: string; name: string };
type RawB = { code: string; title: string };

// Представление и бизнес-логика знают внешний формат.
function cardTitle(raw: RawA | RawB, kind: "a" | "b") {
  return kind === "a" ? (raw as RawA).name : (raw as RawB).title;
}
function favouriteKey(raw: RawA | RawB, kind: "a" | "b") {
  return kind === "a"
    ? `a:${(raw as RawA).id}`
    : `b:${(raw as RawB).code}`;
}
Это ошибка проектирования, сделанная ещё на старте, а не вопрос стиля. Выбор поведения по типу источника означает, что знание о внешнем формате живёт у потребителей. Каждый новый провайдер — ещё одна ветка в каждой такой функции, в каждом сервисе, где она есть. Тернарный оператор превращается в switch, switch — в карту исключений, и через год никто не может сказать, сколько мест нужно поменять, чтобы подключить следующий источник. Такой код не расширяется — его можно только переписывать, каждый раз на работающей системе.
Условного выбора по провайдеру у потребителей быть не должно в принципе. Требование закладывается до первой интеграции: внешние особенности заканчиваются в адаптере, внутренние потребители работают с одной моделью и не знают, откуда пришли данные.
type Game = { key: string; title: string };
interface Catalog {
  list(): Promise<Game[]>;
}

const fromA = (load: () => Promise<RawA[]>): Catalog => ({
  list: async () => (await load()).map(x => ({
    key: `a:${x.id}`, title: x.name,
  })),
});
const fromB = (load: () => Promise<RawB[]>): Catalog => ({
  list: async () => (await load()).map(x => ({
    key: `b:${x.code}`, title: x.title,
  })),
});

async function cards(catalog: Catalog) {
  return (await catalog.list()).map(game => ({
    key: game.key, label: game.title,
  }));
}
Теперь подключение нового провайдера — это новый адаптер и точка его регистрации. Код Б и В не меняется, поэтому область изменений и необходимой регрессионной проверки существенно сокращается. Префикс ключа не даёт совпасть одинаковым внешним идентификаторам разных источников. В полноценном контракте ещё понадобятся семантика ошибок, проверка входных данных и, возможно, пагинация — интерфейс TypeScript их не решает.
Проверка выводится из контракта: дать обоим источникам одинаковый внешний идентификатор и убедиться, что ключи различаются, а общий потребитель одинаково обрабатывает обе реализации. «Вторая карточка появилась» для этой задачи не проверка.
Здесь и проходит разница между вайбкодингом и инженерной постановкой. Если попросить AI «добавь поддержку провайдера B» в кодовой базе первого типа, одним из возможных решений станет добавление новой ветки в местах, где проверяется kind. Это самый короткий путь к работающему экрану, и демо он пройдёт. В кодовой базе второго типа та же просьба сводится к одному файлу. Поэтому первый вопрос в постановке: это расширение через существующую точку или изменение нескольких сервисов? Если второе — сначала проектируется точка расширения, и только потом подключается провайдер.
Граница определяет и объём контекста для агента. Без неё ему нужно знать всех потребителей, все исключения и все зависимости. С ней задача формулируется узко и проверяется конкретно. Чем меньше сведений нужно для обоснованного изменения, тем безопаснее его поручить и проще отревьюить.
Сам контракт тоже может меняться — когда меняется смысл продукта, а не источник данных. Если новый провайдер требует другого пользовательского сценария, это отдельное осознанное решение со своим планом выпуска и миграции. Оно не должно происходить незаметно при каждом подключении нового поставщика.
Решение до генерации: определить внутренний контракт и границу интеграции. Особенности внешнего провайдера должны оставаться внутри адаптера, если не меняется сама бизнес-модель. Подключение нового источника не должно требовать изменений всех его потребителей.
2. Мультибрендовая платформа: определить границы вариативности
Каждый бренд платформы был отдельным продуктом, а не копией шаблона с другим логотипом и цветами. У брендов были собственные лицензии, рынки, продуктовые команды и графики релизов. Часть принадлежала оператору, часть — внешним клиентам. Требовалось развивать все бренды на одной кодовой базе и при этом поддерживать их реальные продуктовые различия.
Разработчики описывали бренд в его конфигурации: какие модули платформы он использует — ядро и нужные функциональные возможности, — а также тему, языки, юридические тексты и, при необходимости, собственные компоненты. При сборке эта композиция разрешалась в отдельный образ бренда, который разворачивался независимо от остальных.
Это давало независимость выпуска. Один бренд проходил QA и выходил с обновлением, пока другой продолжал работать на ранее собранном артефакте. Новый бренд становился задачей конфигурации, оформления и подключения возможностей платформы, а не ещё одним приложением с нуля.
Общие пакеты при этом не закреплялись за версиями: очередная сборка брала актуальное состояние монорепозитория. Новую функцию можно было не включать в конфигурацию конкретного бренда. Но изменение общего компонента, который бренд уже использовал, попадало в его следующую сборку так же, как и во все остальные.
У решения была цена. Изменения запускали сборку общих пакетов и брендов, полный процесс занимал часы. Ошибка общего слоя могла задеть несколько продуктов. Поэтому TypeScript, ревью и обязательный QA-checklist для выпускаемых брендов были частью модели. Поломки всё равно случались.
Перенесём этот опыт в задачу для AI. Запрос «сделай ещё один бренд по этому макету» почти ничего не говорит о том, где должны жить изменения. Можно скопировать компоненты, добавить условие по идентификатору бренда или расширить общую модель. Все три варианта дают похожий скриншот, но первые два — та же ошибка, что и ветвление по провайдеру: следующий бренд снова потребует правок в общем коде, который уже работает у остальных.
До реализации я бы поставил вопросы:
-
Какие отличия являются контентом или темой?
-
Какие уже предусмотрены вариантами компонента?
-
Где действительно меняется структура или продуктовый сценарий?
-
Кто ещё использует затрагиваемый контракт?
-
Должна ли новая возможность включаться отдельно?
Из ответов получается задача другого качества: классифицировать различия, использовать существующую конфигурацию, отдельно показать недостающие расширения и не менять общий контракт без перечня затронутых потребителей. Свобода реализации у агента остаётся, но появляется понятная область решений.
Кастомизация: общий код не должен исчезать за исключениями
Вернусь к стилизации. Модель базовой темы с переопределениями на старте была разумной. Ограничения стали заметны по мере развития брендов: различались уже не отдельные значения, а способы решения визуальных задач.
Переход к mixins с разрешением путей в контексте бренда сделал область переопределения явной: в сборке бренда можно было заменить только конкретный mixin. От ошибок в SCSS это не защищало, но задавало единственный механизм, через который локальная кастомизация попадала в продукт.
Конкретная технология здесь вторична. Другой стек использовал бы тему, слоты, варианты компонентов или иной механизм композиции. Нужен ответ на вопрос: какие различия допускаются и где они реализуются.
У визуальной задачи есть опасное удобство: результат легко оценить на одном экране. AI может добиться нужного вида, изменив общую разметку, добавив специальный селектор или создав локальную копию. Если в постановке только макет, по скриншоту эти решения не различить.
Поэтому к визуальному результату стоит добавить требования к области изменений: использовать существующие параметры темы; структурное отличие вынести в предусмотренный вариант; если такого варианта нет, сначала описать расширение и его потребителей. Абстракция на каждый отступ не нужна — нужно определить, где изменение становится общим решением.
Проверка тоже должна соответствовать задаче. Для изменения общего компонента нужен не только целевой экран, но и его состояния в нескольких существующих контекстах. Где-то хватит ручного сравнения, где-то оправдана визуальная регрессия. Посмотрев только новый бренд, нельзя обещать, что остальные не пострадали.
Поэтому я не ставлю AI формальных условий вроде «никогда не дублируй код». Полезнее содержательные: сохранить общую часть там, где сохраняется общий смысл, явно выделить настоящие различия и провести их через предусмотренную точку кастомизации, а не через правку общего кода.
Решение до генерации: определить, какие различия между брендами выражаются конфигурацией, какие — вариантами компонентов, а какие требуют самостоятельной реализации. Изменения общего кода должны учитывать существующих потребителей, а новый бренд не должен превращаться в копию платформы.
3. Миграция: задача продолжается между двумя релизами
В маркетплейсе основной API и API админки использовали общую схему основной базы. По развёртыванию это были разные сервисы, по данным — нет. Такая связь сразу влияет на постановку любого изменения схемы.
Новый столбец или удалённое поле касались не одного репозитория. Поэтому новые поля добавлялись совместимо — с допустимым пустым значением или default, а удаление старого выносилось в релиз после того, как сервисы переставали его использовать.
Пример — поле времени поднятия объявления. Обновлённый сервис уже учитывал его, а потребитель, который ещё не знал о поле, продолжал работать со схемой. Значение имел переход между состояниями системы, а не только её финальная версия.
Оговорюсь: релизы маркетплейса шли с режимом обслуживания, так что это не история про обновления без простоя. Совместимость данных и доступность во время выкладки — связанные, но разные требования.
Запрос «переименуй поле и обнови все обращения» выглядит конкретным. В одном checkout агент действительно найдёт обращения и сделает код согласованным. Но репозиторий не всегда содержит всех потребителей, а работающая система не переключается целиком в момент изменения файлов.
До реализации нужны вопросы: какие версии будут работать одновременно, есть ли фоновые задачи и внешние потребители, нужно ли переносить данные, как проверить завершение переноса и что произойдёт при откате приложения.
С ответами задача становится последовательностью: расширить схему, обеспечить совместимость переходного периода, перенести данные, переключить потребителей и только затем удалить старое. Для маленького сервиса последовательность может быть короче. Но её надо выбрать, а не получить случайно из порядка команд в pipeline.
Критерий проверки конкретный: старая и новая версии клиента работают с расширенной схемой в сценариях, которые должны пережить переход. Отдельно проверяется, допустим ли после миграции откат к прежнему артефакту приложения.
Удалённые данные не возвращаются от отката контейнера. А default сам по себе не доказывает, что DDL безопасен по времени и блокировкам для таблицы конкретного размера: даже короткая эксклюзивная блокировка может надолго встать в очередь за длинным запросом. Это проверяется по СУБД, её версии и самой операции (в PostgreSQL — ALTER TABLE), а в миграциях полезно задавать lock_timeout.
Этот вопрос легко упустить без опыта сопровождения. Пользователь просит новое поле. Инженер видит ещё и период, когда старое и новое представления сосуществуют. Если этот период не описан, AI решает задачу с неполными условиями, даже когда весь diff выглядит согласованным.
Решение до генерации: определить допустимый период совместимости старой и новой схемы, последовательность изменения сервисов и условия отката. Миграция должна проектироваться как переход между состояниями работающей системы, а не только как получение итоговой структуры базы.
4. Платёжная операция: требование к повтору должно появиться раньше обработчика
В маркетплейсе были внутренний баланс и платные услуги для объявлений. На софт-ланче они оставались выключенными. Позже, перечитывая код, я нашёл проблему: баланс читался, новое значение рассчитывалось в приложении и сохранялось абсолютным числом.
Запись могла быть в транзакции, но предшествующее чтение не обеспечивало согласованность всей операции. Два запроса могли увидеть один исходный баланс и оба пройти проверку. Тот же вопрос был у обработчика пополнения: последовательность «прочитать статус, проверить PENDING, записать результат» не учитывала конкурентное выполнение.
Деньги пользователей не пострадали — платежи не были включены. Но модель отказа была реальной, и теперь я закладываю её в постановку подобных задач заранее.
Упрощённый обработчик проверяет статус и затем безусловно переводит операцию в успех с зачислением. Повторный вызов после завершения будет отвергнут, но два одновременных обработчика могут прочитать PENDING до того, как любой из них закончит.
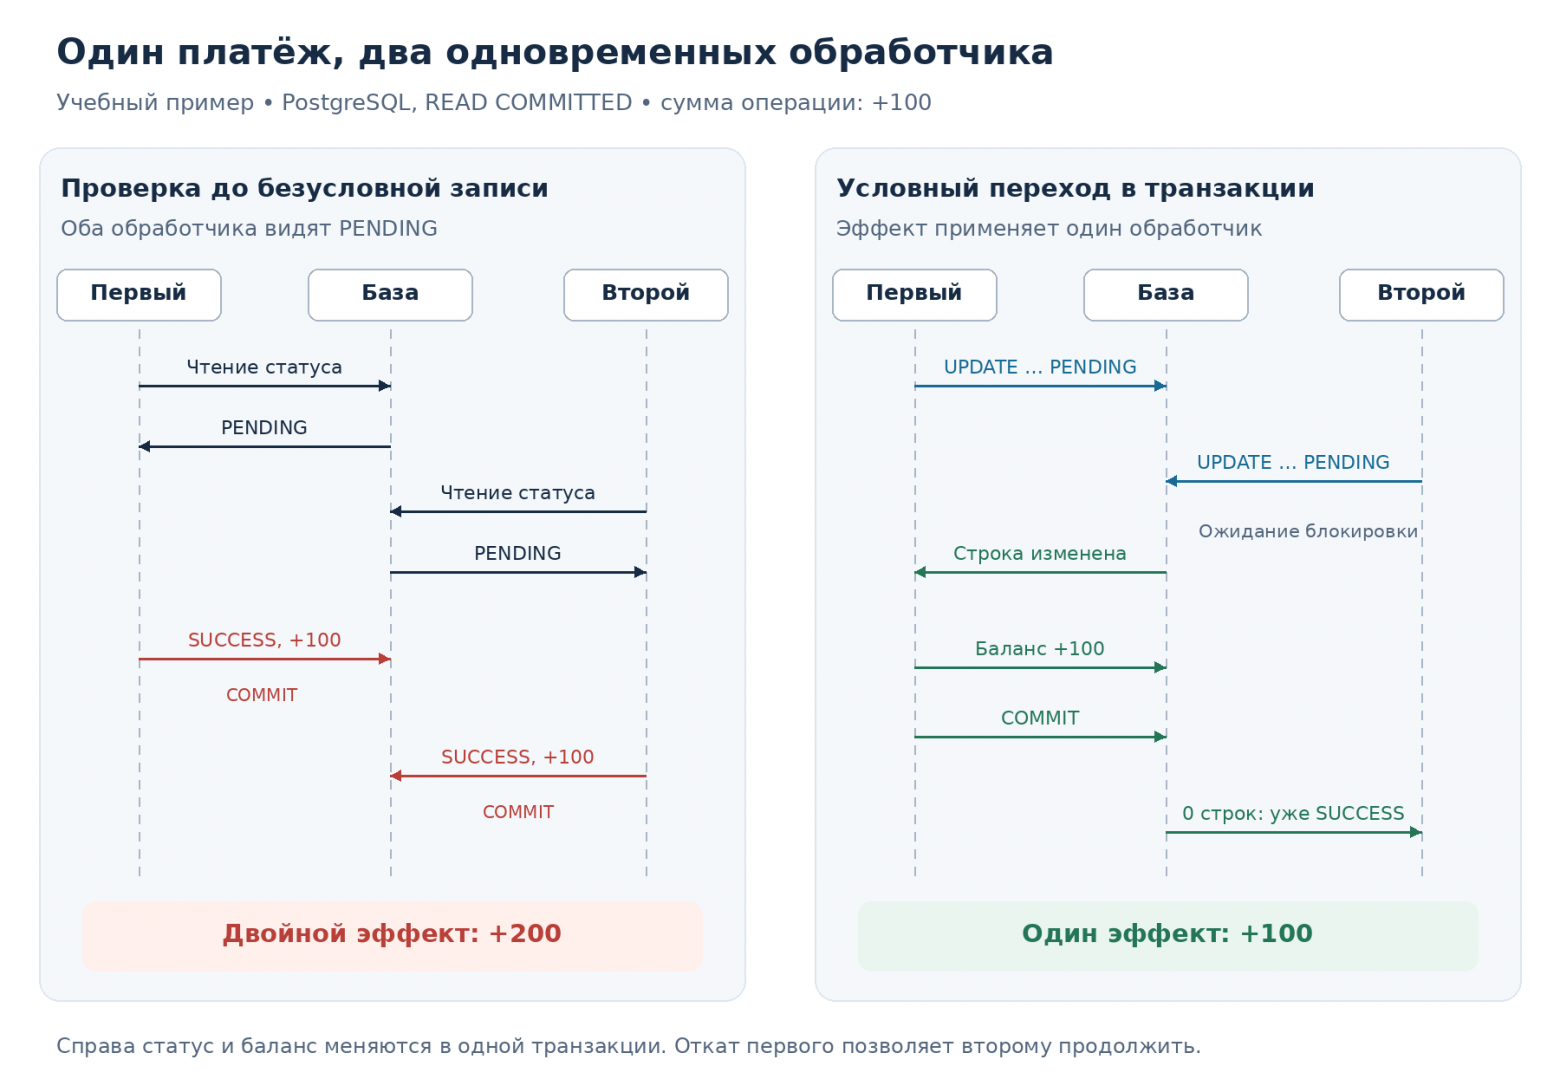
Слева проверка отделена от безусловной записи: оба обработчика получают разрешение. Справа условный переход определяет, какой обработчик применяет эффект. При откате первого второй может продолжить обработку.
Неудачный псевдокод выглядит вполне правдоподобно:
operation = read(operationId)
if operation.status != PENDING:
    return

begin transaction
    set operation.status = SUCCESS
    add operation.amount to wallet
commit
В варианте ниже проверка принадлежит самой операции изменения. PostgreSQL; запись платежа уже создана, сумма хранится целым числом минимальных денежных единиц. Подпись и данные уведомления проверены до вызова, сумма берётся из сохранённой операции, а не из поля запроса.
CREATE FUNCTION credit_once(p_id uuid) RETURNS boolean
LANGUAGE plpgsql AS $$
DECLARE
  p payments%ROWTYPE;
BEGIN
  UPDATE payments
     SET status = 'SUCCESS'
   WHERE id = p_id AND status = 'PENDING'
  RETURNING * INTO p;

  IF NOT FOUND THEN
    RETURN false;
  END IF;

  UPDATE wallets
     SET balance_minor = balance_minor + p.amount_minor
   WHERE id = p.wallet_id AND currency = p.currency;

  IF NOT FOUND THEN
    RAISE EXCEPTION 'Wallet or currency mismatch';
  END IF;

  RETURN true;
END;
$$;
Функция выполняется в транзакции вызывающего запроса. Если обновление кошелька падает с ошибкой, откатывается и смена статуса — при условии, что приложение не перехватывает ошибку внутри собственной транзакции и не фиксирует её частично.
Почему это работает при READ COMMITTED: в PostgreSQL конкурентный UPDATE той же строки ждёт завершения первого, а затем перепроверяет условие на актуальной версии строки. После фиксации перехода в SUCCESS условие status = 'PENDING' уже не выполняется. Если первая транзакция откатилась, операцию применит второй обработчик. Правила описаны в разделе Transaction Isolation.
Это пример однократного эффекта в одной базе, а не платёжная система. Нужны уникальность payments.id, целостность связи платежа с кошельком, ограничения на диапазон и знак суммы. Все пути зачисления должны соблюдать тот же протокол, статус не должен возвращаться в PENDING. false здесь объединяет «операции нет» и «уже обработана» — реальному API могут понадобиться разные ответы.
Если после зачисления нужен внешний вызов, SQL-функция не сделает его атомарным вместе с базой. Отдельно решается, как хранить намерение, повторять доставку и согласовывать состояние. Это расширяет постановку, и слово «идемпотентность» его не закрывает.
Было и стало: та же задача, поставленная заново
Если бы тогда я ставил эту задачу агенту, она звучала бы примерно так:
Сделать внутренний баланс. Пользователь пополняет его через платёжного провайдера, результат приходит webhook’ом. С баланса оплачиваются платные услуги объявлений.
Код по такой формулировке проходит ручную проверку: пополнил, увидел сумму, оплатил услугу, увидел списание. И обе проблемы, которые я позже нашёл в своей реализации, — абсолютная запись баланса и «прочитать PENDING, потом записать» — в неё полностью укладываются. Формулировка описывает функцию, но не свойства операции, поэтому ничто в ней не исключает этих решений.
Сегодня ту же задачу я поставил бы агенту так:
Задача: зачисление пополнения по webhook и списание за платную услугу объявления.

Контекст:
- PostgreSQL. payments(id, wallet_id, amount_minor, currency, status),
  wallets(id, currency, balance_minor).
- Суммы — целые минимальные единицы. Сумма зачисления берётся из payments,
  не из тела webhook.
- Провайдер может повторить webhook, в том числе одновременно с первым.
- API может работать в нескольких репликах.

Обязательные свойства:
1. Платёж зачисляется ровно один раз — при последовательных
   и одновременных повторах.
2. Статус платежа и баланс меняются в одной транзакции. Ошибка на любом
   шаге не оставляет SUCCESS без зачисления.
3. Списание не уводит баланс в минус, даже при двух одновременных оплатах.
4. Баланс не вычисляется в приложении и не записывается абсолютным
   значением — только относительное изменение в SQL.
5. Подпись webhook проверяется до любых изменений в базе.

Тесты (на реальной PostgreSQL, без моков базы):
- два параллельных webhook на один платёж → баланс вырос один раз;
- повтор после успеха → без изменений, успешный ответ провайдеру;
- ошибка при обновлении кошелька → платёж остаётся PENDING;
- две параллельные оплаты при балансе на одну → одна проходит,
  вторая получает отказ.

Вне задачи: возвраты, мультивалютные кошельки, уведомления после зачисления.
Если для свойств 1–3 предлагаешь механизм, отличный от условного UPDATE,
сначала опиши его и обоснуй.
Каждая строка здесь закрывает конкретный способ получить неправильный, но работающий на демо код. Свойство 4 прямо запрещает паттерн, который был у меня. Свойство 3 решается тем же приёмом, что и зачисление: UPDATE wallets SET balance_minor = balance_minor - $1 WHERE id = $2 AND balance_minor >= $1 и проверка числа изменённых строк. Тесты не придуманы отдельно — они выведены из свойств, и каждый ловит определённую ошибку.
Механизм в задании не навязан: в другой модели данных подойдут журнал операций, уникальное ограничение или блокировка строки. Но критерии, по которым варианты сравниваются, заданы до того, как появился первый обработчик.
AI знает транзакции и может предложить несколько корректных решений. Задача человека — включить в постановку условия, в которых оценивается корректность, и проверить, что предложенный механизм их действительно покрывает. Опыт платёжных интеграций делает вопрос о повторе естественным ещё до реализации обработчика.
Решение до генерации: определить гарантии повторного и конкурентного выполнения операции. Зачисление должно иметь однократный эффект, изменение статуса и баланса — выполняться атомарно, а ошибочные и повторные запросы — не нарушать денежные инварианты.
5. Чат: инфраструктура меняет смысл слова «работает»
У чата в маркетплейсе была отдельная база и локальная проекция пользователя, синхронных запросов в основной API на каждое действие он не делал. Сообщение сначала сохранялось, затем отправлялось через Socket.IO. Если мгновенная доставка не срабатывала, история оставалась в базе.
Так сохранность сообщения и доставка в реальном времени были осознанно разделены. Но этой границы оказалось недостаточно.
Чат работал в двух репликах, а общего адаптера для доставки между процессами не было. Участники могли оказаться на разных подах: сообщение сохранялось, но рассылка из комнаты одного процесса не доходила до клиента другого. Сообщение становилось видно только при следующей загрузке диалога.
Это я тоже нашёл позже, при чтении кода. На софт-ланче нагрузки не хватило, чтобы проблема проявилась, а теста с двумя пользователями на разных репликах не было. Отсутствие жалоб ничего не доказывало о корректности топологии.
Запрос «реализуй чат на Socket.IO» не определяет число процессов, маршрутизацию соединений и восстановление после разрыва. А добавление второй реплики в инфраструктуре меняет условия выполнения уже работающего кода.
Документация Socket.IO отдельно разбирает работу на нескольких серверах. Это две разные задачи: при HTTP long-polling запросы одной сессии должны попадать на один сервер (sticky sessions), а рассылку клиентам на других серверах обеспечивает адаптер — например, Redis adapter. Первое не решает второе.
До генерации кода стоит определить, сколько процессов обслуживает чат, где хранится история, что ожидается при рестарте, допустимо ли временное отсутствие real-time доставки и как клиент восстановит пропущенное. Затем эти условия должны появиться в тестах: два клиента на разных процессах, разрыв соединения, переподключение и восстановление истории.
Сразу строить распределённую систему не обязательно. На конкретной стадии продукта может хватить одной реплики и явно принятого ограничения доступности. Но «одна реплика пока достаточна» — решение. «Код тестировали в одном процессе, а инфраструктура запустила два» — пробел в постановке.
Кто имеет право читать этот диалог
В том же проекте guards проверяли, что пользователь аутентифицирован, но в ряде действий не проверялось его участие в конкретном чате. Ещё одна находка при разборе собственного кода. Guard на каждом обработчике создавал ощущение, что вопрос доступа закрыт.
В задании «чат для авторизованных пользователей» легко не уточнить, кто может подписываться на конкретный диалог, читать его историю и отмечать сообщения прочитанными. Требование должно относиться к ресурсу и действию, а не к факту входа в систему — так же рекомендует OWASP Authorization Cheat Sheet.
После правильного вопроса проверка очевидна: пользователь вне диалога не получает его сообщения, даже зная идентификатор. Это проверка обещанного свойства.
Свои ошибки я включаю намеренно. Опыт не означает, что человек заранее заметил всё в каждом проекте. Его ценность в том, какие модели отказа попадают в следующие решения. После такого разбора вопросы о репликах и правах на ресурс появляются в постановке, а не ждут инцидента.
Решение до генерации: определить модель хранения и доставки сообщений с учётом числа реплик, разрывов соединения и восстановления истории. Отдельно установить правила доступа к конкретному диалогу. Работающий WebSocket-сценарий сам по себе не подтверждает ни доставку, ни авторизацию.
AI на всём пути от разговора с клиентом до деплоя
Я использую AI на всех этапах: от фиксации договорённостей с клиентом и разбора макетов до кода, тестов, сборки и деплоя; основные инструменты — Claude Code и ChatGPT. Архитектурные предложения и рефакторинг ключевых модулей проверяю сам, для рутинных задач беру более дешёвые модели. Выбор инструмента не отменяет вопроса, можно ли проверить порученную работу и чем обойдётся ошибка.
Раз AI участвует и в подготовке решений, и в реализации, инженерная постановка нужна на всём пути. Ниже обобщённая модель; наблюдаемость и эксплуатация в ней — направление развития, а не полностью внедрённый конвейер.
|
Этап |
Работа, которую можно поручить AI |
Что нужно определить инженеру |
|---|---|---|
|
Требования |
Структурировать разговор, выделить вопросы и зависимости |
Что согласовано, что предположено, кто принимает решение |
|
Архитектура |
Исследовать код и сравнить варианты |
Ограничения, альтернативы, допустимую цену |
|
Контракты |
Подготовить API и задания на компоненты |
Смысл данных, потребителей, совместимость и ошибки |
|
Реализация |
Написать код в согласованных границах |
Где расширять, что сохранять, что требует отдельного решения |
|
Ревью |
Проанализировать diff и возможные последствия |
Критичные свойства и способ независимой проверки |
|
Тестирование |
Подготовить и выполнить проверки |
Ожидаемый результат, ошибки и граничные сценарии |
|
CI/CD |
Изменить конфигурацию, разобрать сборку |
Окружение, полномочия, порядок действий и условия остановки |
|
Наблюдаемость |
Помочь сформулировать сигналы и диагностические гипотезы |
Как выглядит пользовательский успех и допустимая деградация |
|
Эксплуатация |
Подготовить варианты диагностики и восстановления |
Какие действия разрешены и чем подтверждается восстановление |
Контекст должен переходить между этапами
Резюме встречи — ещё не техническое задание. В нём смешаны намерение клиента, спорные формулировки и предположения, высказанные вслух. Если передать это дальше без разбора, код точно реализует то, о чём никто окончательно не договорился.
Макет тоже не описывает все состояния интерфейса: загрузку, отсутствие данных, ошибку, отказ в доступе. Для API важен не только успешный JSON, но и смысл статусов, границы доверия и поведение потребителей. На каждом переходе AI помогает найти пропуски, но полноту результата оценивают в контексте задачи.
Агент с доступом к Figma извлекает визуальные данные, но не решает, менять конфигурацию бренда или общий компонент. Эти два вопроса полезно разделять.
Тесты наследуют качество постановки
Если в задании был только успешный сценарий, сгенерированный тест честно проверяет именно его. Для конкурентности, совместимости или доступа нужны отдельные ожидания. Полезный вопрос к любому тесту: какое неправильное поведение он способен поймать?
В маркетплейсе были отдельные тестовые данные и E2E основного API, но не было сценария чата с клиентами на разных репликах. Наличие тестового набора этого не компенсировало. Поэтому обсуждение проверок я начинаю с рисков конкретного изменения, а не с желаемого числа тестов.
AI может написать тест, подготовить данные и запустить проверку. Инженер решает, соответствует ли проверка требованию и не повторяет ли она предположение самой реализации. Независимость проверки определяется её смыслом — запуск второй модели её не гарантирует.
Скорость команды тоже входит в задачу
В мультибрендовой платформе я написал слой сборки, который по конфигурации бренда определял его зависимости и контекст стилей. Разработчик пересобирал активную часть вместо всего графа. К этому пришлось прийти, когда скорость обратной связи стала ограничением.
Если команда быстро генерирует изменения, но долго ждёт сборку или не понимает, что проверять, узкое место просто перемещается. Поэтому в постановке процесса я учитываю время до проверяемого результата, а не только время до diff.
Чек-лист постановки
Перечень работает и перед генерацией, и при приёмке. Глубина для лендинга, внутреннего прототипа и платёжного сервиса разная. Задача — заметить вопросы, ответы на которые меняют решение.
-
Цель и срок жизни. Что проверяем или выпускаем? Это эксперимент, временное решение или основа сервиса? Какие сценарии сознательно не покрываем?
-
Область изменений. Где граница задачи? Какие модули и потребители могут быть затронуты? Что должно сохранить поведение?
-
Место расширения. Требование выражается конфигурацией, новым адаптером или вариантом — или придётся менять несколько сервисов? Если второе, есть ли сначала смысл спроектировать точку расширения? Появляется ли где-то выбор поведения по типу источника или клиента?
-
Контракты и доставка. Какие версии сосуществуют? В каком порядке выходят схема, backend и frontend? Что означает откат для приложения и для данных?
-
Повторы и конкурентность. Может ли действие выполниться дважды или одновременно? Каков допустимый конечный результат? Где механизм, который это обеспечивает?
-
Частичный сбой. Что будет, если первый шаг завершился, а второй нет? Откуда система продолжит и кто заметит промежуточное состояние?
-
Доступ и данные. Кто имеет право на действие над конкретным ресурсом? Какие данные можно передать инструменту, где секреты, что попадёт в логи?
-
Условия выполнения. Объёмы, число процессов, внешние зависимости. Воспроизводят ли проверки существенные особенности этих условий?
-
Жизненный цикл данных. Что истекает, удаляется или переносится? Как система ведёт себя при задержке и повторе фоновой задачи? Kubernetes, например, прямо требует учитывать повторный запуск в документации CronJob.
-
Проверяемость. Какое нарушение ловит каждый важный тест? Какие свойства остались без подтверждения? Компиляция и удачный скриншот этих ответов не дают.
-
Выпуск и восстановление. Какой артефакт доставляем, какие действия разрешены агенту, когда останавливаем процесс и чем подтверждаем восстановление?
-
Результат после релиза. Как выглядит успех пользователя? Кто следит за сигналами, разбирает отклонения и принимает оставшиеся риски?
Если ответ не влияет на решение, документация вокруг него не нужна. Если влияет — он должен пережить текущий диалог с моделью: в контракте, задаче, архитектурной заметке или тесте. Тогда следующему участнику не придётся восстанавливать замысел по истории переписки.
Что опыт добавляет к сильному инструменту
AI делает реализацию доступнее и быстро ведёт от идеи к работающему сценарию. Для прототипа этого иногда достаточно. Для системы, которую предстоит развивать, остаётся вопрос: что было заложено в задачу и какие свойства результата подтверждены.
Без соответствующего опыта труднее заметить часть пропусков: независимость релиза, границу вариативности, конкурентный повтор, права на ресурс, состояние после сбоя. AI помогает их обнаружить, но польза его ответа зависит от контекста и от способности человека оценить предложенное.
Опытному инженеру здесь стоит сделать свои неявные ожидания явными. Если совместимость существует только в голове, агент не угадает всех потребителей. Если допустимый сбой не описан, красивый код этот вопрос не закроет. Опыт приносит пользу, когда превращается в решение, ограничение или проверку.
Начинающему разработчику эти вопросы дают путь роста. AI можно использовать не только для очередной функции, но и для разбора того, что с ней будет при повторе, изменении данных или появлении второго потребителя, — а затем проверять ответы и собирать собственные модели системы.
Руководителю стоит оценивать не скорость появления кода, а весь путь до принятого изменения: постановку, реализацию, проверку, выпуск и сопровождение. Именно там видна разница между командой, которая быстро генерирует, и командой, которая быстро выпускает.
Для меня в этом и состоит инженерная работа с AI: ещё до реализации определить, что система должна сохранить, когда требования начнут меняться.
Автор: vitaliifalkevych