
Как на Python описать архитектуру сервисов и превратить её в код
Когда основная работа над публичным API библиотек для Go, C++, Python, Rust и TypeScript была закончена, встал следующий вопрос: а как теперь удобно описывать саму архитектуру? Не только собрать первый пример, но и вносить изменения, обсуждать их на ревью, проверять корректность связей и не запутываться по мере роста проекта.
В Service Architect к этому моменту уже были визуальный дизайнер и YAML-представление модели. Это не отдельная схема для документации: генератор превращает модель в код связей между этапами, инфраструктуру и контракты бизнес-функций. Реализации бизнес-функций пишет разработчик, самостоятельно или с агентом. Хотелось, чтобы та же модель помогала работать над изменениями: сначала увидеть нужный сценарий и его зависимости, затем раскрыть детали, не исследуя каждый раз весь проект.
Граф для этого удобен: видно, откуда приходят данные и куда попадают дальше. Но удобная визуализация не всегда оказывается удобным редактором. Собирать мышкой похожие фрагменты в нескольких сценариях и последовательно менять их довольно утомительно.
YAML решает другую задачу. Его удобно хранить, передавать между инструментами и использовать как вход генератора. Но вручную редактировать большую модель в YAML мне не понравилось: много однообразных объявлений, ссылок по именам и мест, в которых легко ошибиться. Можно вынести текст в отдельные файлы, но от этого в нём не появятся нормальные функции и параметры.
На помощь приходит Python
В итоге решил попробовать описывать архитектуру на обычном языке программирования. Python оказался для этого удобен: у него достаточно короткий синтаксис, есть функции, модули и именованные аргументы. Вместо повторения строк с именами можно передавать ссылки на объекты. Повторяющийся участок графа можно описать один раз и использовать с разными параметрами. А IDE помогает найти объявление и подсказывает доступные свойства.
Python здесь нужен только для построения модели. Сам сервис может быть написан на другом языке, а его архитектуру по-прежнему можно рассматривать в дизайнере и сохранять в YAML. Вместо ручного редактирования большого документа мы получаем исходник, который можно разбить на модули и собирать из понятных частей.
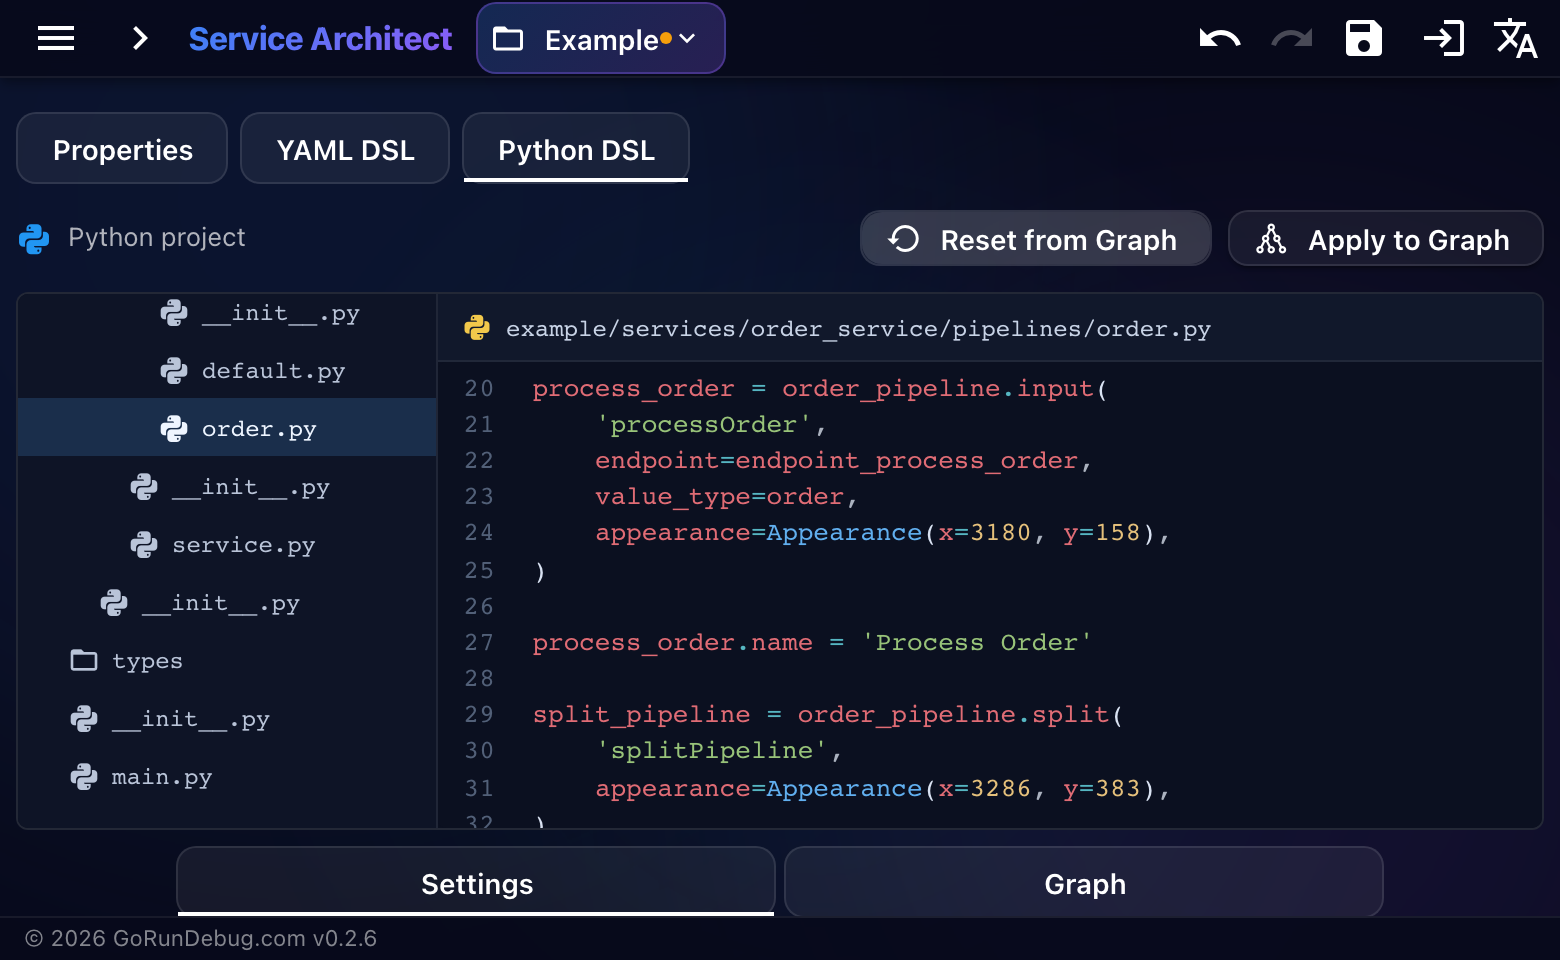
Python-редактор в дизайнере: слева структура проекта, справа объявления узлов. На снимках интерфейса используется встроенный пример ProcessOrder; сервис доставки ниже остаётся отдельным условным примером.
Между Python и YAML можно переходить в обе стороны, но с важной оговоркой: переносится построенная модель, а не весь исходный Python-код. Из YAML можно восстановить объявления узлов, связей, типов, пайплайнов и компонентов. А вот написанные вручную функции-фабрики, циклы, условия и комментарии в YAML не сохраняются и при обратном импорте не появятся. Поэтому YAML подходит для обмена архитектурой, но не заменяет сохранение Python-исходников.
Например, так можно описать небольшой участок расчёта доставки. Объект service, вход incoming и типы located_request и delivery_options здесь уже объявлены в соседних модулях модели:
from sa_dsl import Function

quote = service.pipeline("quote")

locate = quote.map(
    "Determine Delivery Zone",
    function=Function("LocateDeliveryZone"),
    value_type=located_request,
)

calculate = quote.map(
    "Calculate Delivery Options",
    function=Function("CalculateDeliveryOptions"),
    value_type=delivery_options,
)

incoming >> locate >> calculate
Последняя строка связывает вход с определением зоны доставки и последующим расчётом предложений. Тела CalculateDeliveryOptions здесь нет: объявление указывает, какая бизнес-функция нужна на этом месте и какой результат она производит. Её реализация будет написана на языке сервиса. Это пока только фрагмент: результат расчёта дальше нужно подключить к подготовке ответа.
Объявления и связи теперь можно организовывать обычными средствами Python. Но важно помнить, что этот код выполняется при построении модели, а не при обработке заказа. Например, if в Python выбирает, какой граф мы построим. Условие, которое должно проверяться для каждого запроса, относится уже к ветке графа или бизнес-функции. Корректный Python также не гарантирует корректную топологию: совместимость типов и допустимость соединений проверяет валидатор модели.
Но огромный плоский список узлов останется трудным для чтения и на Python. Теперь нужно выбрать, какие части системы показывать на общей схеме, а какие раскрывать только при работе над конкретной задачей.
Продолжим пример с доставкой. Предположим, курьерская доставка уже работает, а нам нужно добавить пункты выдачи и проверить новую логику, не меняя поведение старой. Посмотрим, какое описание системы поможет взяться за такую задачу.
Одной схемы недостаточно
На общем плане наша система может выглядеть так:
Оформление заказа -> Сервис доставки -> API перевозчиков
Для разговора о границах сервисов этого достаточно. Для добавления пункта выдачи уже нет: непонятно, где принимается решение о способе доставки и что зависит от результата.
Открываем нужный сценарий:
Запрос расчёта
      |
Проверить условия доставки
      |
Подобрать доступные способы
      |
Рассчитать предложения
      |
Подготовить ответ
Теперь можно обсуждать изменение. Но разбираться с тем, почему определённый перевозчик не обслуживает выбранный адрес, по такой схеме всё ещё неудобно. Для этого надо открыть соответствующую бизнес-функцию: там будут справочники, ограничения, преобразования адреса и вызовы SDK.
Все три представления нужны, но для разных вопросов. Сервис представляет самостоятельную единицу запуска и развёртывания, пайплайн выделяет сценарий, а узлы показывают существенные этапы обработки. Повторяющиеся фрагменты можно обозначить компонентами и сворачивать при просмотре. Детали каждого этапа остаются в обычном коде бизнес-функции.
Это не строгая лестница вложенности: компонент не обязателен, а его повторения могут находиться в разных пайплайнах. И визуальная группировка не задаёт способ выполнения. Очереди, параллельные вызовы и обращение к подграфу описываются отдельно.
Сворачивая контекст, мы оставляем перед глазами ответственность фрагмента, его вход, результат и существенные зависимости. Разворачивая, добираемся до нужных узлов и реализации. Важно сохранить этот путь, а не просто спрятать детали за прямоугольником «Доставка».
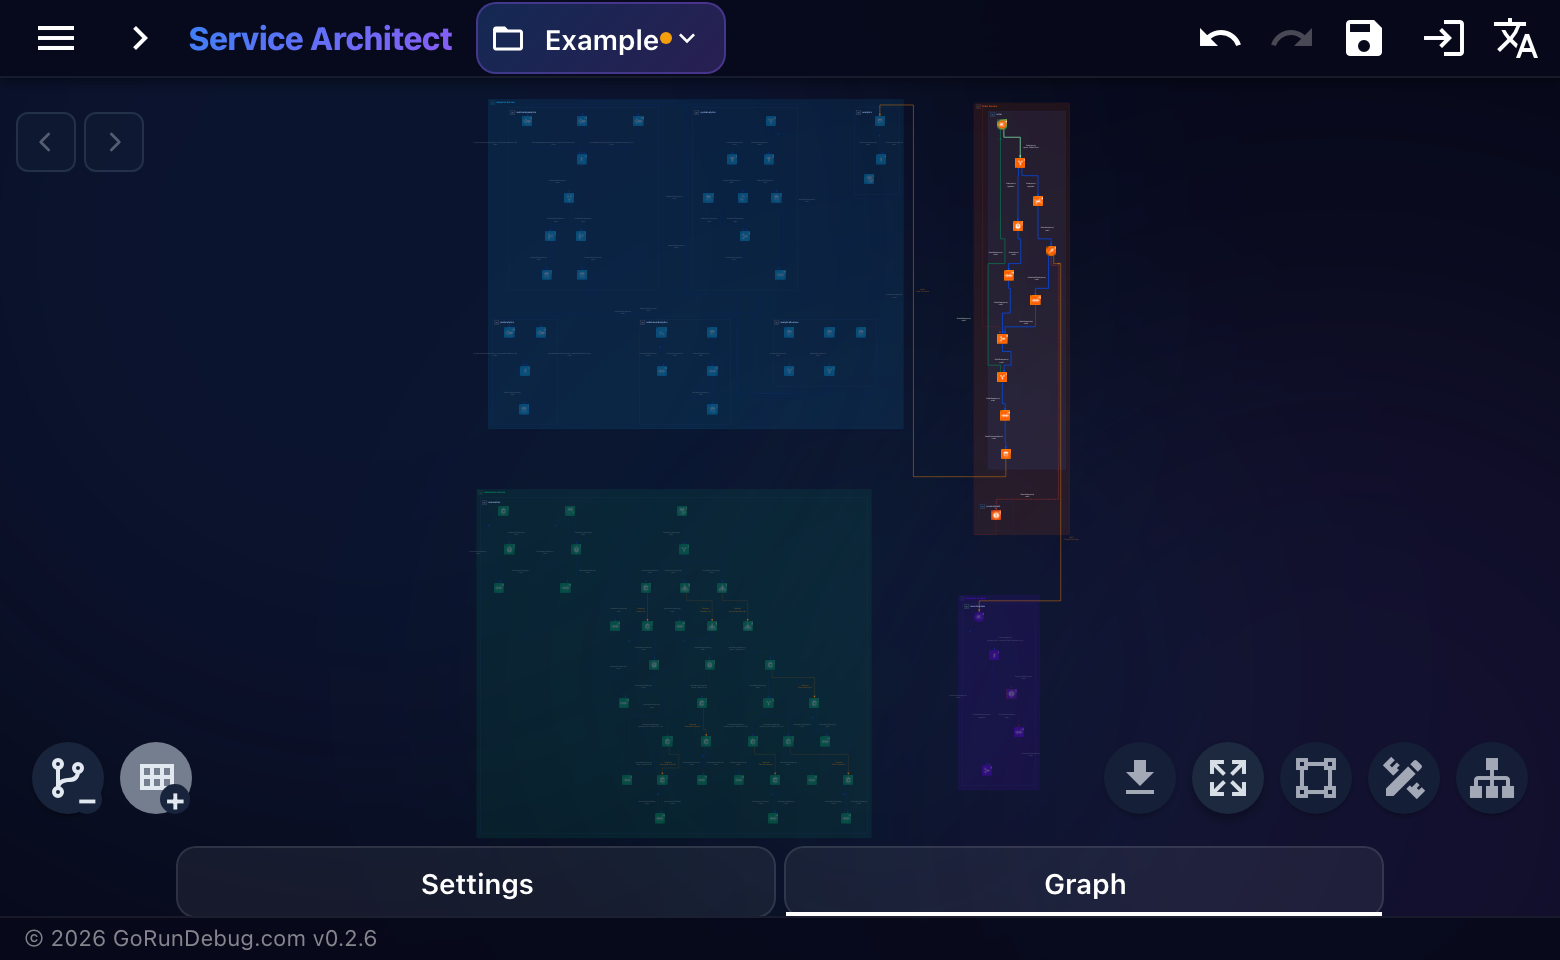
Полностью раскрытый ProcessOrder. Видны отдельные узлы и связи, но для разговора о системе целиком подробностей уже слишком много. Это один из масштабов работы, а не обязательный вид на каждый день.
Что именно находится на графе
Граф задаёт потоки типизированных сообщений. Например, узел «Подобрать доступные способы» может получать DeliveryRequest, а выдавать EligibleDeliveryOptions. Как именно он получает ограничения перевозчиков, остаётся внутри реализации, если для понимания процесса это не отдельный этап. На схеме важно показать решения и результаты, от которых зависит дальнейшая обработка.
В нашем примере стоит различать два исхода:
-
В этот пункт выдачи нельзя доставить посылку такого размера.
-
Система перевозчика не ответила, и возможность доставки пока неизвестна.
Если дальше эти ситуации обрабатываются по-разному, различие должно быть видно в контрактах и маршруте обработки. Спрятать обе за одним пустым списком предложений было бы удобно технически, но неудобно для понимания системы.
А вот превращать в отдельную ноду проверку postal_code != "" необязательно. Если это внутренняя часть проверки адреса, пусть там и остаётся.
У меня нет правила «не больше десяти узлов на пайплайн». Есть другой вопрос: если убрать этот этап со схемы, потеряет ли читатель важное знание о поведении процесса? Если нет, возможно, ему место внутри функции.
Полезен и обратный вопрос. Если в узле с названием ProcessRequest одновременно выбирается перевозчик, считается цена, оформляется отправление и запускается компенсация, что именно этот узел объясняет? Такой граф уже слишком свёрнут.
Зачем нужны пайплайны
У сервиса доставки может быть несколько сценариев: предварительная оценка, окончательный расчёт при оформлении заказа, обработка уведомления перевозчика.
Их удобно разнести по пайплайнам. Открывая quote, я хочу видеть расчёт, а не разбираться одновременно с обработкой уведомлений. Это способ организовать модель по понятным сценариям.
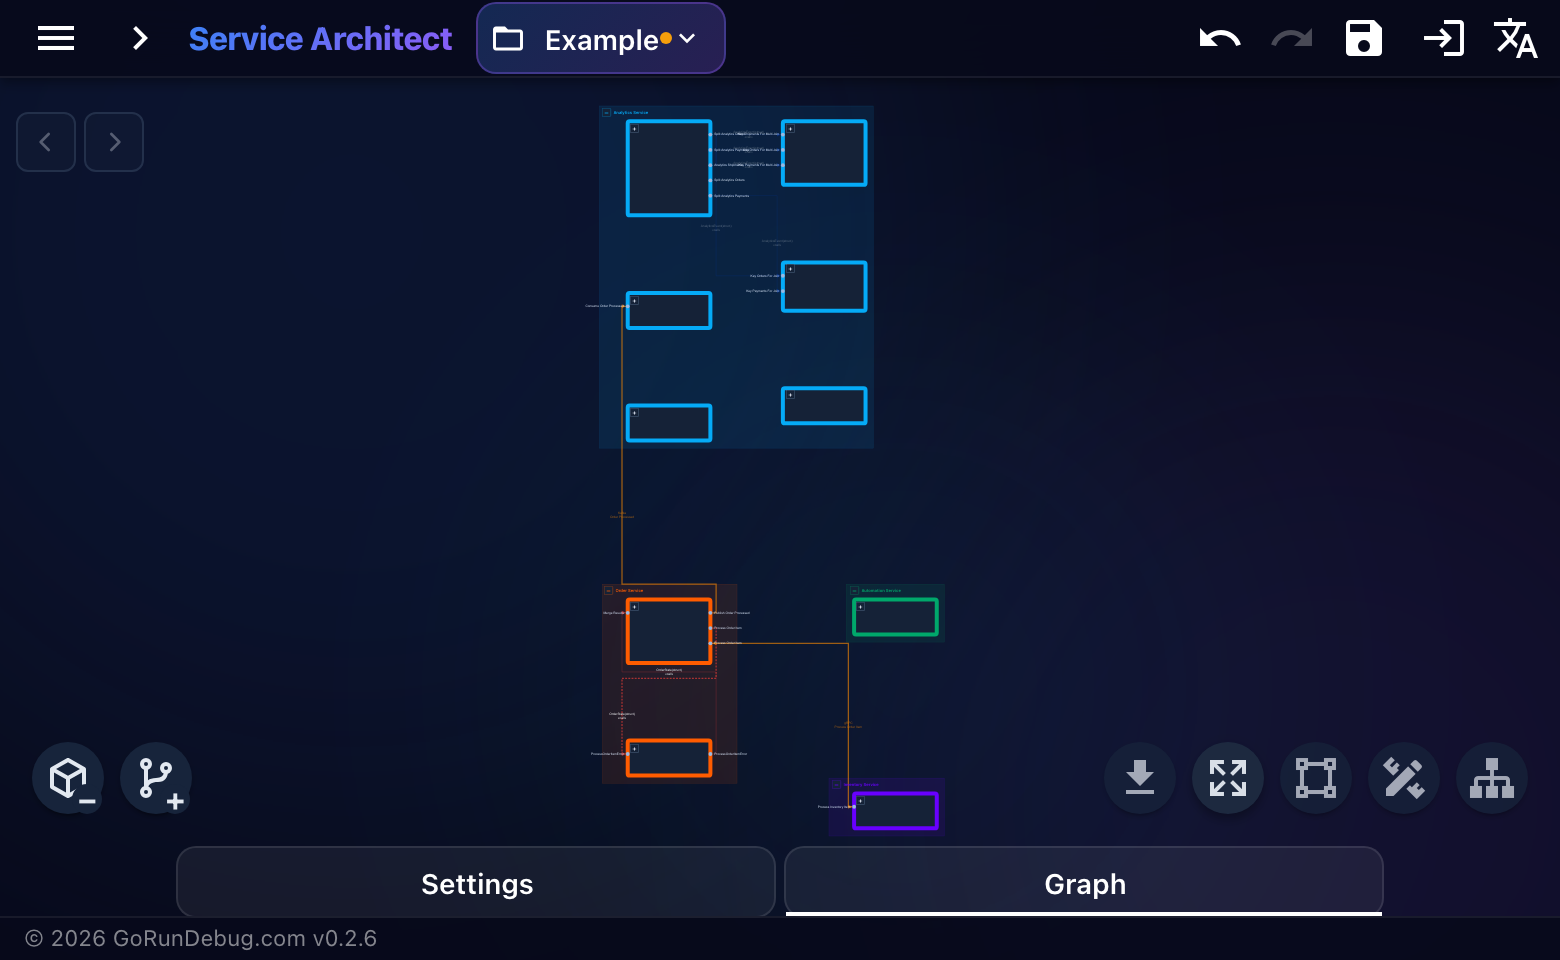
Тот же граф на уровне пайплайнов. Внутренние узлы скрыты, а связи между сценариями остаются видны. Нужный пайплайн можно раскрыть отдельно.
Но граница пайплайна не означает границу процесса, сетевой вызов или отдельный поток выполнения. Само по себе перемещение узла в другой пайплайн не должно превращать обычный вызов в асинхронный. За выполнение отвечают операторы, настройки связей и runtime.
Между узлами разных пайплайнов могут быть связи. Одну бизнес-функцию можно использовать в нескольких местах. Поэтому папка пайплайна не является гарантией того, что изменение внутри неё локально по последствиям.
В Python-модели я бы разложил этот пример примерно так:
delivery_architecture/
    main.py
    types.py
    services/
        delivery.py
    pipelines/
        estimate.py
        checkout.py
        carrier_notification.py
    fragments/
        quote.py
Это структура исходников архитектуры, не обещание такого же расположения файлов в каждом сгенерированном языке. Локальные связи удобно держать рядом с объявлением пайплайна, связи между пайплайнами собирать на уровне сервиса.
Повторение в Python и повторение на схеме
Предварительная оценка и оформление заказа могут использовать одинаковые этапы определения зоны и расчёта тарифа. Различаться будут входные данные и действия после расчёта.
В Python повторение можно выразить обычной функцией:
def quote_fragment(pipeline, source, *, prefix):
    locate = pipeline.map(
        f"{prefix} Determine Zone",
        function=Function("LocateDeliveryZone"),
        value_type=located_request,
    )
    calculate = pipeline.map(
        f"{prefix} Calculate Options",
        function=Function("CalculateDeliveryOptions"),
        value_type=delivery_options,
    )
    source >> locate >> calculate
    return locate, calculate


estimate_nodes = quote_fragment(
    estimate_pipeline, estimate_input, prefix="Estimate",
)
checkout_nodes = quote_fragment(
    checkout_pipeline, checkout_input, prefix="Checkout",
)
При построении модели функция вызывается дважды и создаёт два конкретных фрагмента графа. Это не два вызова сервиса доставки и не запуск расчёта: пока мы только описываем топологию.
В YAML попадут оба построенных фрагмента. Если затем восстановить Python из этого YAML, мы получим явные объявления их узлов и связей, а не функцию quote_fragment с двумя вызовами. Поведение описанного графа от этого не должно измениться, но удобное переиспользование исходника придётся сохранить в оригинальном Python-проекте.
Python-функция убрала дублирование в исходнике модели. Но на картинке по-прежнему будут две цепочки узлов. Чтобы показать, что это повторения одного фрагмента, используется визуальный компонент:
pricing = service.component("Delivery Quote")
pricing.fragment(*estimate_nodes)
pricing.fragment(*checkout_nodes)
В дизайнере такие фрагменты можно рассматривать в свёрнутом виде и раскрывать для изучения внутренностей. Снаружи остаются связи с окружающим графом. Внутри остаются реальные узлы, а не нарисованная вместо них заглушка.
Компонент в текущей модели именно визуальный. Он не создаёт новый сервис, не добавляет очередь и не заменяет повторяющиеся узлы одним общим исполняемым экземпляром. Изменение представления не должно менять прохождение сообщения.
Повторения проверяются на структурную и контрактную эквивалентность, а не просто на одинаковую подпись прямоугольника. Это не проверка эквивалентности произвольного бизнес-кода.
И это не произвольная иерархия вложенных папок: вложенные и пересекающиеся компоненты не поддерживаются. Для навигации уже есть сервисы и пайплайны, а компонент решает более узкую задачу: обозначает повторяющийся связный фрагмент.
Python-фабрика убирает повторение в исходнике, компонент помогает читать граф. Одно не возникает автоматически из другого.
Когда нужен сабстрим
До этого мы говорили о том, как организовать и показывать граф. Теперь задача другая: вызвать его участок во время выполнения, передать аргумент и собрать результаты.
Например, бизнес-функции проверки заказа нужно рассчитать доставку для нескольких допустимых вариантов упаковки. Эти варианты определяются данными запроса, поэтому описывать каждый возможный вызов отдельной статической цепочкой неудобно.
Тут подходит SubStream: вызываемый подграф внутри одного сервиса. У него есть тип входного значения и привязанный производитель результата. Тело собирается из тех же операторов, что и остальная модель.
Минимальный фрагмент объявления с теми же заранее определёнными типами:
quote_pipeline = service.pipeline("reusable_quote")

entry = quote_pipeline.substream(
    "Quote Delivery",
    value_type=delivery_request,
)

result = quote_pipeline.map(
    "Calculate Quote",
    source=entry,
    function=Function("CalculateQuote"),
    value_type=delivery_options,
)

result >> entry
Последняя строка выглядит как цикл, но у SubStream у неё специальный смысл: это привязка результата вызова. Она не отправляет полученное предложение на очередной круг расчёта.
В сгенерированном сервисе появляется типизированный доступ к сабстриму. Бизнес-код вызывает его через интерфейс своего runtime, передаёт значение и обработчик результатов. Этот обработчик определяет завершение вызова: например, достаточно одного итогового списка предложений или нужно дождаться нескольких результатов.
Это уже контракт выполнения, а не способ свернуть картинку.
Дальше начинаются требования уже к реализации бизнес-логики в коде сервиса, а не к Python-описанию архитектуры. При вызове сабстрима и передаче данных дальше нужно сохранять контекст вызова, а для ожидания с неопределённым сроком задавать deadline. Вызывающий код должен учитывать, что завершение сбора результатов не означает принудительную остановку всей работы внутри подграфа. Сам сабстрим не добавляет очередь и не делает вызов долговечным при перезапуске процесса.
Пайплайны для Temporal
Расчёт цены обычно укладывается в один запрос. А оформление отправления может занять гораздо больше времени: нужно создать заявку у перевозчика, подождать и проверить её состояние. Чтобы процесс переживал перезапуск приложения, можно описать пайплайн в контексте Temporal Workflow, а обращения к внешним системам вынести в Temporal Activity. На графе будет видна сама последовательность действий, а не только прямоугольник «вызвать Temporal».
Условный фрагмент процесса:
Workflow оформления отправления
      |
Создать заявку у перевозчика       [Activity]
      |
Дождаться времени проверки        [Workflow timer]
      |
Получить состояние заявки         [Activity]
      |
Выбрать дальнейшее действие       [Workflow logic]
При разборе зависшей заявки можно открыть workflow-пайплайн и увидеть, где он ждёт и какую activity вызывает. Python здесь только описывает модель; сами workflow и activity поддерживаются в Go, Python и TypeScript.
В реализации нужно соблюдать правила Temporal: workflow должен детерминированно воспроизводиться по сохранённой истории и ждать через workflow-таймеры, а повтор activity не должен случайно создавать вторую посылку. Поэтому изменения проверяют и на новых запусках, и на воспроизведении истории уже выполняющихся процессов, включая повторные попытки activity.
Python-описание архитектуры не проверяет эти свойства бизнес-кода. Ошибки типов и использования API могут обнаружиться при сборке, но успешной компиляции недостаточно для проверки детерминированности и идемпотентности.
А когда нужен отдельный сервис
Пока расчёт доставки живёт внутри приложения оформления заказа, нет обязанности выносить его в отдельный процесс.
Причина появляется, если его нужно независимо развёртывать, масштабировать, отдавать другой команде или использовать из нескольких приложений через стабильный API. Тогда это граница сервиса, а не просто ещё один уровень сворачивания.
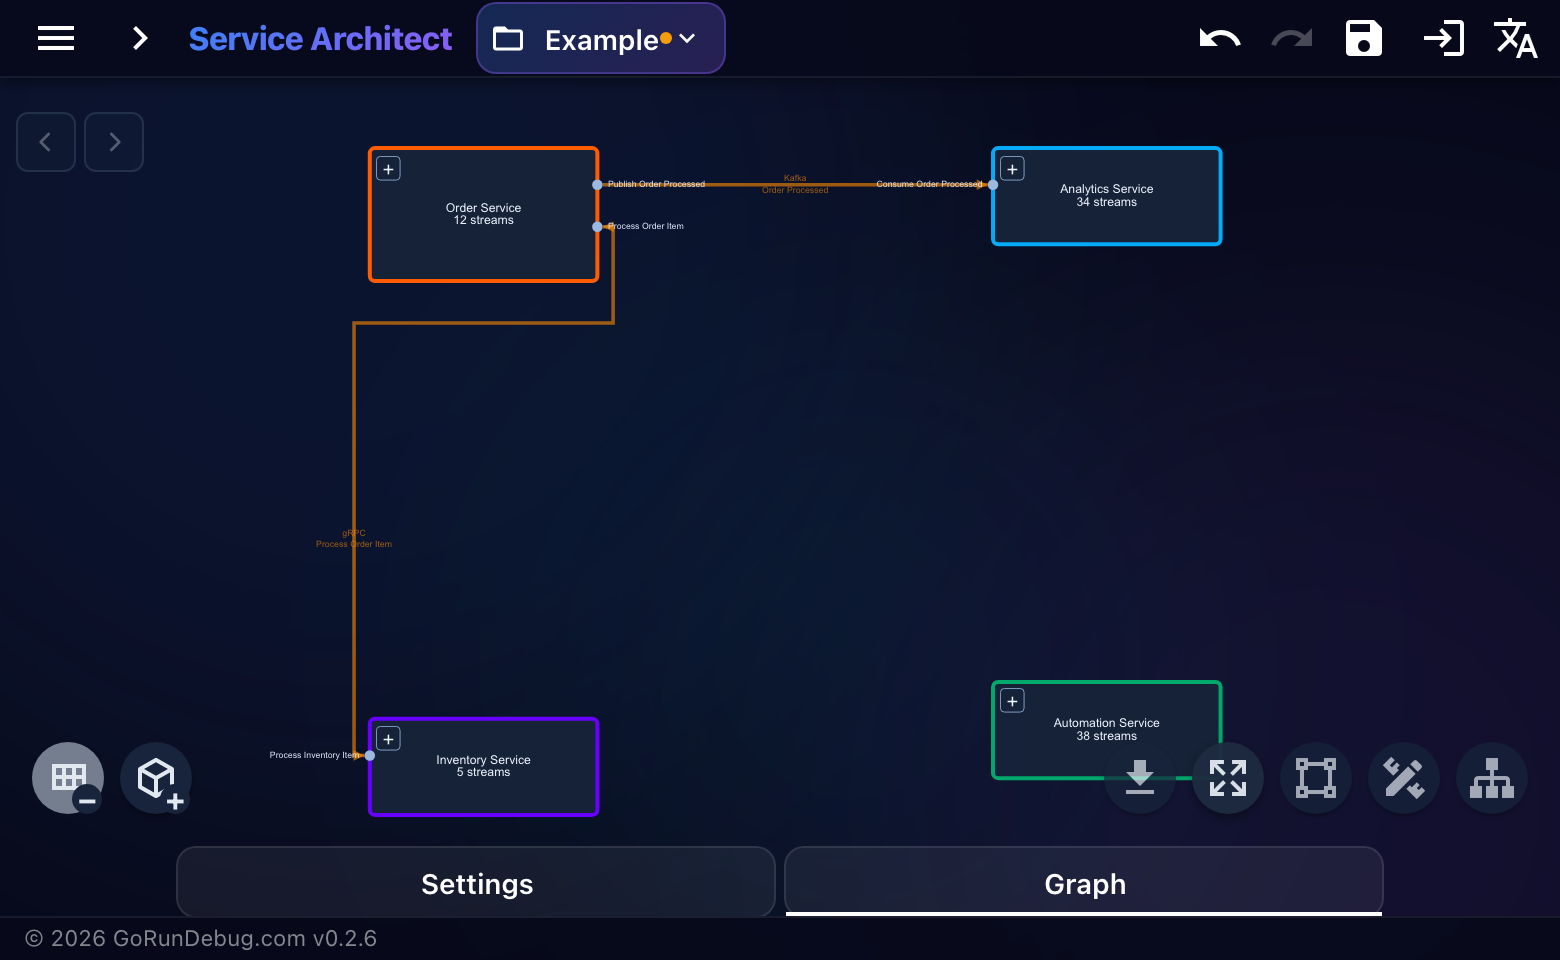
Ещё один шаг сворачивания: перед нами сервисы и связи между ними. Топология не изменилась, изменился только уровень детализации.
У сетевого вызова появляются задержки, таймауты, частичные отказы, совместимость контрактов и вопрос о том, безопасно ли повторять запрос.
Поэтому я бы разделял четыре решения:
|
Что нужно сделать |
Что для этого подходит |
|---|---|
|
Отделить один сценарий от соседних |
Пайплайн |
|
Компактно показать повторяющийся участок |
Визуальный компонент |
|
Вызвать подграф из бизнес-кода в том же сервисе |
SubStream |
|
Получить самостоятельную единицу запуска и развёртывания |
Сервис с явным API |
Не обязательно сразу переписывать работающий сценарий
Есть и более практичная причина явно описывать пайплайн. Когда хочется проверить другую реализацию, можно не начинать с переделки действующего маршрута.
Предположим, сейчас перевозчик выбирается по минимальной цене. Мы хотим попробовать учитывать ещё срок доставки и вероятность отказа. Можно создать рядом второй пайплайн, сохранить подготовку данных и формат результата, а в нужном месте подключить другую бизнес-функцию:
Действующий вариант
Подготовить запрос -> Получить предложения -> Выбрать по цене -> Ответ

Экспериментальный вариант
Подготовить запрос -> Получить предложения -> Выбрать по новой модели -> Ответ
Копировать можно весь сценарий или только нужный участок. Общую часть в Python-модели можно оставить в функции сборки, а различия передавать аргументами. Если собрать оба варианта, в развёрнутом графе будут видны два конкретных маршрута.
Но копировать граф нужно не всегда. У бизнес-функций есть мейкеры, через которые можно внедрять зависимости. Например, мейкер получает через DI реализацию ранжирования и передаёт её создаваемой бизнес-функции. Для проверки новой логики можно подставить другую реализацию, сохранив тот же граф и контракты узла. Это происходит в коде сервиса, а не в Python-описании архитектуры. Отдельный пайплайн нужен, когда мы хотим явно показать альтернативный маршрут или изменить последовательность обработки, а не просто заменить зависимость внутри функции.
Для меня это меняет сам способ работы. Вместо «сначала разберись со всеми ветками старой реализации и аккуратно встрои новую» появляется вариант «собери альтернативу с понятными входом и выходом и дай её проверить». Старый сценарий остаётся рядом как точка сравнения.
Новую ветку можно подключить к отдельной тестовой входной точке, прогнать на подготовленном наборе запросов или развернуть отдельно. Проверять стоит не только успешный ответ: какие предложения исчезли, где изменилась цена, как обработан отказ перевозчика, не выросло ли число внешних обращений. После этого уже решать, переключать ли основной маршрут.
Конечно, копия графа не создаёт изолированную копию всего окружающего мира. Если оба пайплайна ссылаются на одну бизнес-функцию и мы меняем её тело, изменение касается обоих. Для независимого эксперимента нужна отдельная реализация в изменяемом месте. База, кеш и API перевозчика также могут оставаться общими.
Поэтому расчёт предложений удобно сравнивать на одинаковых данных, а создание реальных отправлений нельзя просто запустить дважды «для сравнения». Здесь нужны тестовый контур, заглушка внешнего эффекта или отдельные данные. Это решение о способе проверки, а не автоматическое свойство копирования пайплайна.
Системный анализ остаётся, но сосредоточивается на границах эксперимента, общих зависимостях и изменяемом фрагменте.
Как выглядит работа над изменением
Вернёмся к пунктам выдачи.
Сначала я открываю пайплайн расчёта. Мне нужны входной запрос, выбор доступных способов, расчёт предложений и формирование ответа. Уведомления перевозчика пока не нужны.
Затем раскрываю фрагмент, который определяет доступность доставки. Смотрю, где он повторяется и какие функции общие. Если предварительный расчёт и оформление используют одну реализацию, это сразу становится частью задачи: нельзя проверить только один вход и забыть второй.
После этого читаю реализации нужных функций и тесты: какие размеры посылки допустимы и как обрабатываются ограничения перевозчика.
И только теперь появляется достаточно точное задание агенту:
Добавить доставку в пункт выдачи в сценарий расчёта.

Сохранить действующие правила курьерской доставки.
Использовать существующий адаптер перевозчика.
Различать недоступную доставку и технический отказ перевозчика.
Проверить предварительный расчёт и оформление заказа:
они используют общую функцию расчёта предложений.

Если потребуется изменить входной или выходной контракт,
сначала показать изменение модели и его потребителей.
Это всё ещё не полная спецификация бизнеса. Но агент уже не должен самостоятельно решать, нужен ли новый микросервис, можно ли заменить технический отказ пустым списком и какой из двух сценариев считать главным.
Если новое поведение укладывается в существующие типы и этапы, достаточно изменить реализацию и тесты.
Если изменились результат, маршрут обработки или существенные зависимости, меняется модель. Тогда полезно отдельно посмотреть архитектурный diff: какие узлы, типы и связи затронуты. Небольшой diff Python-фабрики может изменить сразу несколько конкретных фрагментов, поэтому одного просмотра исходника фабрики недостаточно.
После согласования модели можно обновить сгенерированную часть проекта, сохранив пользовательскую реализацию, и проверить уже работающий сервис. Например: допустимый пункт выдачи, недопустимые габариты, отказ API перевозчика и прежняя курьерская доставка.
Что здесь может делать агент
Агенту можно поручить создание начальной модели по описанию, поиск затронутых сценариев, изменение Python-объявлений, реализацию бизнес-функций и подготовку проверок. Он может помочь найти повторения, которые имеют смысл вынести в общую фабрику или обозначить компонентом.
Хорошо ограниченная задача для него: создать экспериментальный вариант существующего пайплайна, заменить одну функцию, сохранить остальные контракты и подготовить сравнение результатов. Тогда предмет ревью заранее понятен. Важно только проверить, что агент действительно отделил новую реализацию, а не поменял общую функцию под двумя разными названиями узлов.
Но структурно валидный граф ещё не обязательно полезный. Агент может аккуратно перенести каждую функцию исходного кода в отдельную ноду или, наоборот, оставить одну ноду HandleEverything. Оба результата способны пройти валидацию и при этом почти ничего не объяснять читателю. Выбор границ остаётся предметом инженерного ревью.
Отдельная опасность возникает при проверке реализации. Если задача звучит как «добейся успешной сборки», агент может убрать неудобную ветку или ослабить контракт, вместо того чтобы понять причину ошибки. Поэтому границы задачи должны описывать сохраняемое поведение, а не только команду, которая обязана завершиться с кодом ноль.
У инструментов здесь разные роли. Валидатор проверяет известные правила модели. Генератор воспроизводит техническую обвязку. Тесты проверяют выбранные сценарии. Человек оценивает, соответствует ли всё это задуманному процессу. Агент помогает на каждом шаге, но его объяснение не подменяет результат проверки.
Модель помогает задать агенту ограниченную, проверяемую задачу, но технически не запрещает менять код за её пределами. И свёрнутый блок в дизайнере сам по себе не сокращает контекст языковой модели. Агент должен работать избирательно: сначала получить нужный сценарий и его границы, затем запросить типы, зависимости и реализацию, а не читать весь репозиторий целиком.
Как пользоваться этим без второй документации
Хуже всего было бы получить ещё один источник истины, который нужно вручную поддерживать рядом с кодом.
В Python-проекте редактируемым источником архитектуры служат Python-объявления. Из них экспортируется модель для дизайнера и генератора. YAML в таком процессе является форматом обмена, а не вторым файлом, который нужно синхронно править руками.
Для проекта с настроенным manifest цикл выглядит так:
sa-dsl validate --project delivery_architecture
sa-dsl export --project delivery_architecture
sa-dsl generate --project delivery_architecture
Это команды проверки модели, экспорта и генерации, не проверки бизнес-корректности. Для генерации также нужны настроенные доступ к backend и целевые runtime.
Саму структуру можно рассматривать в дизайнере, а изменения хранить и обсуждать как обычный код. Если основным исходником выбран Python, его и нужно хранить в системе контроля версий. Изменённый в дизайнере YAML можно импортировать в новый Python-проект, но это восстановление модели, а не автоматическое внесение правок в наши прежние функции-фабрики. Такие изменения нужно отдельно согласовать с исходным Python-описанием.
У модели тоже есть граница достоверности. Она задаёт связи, которые строит генератор. Она не запрещает разработчику сделать дополнительный HTTP-вызов внутри бизнес-функции. Если этот вызов меняет существенную архитектурную зависимость, её нужно отразить в модели. Иначе даже исполняемый граф будет объяснять систему не полностью.
Когда граф действительно помогает
Мне кажется хорошим не тот граф, где отражено больше всего деталей, а тот, с которым проще внести конкретное изменение и проверить его последствия.
У маленькой ручки вполне может быть один вход и одна бизнес-функция. По мере роста системы хочется сохранить возможность начать с короткого описания сценария и раскрыть ровно столько подробностей, сколько нужно для изменения.
Речь не о том, что агент теперь «понимает всю систему». Мы даём ему явный архитектурный контекст и проверяемую задачу, вместо того чтобы заставлять каждый раз восстанавливать устройство сервиса по исходникам. Разработчику эта отправная точка нужна по той же причине. Модель не заменяет код, но помогает быстрее найти, что читать, менять и проверять.
В нашем примере результат довольно приземлённый: мы добавили новый способ доставки, понимаем, какие сценарии затронули, и можем объяснить, почему курьерская доставка должна продолжать работать как раньше. Ради этого и стоит возиться с моделью. Количество прямоугольников само по себе ничего не доказывает.
Материалы, с которых можно начать:
Автор: gorundebug