
Как мы тестируем автопилот для тракторов и комбайнов: HIL-стенды, симулятор на Unreal Engine 5 и реальное поле
Я руковожу отделом тестирования роботизированных систем в Cognitive Pilot. В этой статье расскажу, как устроено тестирование автопилота для сельхозтехники: какие уровни проверок у нас есть, чем они отличаются от обычного QA, что получилось и что пока не получается автоматизировать.
Как я пришёл в тестирование
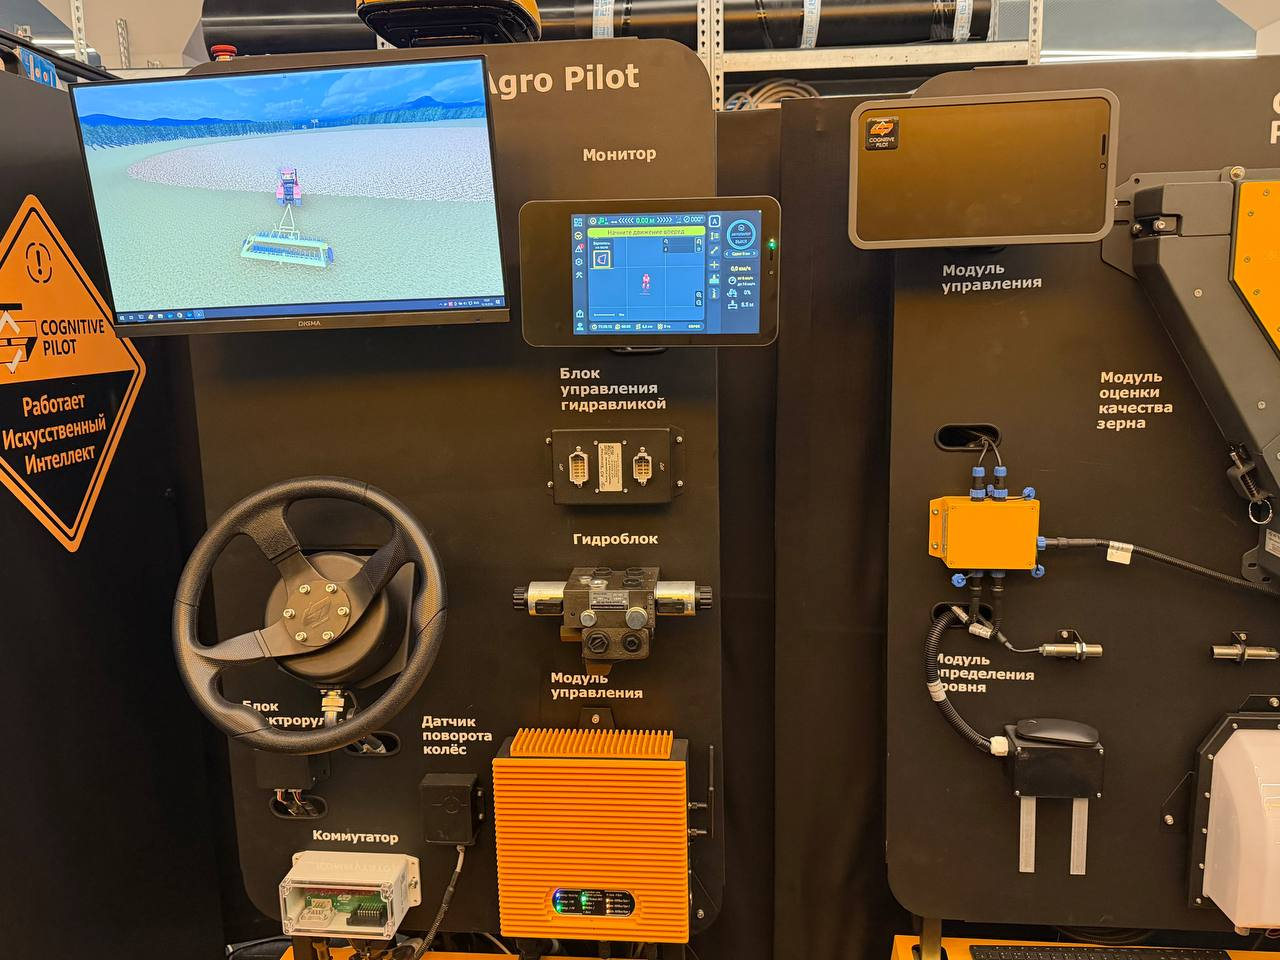
В компании работаю с 2020 года. Меня взяли ведущим геодезистом на железнодорожный проект, но в коллективе я начал перенимать навыки разработки и стал младшим инженером по автоматизации. Начинал не с классического тестирования, а с инструментов для разработки: HIL-стенда (Hardware-in-the-Loop) и эмуляторов CAN-протоколов для настройки исполнительных узлов (тормоз, сцепление, руль, свет). Пришлось проверять, что всё это работает вместе, и тестирование стало основной работой.
Сельхозтехника привлекла масштабом проекта и продуктовой линейкой. На Хабре прочитал о российской компании, у которой комбайны убирают урожай с помощью компьютерного зрения, и это сильно мотивировало. Здесь баг заметен не в логах, а в поле: трактор съехал с рядка, комбайн не остановился вовремя. Результат работы видно физически.
Чем это отличается от тестирования обычного софта
Нельзя просто откатиться. Ошибка проявляется в движении нескольких тонн металла, и исправить её задним числом не получится. Поэтому всё, что можно, мы проверяем до поля: на HIL-стенде с симулятором и на эмуляторах узлов.
Система — это бандл, а не одно приложение. В релиз входят планшетное приложение для механизатора, автопилот на вычислителе, CAN-сервисы, прошивки контроллеров актуаторов и веб-сервисы диагностики. У каждого компонента своя версия, и баг часто живёт на стыке двух из них.
Много конфигураций железа. Комбайн, трактор, минитрактор, трамвай. Разные вычислители, разные рулевые узлы (гидравлика через блок управления, электромоторы, Danfoss PVED-CL), планшеты на Android 7 и 10 с разным UI.
Реальное время и сенсоры. Важно не только «правильно ли», но и «вовремя ли»: частота кадров камер, ГНСС, IMU, время работы нейросети и планировщика.
Сезонность. Настоящее поле с урожаем бывает несколько месяцев в году, остальное время нужна убедительная замена.
Команда и процесс
В команде тестирования роботизированных систем три человека. Команда небольшая, но у каждого годы работы с подобными системами.
Работаем по Agile на канбан-доске и синхронизируемся со спринтами разработки. Как только задача переходит из «В разработке» в «Тестирование», мы берём её в работу. В комментариях либо подтверждаем, что всё работает, либо описываем шаги проверки и отмечаем, на каком шаге поведение не соответствует ТЗ.
Результат помечаем тегом прямо в комментарии: #qapass, #qafail, #qablock или #qaskip. Под это я написал небольшую утилиту, которая собирает статусы по каждому тестировщику и по сборке. Если задачу изменили после проверки (например, перенесли в другой спринт), статус становится «Expired», и её нужно перепроверить. Та же утилита сравнивает версии пакетов внутри бандлов и показывает, какие компоненты изменились, то есть что именно перетестировать.
Процесс мы сознательно держим простым: всё общение с разработчиком идёт в привычной ему Jira, без лишних инструментов и согласований. Так удобнее договариваться, и задачи закрываются быстрее.
Тест-кейсы ведём в Testy (open-source TMS от YADRO). Ручные кейсы и автотесты живут в одной системе, результаты автопрогона пишутся туда же по API.
Уровни тестирования
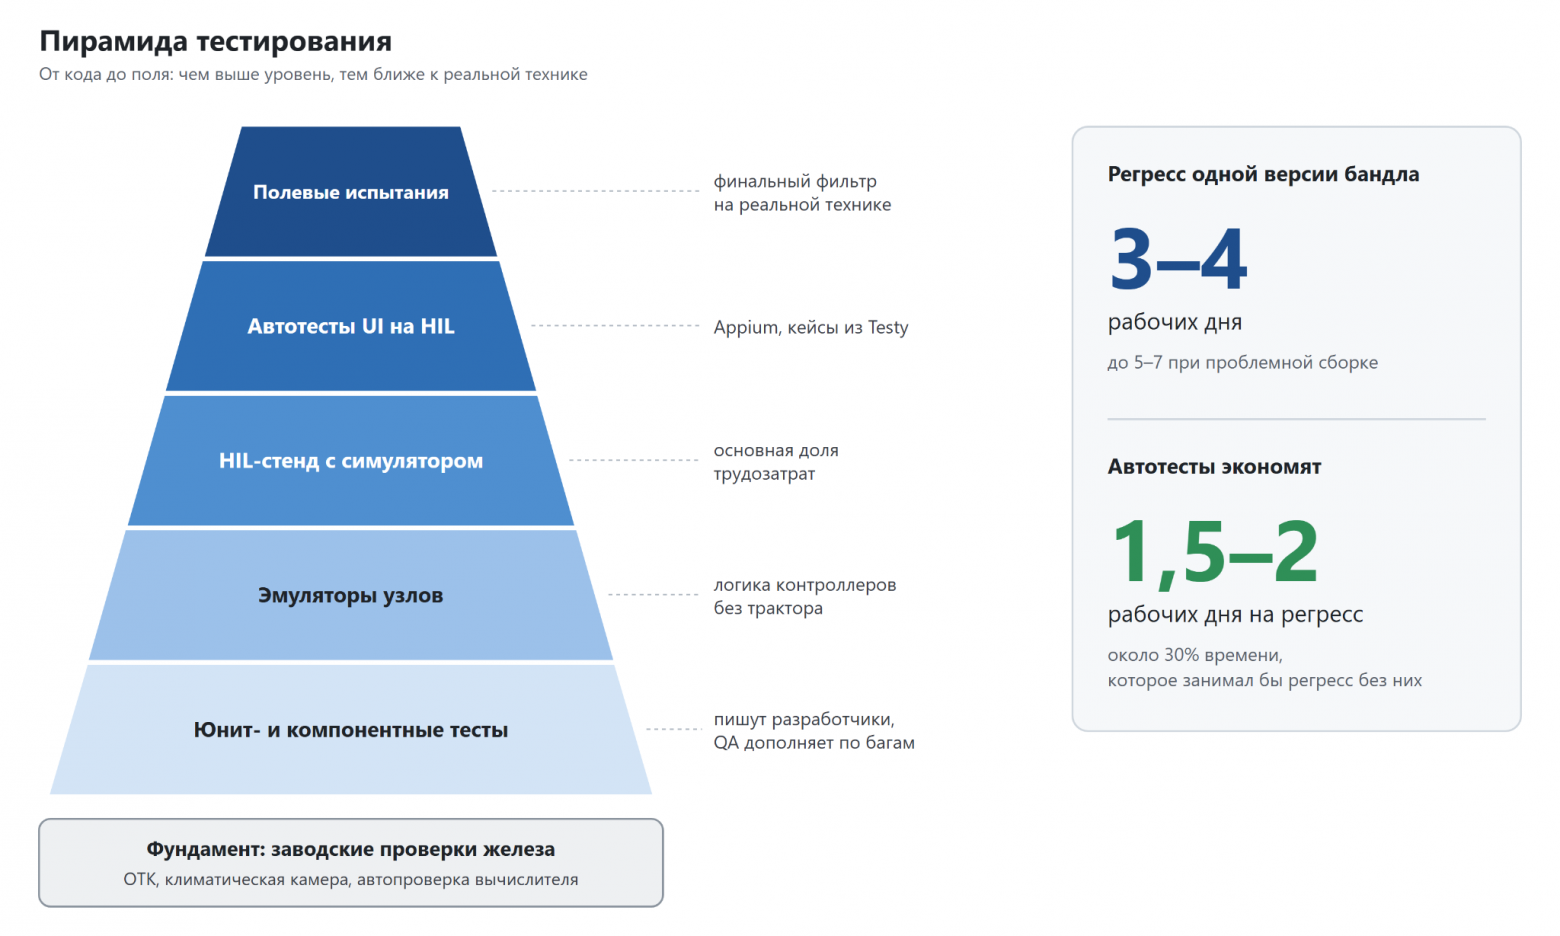
Если идти снизу вверх:
-
Юнит- и компонентные тесты. Их пишут разработчики. QA по найденным багам может их дополнять и увеличивать покрытие.
-
Эмуляторы отдельных узлов. Настольные эмуляторы общаются с вычислителем по тем же протоколам, что и реальный блок, и позволяют выставить любое состояние узла. Логику можно проверять без трактора.
-
HIL-стенд с симулятором. Основной интеграционный уровень: реальный вычислитель, реальные актуаторы и планшет, а вместо трактора, комбайна, минитрактора или трамвая работает симулятор.
-
Автотесты UI на HIL. Ручные кейсы из Testy автоматизированы на Appium. Прогон одного кейса занимает от минуты до 25 минут, потому что многие проверяют реальный проезд по полю в симуляции.
-
Полевые испытания. Последний этап — регресс на реальной технике. День выезда мы выбираем не по хорошему прогнозу погоды: чем жёстче условия, тем объективнее результат. Зимой тоже выезжаем, хотя условия мало похожи на основной сезон. Уборка по первому снегу бывает, и система с ней справляется.
По трудозатратам основная часть приходится на HIL-стенды: там идут и ручные проверки, и автотесты. Полевые испытания меньше по объёму, но это финальный фильтр перед релизом.
По времени полный регресс одной версии бандла занимает 3–4 рабочих дня, а если сборка проблемная, то 5–7. Автотесты уже экономят на каждом регрессе 1,5–2 рабочих дня. Это около 30% времени, которое занял бы регресс без них, и доля растёт с каждым автоматизированным кейсом.
Контроль качества начинается до стенда
Тестирование начинается не с деплоя бандла, а с производства. За качество выходной продукции отвечает ОТК: продукция должна соответствовать ГОСТам, техническим условиям и конструкторской документации. Все платы и сенсоры проверяются на отказоустойчивость в климатической камере в диапазоне от −45 до +70 °C.
Затем каждый вычислительный блок перед установкой проходит автопроверку: CAN-шины, камеры, приёмники, накопители, запущенное ПО, производительность обработчиков и FPS всех сенсоров на записи. Сводный отчёт по каждому блоку сохраняется в общую таблицу.
Симулятор: от Farming Simulator 19 до собственного на UE5
История у него забавная. Первая версия HIL-стенда работала с Farming Simulator 19: техникой и орудиями мы управляли через самописный мод на Lua. Но это игра со своими ограничениями, и в итоге они привели нас к разработке собственного симулятора, тем более что как раз вышел Unreal Engine 5. Сейчас основной симулятор собственный, на UE5, а FS19 остался в тёплых воспоминаниях (за несколько лет мы так и не прошли в нём ни одной миссии).
Поля строим на сплайнах: кромка поля, техколея, маркер разметки. Можно выбрать технику по типу кинематики, культуру и тип жатки или орудия, переключить поле между «рядками» и «стернёй». Для каждой техники своя сцена. Для трамвая, например, есть карта на основе OpenStreetMap: она генерирует любой трамвайный маршрут Санкт-Петербурга со светофорами, перекрёстками и остановками и наполняет его транспортом и пешеходами.
Препятствия — машины и люди, статичные или движущиеся по траектории. Их можно вызывать и убирать с фронта стенда прямо во время теста.
Освещение настраивается на любое время суток, от рассвета до глубокой ночи.
Где симуляция расходится с реальностью
Какой бы хорошей она ни была, это синтетика. Сильнее всего расходятся физика и сенсоры. Поэтому мы подмешиваем в навигацию шум с разной дисперсией под режимы ГНСС, так же зашумляем данные IMU и лидаров, а гидравлику руля моделируем отдельно. Кривые руления из логов строим и сравниваем на графиках.
Картинка из симулятора идеальная: без дисторсии объектива, без шумов, с упрощённой сценой. Поэтому зрение окончательно проверяется только в поле. Параметры калибровки реальных камер к такой картинке не подходят, и автокалибровку на стенде мы не считаем показательной. Пробовали направлять реальные камеры Rvision на монитор, но результат плохой: они видят плоский экран вместо объёмной сцены, а мешают ещё контраст и автоэкспозиция.
Что в стенде настоящее
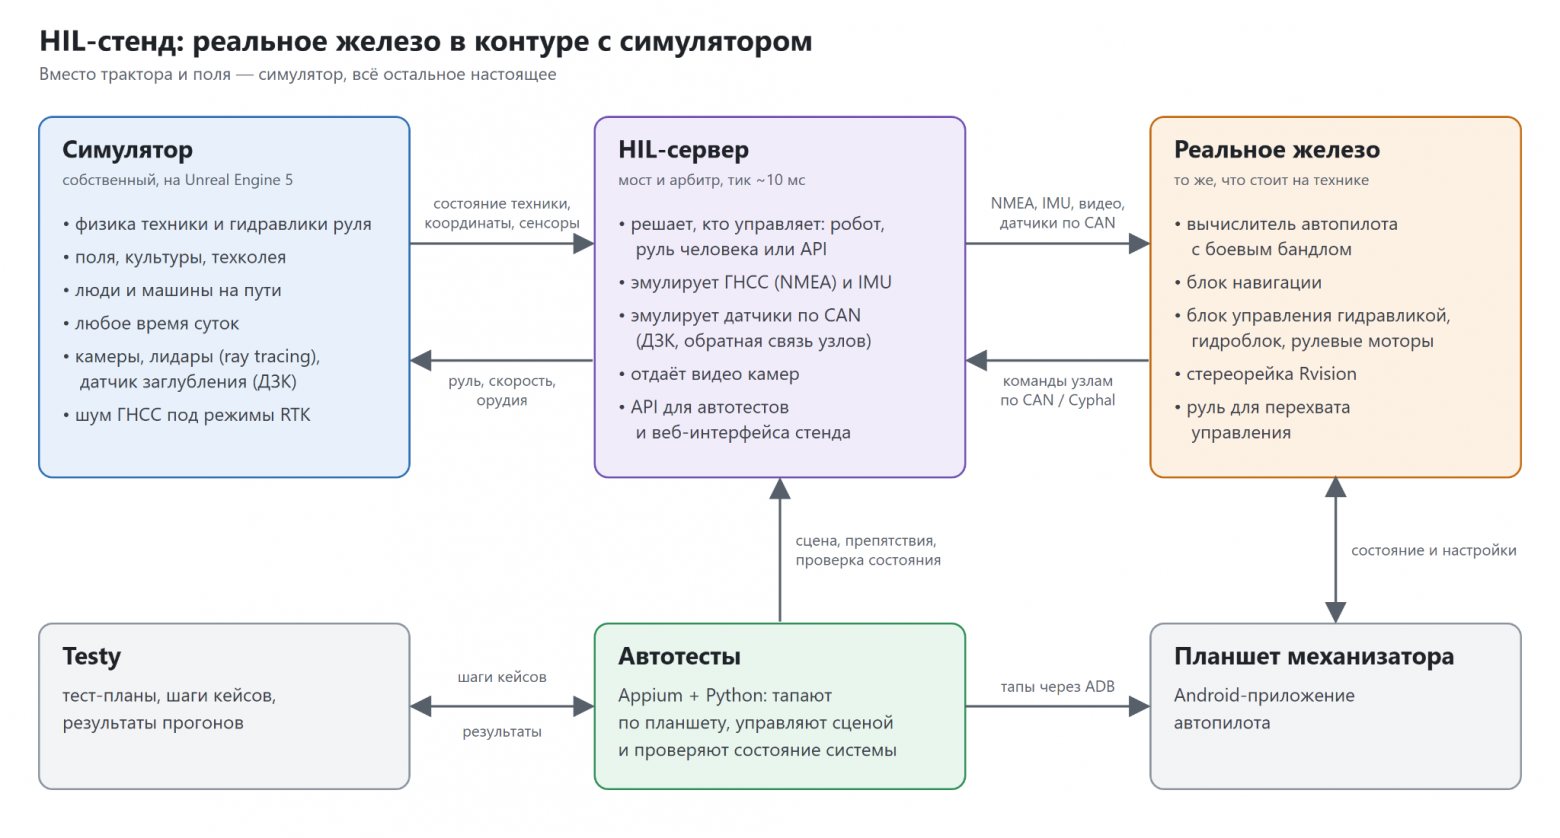
У нас около десятка однотипных HIL-стендов, код стенда автоматически раскатывается на них из CI. На каждом реальное:
-
вычислитель автопилота под конкретный продукт с боевым бандлом;
-
блок навигации, получающий NMEA-сообщения и сырые данные IMU;
-
исполнительные узлы (блок управления гидравликой, гидроблок, рулевые моторы) на CAN-шине;
-
стереорейка с камерами Rvision;
-
Android-планшет с приложением.
Лидары в контуре есть, но симулированные: данные строятся трассировкой лучей по сцене симулятора. Датчик заглубления и комковатости (ДЗК) симулируется полностью: показания берём из симулятора и отдаём в вычислитель по штатному CAN-протоколу.
Сервер стенда работает как мост и арбитр. На каждом тике (около 10 мс) он решает, кто сейчас управляет рулём и скоростью (робот, физический руль или API), и передаёт это в симулятор. Так можно проверить и автопилот, и перехват управления человеком.
SIL (софт и симулятор без реального железа) мы используем только в разработке. Для приёмки он не годится: без настоящих вычислителя и актуаторов честного результата такие тесты не дают.
CI/CD: честно о том, чего пока нет
В CI разработки мы пока не встроены. У разработчиков свой пайплайн с юнит-тестами на каждый коммит. Мы подключаемся позже, на собранном бандле: проверяем его на HIL-стендах и в поле, а найденные баги возвращаем в разработку. Часть из них после исправления закрепляется юнит-тестами.
Сквозной пайплайн «коммит → регресс на HIL» — наша следующая цель. Мешают две вещи: HIL-прогоны требуют железа и идут долго, а такой пайплайн нужно стабилизировать и постоянно поддерживать, и это работа для отдельного человека, которого в команде из трёх пока нет.
Для собственных инструментов CI есть. При мерже в master линтер и сборка фронта стенда работают как гейт, а сервер и фронт автоматически раскатываются на все HIL-стенды. Сервер публикует OpenAPI/AsyncAPI-схемы, из которых генерируются типы для фронта и автотестов, так что изменение API стенда видно сразу.
Перед релизом бандл проходит регрессионный план в Testy на HIL-стендах, заводские проверки вычислителя и ручные кейсы по измененным компонентам, а затем полевые испытания.
Что проверяет системный QA в части зрения и ML
Метрики качества самих моделей — зона ML-команды. Со стороны системного QA мы проверяем три вещи.
-
Поведение, а не модель. Например, кейс «Режим проезда по зрению — Кромка»: трактор на HIL должен пройти вдоль кромки поля. Нас интересует итоговая траектория и реакция интерфейса.
-
Производительность на целевом железе. Время обработки мультизадачной нейросети, навигатора, планировщика и оценки позы проверяем по допускам для каждой платформы. Если новая модель точнее, но не влезает в бюджет, это регресс.
-
Калибровка камер. Если камера откалибрована плохо, качество модели не важно. Под это есть отдельный инструмент: моно- и стереокалибровка по шахматке с жесткими критериями отбора кадров (минимум 75 удачных кадров, шахматка должна покрыть около 70% площади кадра, есть требования к углам наклона). Плохие кадры сохраняются для разбора, результат уходит в хранилище.
Как ловим регрессии
Сначала фиксируем, что именно поменялось: утилита сравнения бандлов показывает версии всех компонентов. Метрики производительности снимаем по каждому бандлу и складываем в облачное хранилище, так что выход обработчика из допуска виден сразу. Сценарии на HIL воспроизводимы: та же карта, сцена, сплайны и препятствия, поэтому одно и то же поведение можно сравнить на двух версиях.
Нештатные ситуации
Симулятор позволяет собрать то, что в поле ловить долго или опасно: человек выходит наперерез, машина на пути, нестандартная геометрия поля, смена типа поля и культуры. Второй инструмент — эмуляторы и арбитраж на стенде. Ими мы искусственно ломаем вход системы: другое состояние исполнительного узла, плохой ГНСС, внезапный перехват руля человеком.
Отказы и граничные случаи
ГНСС. Потерю спутников в симуляции воспроизвести несложно, и такие тесты мы проводим. Система должна немедленно отдать управление механизатору, потому что без спутников локализация вскоре развалится. Исключение — режим езды по зрению без спутников: в нём система продолжает работать штатно. Кроме того, на стенде мы переключаем режимы решения RTK с соответствующим шумом координат, скорости и курса. Отдельно автоматизированы кейсы по всем источникам поправок RTK: LoRa, RS-232, NTRIP через мобильную связь.
Отказ датчика. Система мониторинга публикует коды ошибок, например «Ошибка датчика рулевого колеса, показания некорректны». Мы проверяем, что ошибка доходит до механизатора понятным текстом.
Пыль, низкое солнце, туман, ночь. Погода — настоящая проблема. На ранних этапах разработки бывало, что низкое солнце слепило камеры и технику разворачивало на месте прямо во время уборки. Это опасно и бьет по репутации. Ситуацию изменил переход на камеры Rvision, которые поставляются в составе Cognitive Agro Pilot: они дают более гибкую настройку сенсора, и с засветкой от низкого солнца мы теперь справляемся.
Деградация и безопасная остановка
У каждого исполнительного узла есть явная машина состояний, а на низком уровне отдельное состояние аварийной остановки. С помощью эмуляторов мы переводим узел в любое из них и смотрим, как реагирует автопилот и что видит механизатор. На уровне вычислителя заводской тест проверяет флаги связи с исполнительными узлами, наличие обратной связи по скорости, работу сервиса мониторинга и авто-перезапуска контейнеров.
Если хотя бы один сенсор неисправен, автопилот не включится до устранения неисправности. Если сенсор отказывает во время работы, управление немедленно передаётся механизатору, на планшете появляется уведомление, а при наличии сети сообщение уходит ещё и в облачный сервис.
Задержки
Мы меряем их по звеньям цепочки:
-
Сенсоры: на записи телеметрии проверяем, что частота каждого источника укладывается в допустимый коридор для своего типа датчика.
-
Решение: автопилот пишет тикер-логи, то есть время каждого обработчика (нейросеть, навигатор, оценка позы, главный цикл планировщика). Мы парсим их и сравниваем с допусками для платформы и продукта.
-
Исполнительный механизм: для руля есть параметр времени поворота «от упора до упора», а контур симуляции на стенде крутится с тиком около 10 мс, чтобы самим не вносить заметную задержку.
Сквозную задержку «сенсор → актуатор» в основном пайплайне мы отдельно не меряем, а контролируем каждое звено. Целиком её замеряем точечно, когда разбираем специфичные баги, связанные с железом.
Что для нас критичный баг и кто решает о выпуске
Критичный баг — тот, что влияет на управление движением или остановки. Сюда же я отношу баги, которые вводят механизатора в заблуждение. Реальный пример: на экране настроек автопилота при включённом Light-режиме изменения «Полное управление / Остановка» молча не применялись. Пользователь думает, что настроил, а система работает по-старому.
Решение о выпуске принимают руководитель проекта и руководитель QA. Мы на выходе даём сводку по бандлу: статусы всех задач, результаты регрессионного плана и заводских проверок.
Путь от требования к тесту у нас такой: требование превращается в ручной кейс в Testy с шагами и ожидаемым результатом, затем кейс автоматизируется на HIL. Шаги автотеста один в один привязаны к шагам кейса, поэтому в отчёте видно, какой именно шаг требования не выполнен.
Поле
Свой полигон у нас в Хотьково. Если нужна специфичная техника или особые контролируемые условия, нас пускают к себе предприятия, например «Гомсельмаш» из Беларуси или ПТЗ из Санкт-Петербурга. Зимой идёт активная разработка к новому сезону, и тестирование в основном переезжает на HIL-стенды. Обратная связь от механизаторов приходит в основном через службу техподдержки, а внутри команды мы тесно взаимодействуем, чтобы быстрее разбирать граничные случаи.
С вычислителя мы забираем тикер-логи, навигационные логи, логи руления (из них строим интерактивные графики) и записи телеметрии, то есть синхронную запись всех сенсоров: CAN машины, IMU, ГНСС, камеры и другие. Состояние системы и настройки лежат в Redis, и на стенде автотесты проверяют его напрямую, а не только по экрану. Собранные данные можно проиграть офлайн, найти причину проблемы и воспроизвести её на HIL-стенде.
Два любимых бага
Список полей, который «забывал» выбор. Мой любимый пример нашла автоматизация. Тесты выбора поля в приложении стабильно падали: тест выбирает поле, сохраняет, а потом оказывается выбрано старое. Сначала я, конечно, подозревал свой автотест.
Разбирали пошагово. Сразу после тапа строка честно получает selected=true, через секунду тоже. Но стоит прокрутить список, и выделение «откатывается» на прежнее поле, будто тапа не было. Гипотеза была про классическую ошибку RecyclerView: выделение ставится на конкретную view, а не в модель. Разработчики подтвердили и уточнили механизм: если список уже в крайнем верхнем положении и по нему делают еще один свайп, выбранное поле слетает. И это не косметика: после «Сохранить» трактор действительно работает со старым полем.
Человек такое ловит редко: он не свайпает вверх список, уже прокрученный до верха. А автотест для надежности всегда проходит список от верха до низа.
Кнопка «Перезагрузить модем». Тест подписывается на Redis-канал команд до клика и видит, что команда действительно уходит. Но статус перезагрузки ни разу не менялся, а связь не прерывалась: команда отправлена, а реакции на неё нет. Без подписки на канал мы бы долго выясняли, на чьей стороне проблема.
Что не удается автоматизировать
-
Поле. Реальная пыль, солнце, грязь и реакция механизатора.
-
Визуальная оценка. Сравнение скриншотов мы сознательно не делаем: экран живой (карта, камера, индикаторы), и такие тесты были бы хрупкими. Тексты и иконки проверяем точечно.
-
Сценарии, требующие реального железа. Например, подключение физических приемников поправок: получать поправки мы можем, но синхронизировать их с симуляцией не получается.
-
Длинные кейсы. Технически автоматизированы, но не дешевы: отдельные идут до 25 минут.
Чего не стоит повторять
Не откладывать реальную технику на конец релиза, но и не выезжать без смоков. Выезд в поле лучше планировать сразу после того, как бандл прошёл смок-тесты регресса на стенде: тогда оценка рисков не упирается в дедлайн. У нас был показательный случай: выпустили RC-версию, в которой никто не сомневался, и поехали в поле. На месте оказалось, что не проходит половина смок-тестов. Итог — день, потраченный впустую, хотя на стенде это обнаружилось бы за полчаса.
Не хардкодить в автотестах. Переходы между экранами UI у нас строит граф с поиском пути (BFS), а локаторы описаны моделями. Когда меняется меню, правим одно место, а не все тесты.
Возвращать стенд в исходное состояние. Тест, оставивший настройку изменённой, может уронить следующие тесты. Особенно больно, если вернуть значение через UI мешает тот самый баг, который тест нашёл.
Разделять баги автоматизации и баги продукта. Подозрение на баг приложения записываем с шагами воспроизведения, стендом и версией и отдаём разработке только после ручной проверки.
Автоматизировать по одному кейсу и до конца. Если накидать в план пачку недоотлаженных тестов, получится шумный красный отчёт.
Не доверять симулятору безоговорочно и всегда фиксировать версию всего бандла, а не одного компонента.
Инструменты, которые я бы порекомендовал
-
Testy — open-source TMS с удобным API. Ручные кейсы и автотесты в одной системе, шаги автотеста привязаны к шагам кейса.
-
Appium + UiAutomator2, а рядом небольшой сервис в Docker, который следит за ADB-подключением планшетов и переподключает их. Без этого ночные прогоны падают на ровном месте.
-
python-can + cantools + DBC-файлы, pycyphal для Cyphal/UAVCAN. Эмуляторы узлов на Qt пишутся за несколько дней и окупаются сразу.
-
Свой API к стенду (FastAPI + WebSocket) с генерацией OpenAPI/AsyncAPI-схем. Из них автоматически получаются типизированные клиенты для фронта и тестов.
-
Проверка состояния не только через UI, но и через бэкенд: тест видит, что настройка действительно применилась.
Вместо итога
Главный урок за эти годы: в системе, которая управляет тяжёлой техникой, тестирование держится на нескольких слоях, и ни один из них не заменяет другой. Эмуляторы дают скорость, HIL-стенд честную интеграцию, симулятор недоступные в поле сценарии, а поле остаётся финальным судьёй. Наша ближайшая цель — довести цепочку «коммит → регресс на HIL» до автоматического пайплайна.
Автор: airzat