
Тёплый ламповый агент
Так уж сложилось, что я пролетел мимо агентных систем напрочь. Я решил, что стоит восполнить этот пробел и наверстать упущенное. Чем меньше понимание — тем больше аппетит, поэтому я решил вслепую начать с амбициозной задачи — передать разработку проекта на управление агентам. Мой пыл немножко подостыл в процессе работы и я хочу поделиться первыми результатами, возможно, вы мне поможете указать на мою слепую зону или начнёте пользоваться агентами, если ещё не начали :)
Философия применения
В повседневной работе я использую LLM для написания коротких участков кода: там, где можно чётко изолировать вход и выход, но честно скажу, даже здесь возникают проблемы, моя первая попытка довериться результату без проверки привела к примерно 4 часам человеческих затрат на функцию «Разбить период на чанки». Я был крайне разочарован: люди комитят в ядро линукса сгенерированный код, создают целые проекты, а я сломался на простой функции. Тогда я вернул LLM статус «инструмент облегчения поиска» а сам вернулся к догмату «думать всё равно придётся».
Прошло несколько месяцев, я успешно использовал LLM в автоматизации, но к генерации кода так и не подошёл. Я строю свою работу на том, что главное в разработке — это трансформация бизнес-координат в алгоритмические, само написание кода — это та рутина, которая помогает расслабиться и разгрузить голову: здесь знакомые инструменты, родные проблемы и абсолютная гарантия результата. Получается, агент разработки не снимает с меня проблем, а только убирает ту часть, где я отдыхаю, меня это не очень радует. Поэтому я решил, что место LLM в моём пайплайне решения задач — это как раз та часть, где координаты вырождаются: на этапе трансформации бизнес-требований в архитектурные.
Самое дорогое в выполнении задачи — это узнать, что решение было основано на неправильных убеждениях, это конвертирует стоимость всех предыдущих этапов в стоимость поиска ошибки, увеличивает стоимость достижения результата привнесением когнитивных искажений между участниками и что самое важное — отправляет наше время в трубу. Для больших команд с небольшим вкладом каждого это приемлемо, для продуктивных команд с небольшим количеством участников это очень дорого.
Агент — это LLM с возможностью что-то делать, я решил отнестись к нему как к сотруднику — должны быть описаны компетенции и ожидания результата деятельности, раньше я называл это должностная инструкция, теперь — ТЗ на разработку агента. Тут небольшое отступление про целесообразность: устранение возврата задачи на разработку не имеет прозрачности на уровне трекера, «Кажется, с этой задачей какая-то проблема» — наше ощущение, которое возникает, когда мы достаточно часто слышим о какой-то части системы. Переложить этот сигнал в измеримую метрику — это значит доверить все наши входящие шумы системе, которая будет нашей чуйкой. Или придумать модель, которая проанализирует значимые для нашей чуйки артефакты: бизнес-приоритеты, настроения сотрудников, артефакты разработки, события в трекере. Для меня это всё далеко, я хочу проверить применимость инструмента и сделать практическую реализацию не зависящую от «настроения» LLM в день работы, установив дедлайн в две недели я принялся за работу.
Техничка
Я написал около 3000 строк кода на нелюбимом мною python, на написание основного функционала у меня ушёл один полноценный вечер, а дальше работа велась в фоне: один день ушёл на отладку без вовлечения команды, один день на тестирование взаимодействия с участниками проекта и один день на выпуск в продакшен. Вышло что-то среднее между агентом и автоматизацией, но результат впечатлил всю команду, я остался доволен и считаю эксперимент успешным.
CHANGELOG.md
Я не знаю, почему я веду changelog снизу вверх
2026-09-21
-
Now comments are directed to team members in a language they can read
-
Comments used for context are filtered from TriageAgent to avoid hallucinations
-
Fixed missing ambiguous comment
2026-09-20
-
Each agent has a Model for both input and output
-
Implemented base class for Model that provides abstract render_dbg function (allows printing debug info in console) and to_prompt_text that allows to summarize a model for prompting
-
Model was renamed to Contract as it best represents the future usage
-
IssueReader renamed to IssueTriage since it creates a step sequence for solution
-
IssueTriage can now post comments to clarify requirements and ask for missing agent skills
2026-09-19
-
Created an agent that can accept YouTrack™ task ID, read an issue, create a context for a task (body, comments, image attachments) and decompose it for implementing
-
[missing] extract the decomposition because its manner depends on the task context (i.e. backend-dev, frontend-dev, seller, marketing, ad, design, …) so an issue_reader agent should listen for undelivered tasks, create a context and delegate the decomposition to a specific agent. If there is no agent that can do this work — add comment that it cannot be resolved until an appropriate agent is created, assign a task to admin and change status to «To Be Discussed». There should be an agent that has information about all the rest of agents and can provide the information, who can do that task and how (in case of confusion — ask the others agents if they can do the task). As this architecture is a highly future-oriented automation, it is enough to have just a registry of agents and omit the conversation between the issue reader and the other agents. [adopted restrictions] agents work in the context of a single project, which is zArch (issues ARCH-*) so:
-
the project is defined, the .yaml exists
-
agent list is known, agents can ask each other
-
Суть заключается в следующем: агент IssueTriage принимает по FastAPI id задачи. Далее формирует контекст: используя YoutrackMCP скачивает себе содержимое задачи, изображения и комментарии. Следующий шаг — взаимодействие с LLM агент изучает возможность выполнения задачи (в описании проекта текущая команда с ролями), если в текущих обстоятельствах задачу реализовать не получится, то он оставит комментарий с определённым маркером не видимым пользователю, но human-readable (человекопонятным?) содержанием.
Далее — проверка на двусмысленность: если в задаче есть двучтения — он добавляет комментарий с возможными вариантами двучтения и вопросом, адресованным члену команды
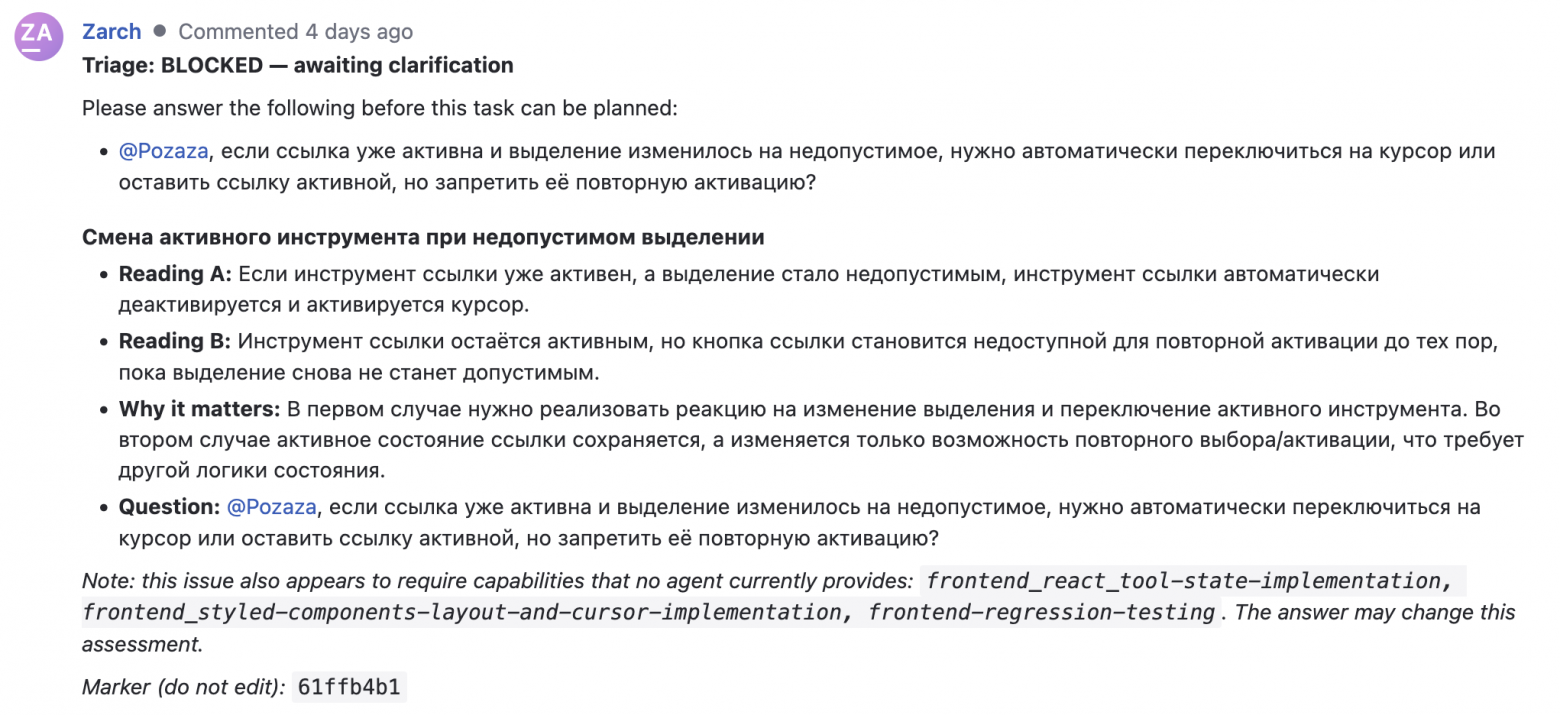
Непосредственно в трекере участник команды отвечает агенту, агент заново просматривает весь текст, собирает контекст и производит те же проверки, что и ранее. Один комментарий — один вопрос. Простой ответ, который мы воспринимаем «на вайбе» для LLM не прокатил, он теряется в потоке, поэтому ответ должен быть слегка развёрнутым.
Агенту нужно явно указать, на каком языке общаться, промпты на английском работают лучше русского, поэтому и ответ иногда вылезает на английском. Добавил в конфиг на каком языке можно разговаривать с каждым участником. По сути, это могла быть память, но я собираю скоп, который можно заранее забить конфигом, на мой взгляд, это быстрее/выше/сильнее, чем итерациями вытягивать это для каждого проекта.
Это интересно! Культурная особенность: в России ответ в одно слово воспринимается как норма. Если ответить носителю испанского языка одним словом — он подумает что ты его не понял и повторит вопрос, в испанской культуре ответ на вопрос включает в себя часть вопроса, в русском языке такой привычки нет, поэтому с точки зрения LLM испанцы более удачные собеседники. В моём случае ребята сами подхватили, что нужно развернуть ответ, когда он продублировал вопрос в другой формулировке.
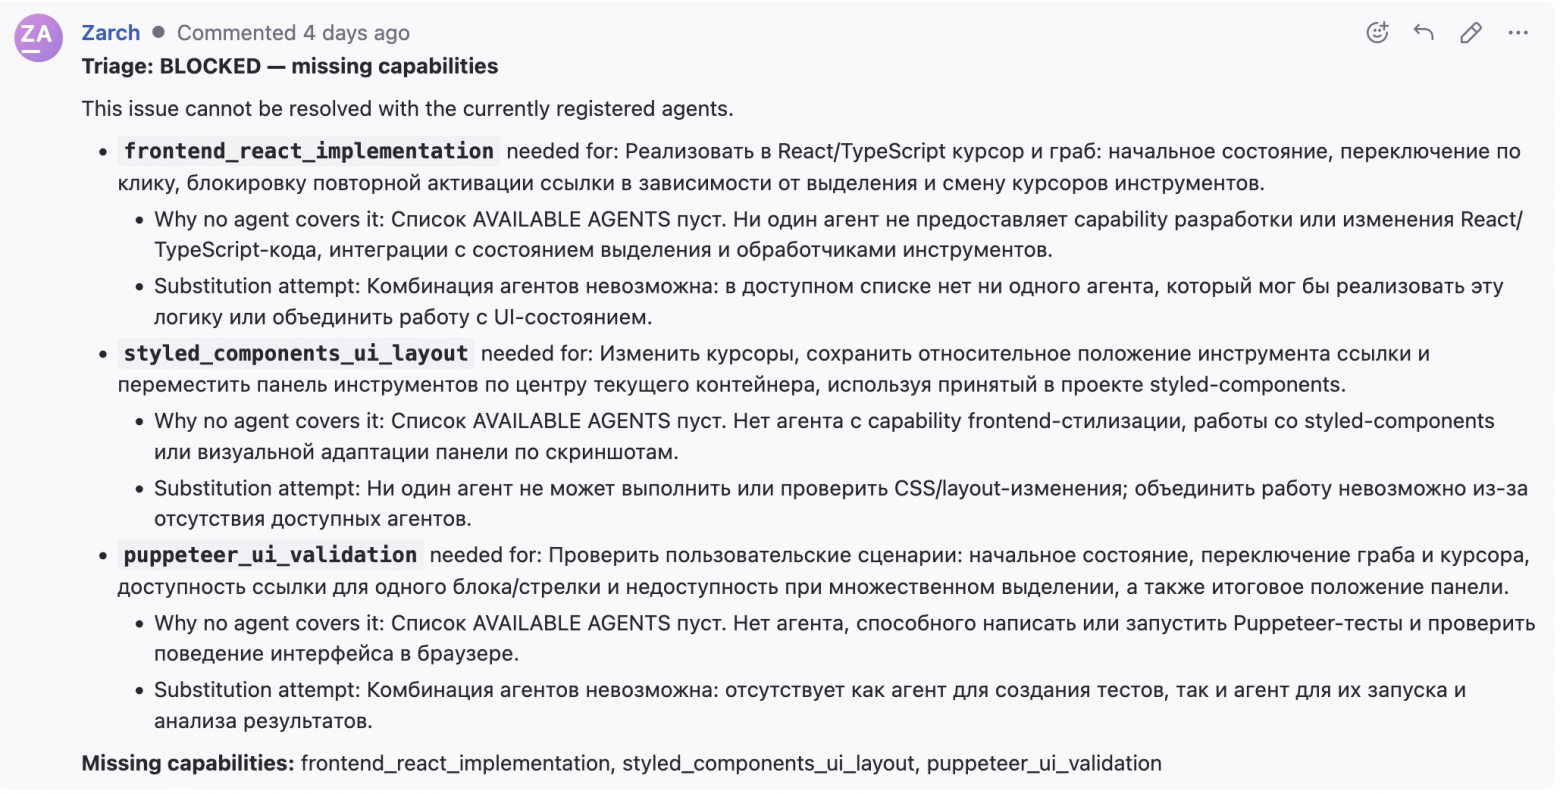
Я заложил, что задачи будут выполнять агенты, они должны быть зарегистрированы в реестре доступных, если доступных агентов нет — задача эскалируется на невозможность выполнения, это лишь для демонстрации возможности и сохранения работы в рамках будущего флоу
Интеграция
K8s у меня нет, я разворачиваю простые внутренние сервисы не всегда даже в Docker, но сейчас есть несколько задач контейнеризации питон-приложений. Сервис размещён во внутреннем контуре, обращение по ID задачи идемпотентно (это я закладывал на уровне требований), если исполнитель задачи — не агент, то задача игнорируется, поэтому адрес просто открыт во внутреннюю сеть, а вызов происходит по автоматизации workflow в youtrack. Креды OpenAI кладутся через vault, в настройках OpenAI есть простановка лимитов и lifetime, плюс ротация — отсюда относительно недорогая стоимость утечки api_key. Для агента создан отдельный аккаунт в youtrack, доступ к задачам на уровне разделения прав. Пока не планирую создавать отдельные аккаунты под разных агентов, т.к. скорость их участия не сильно аффектит скорость команды.
Цена
Локального железа у меня нет, есть только очень слабые модели, поэтому я использовал API openai/deepseek с последними моделями. На тестирование и отладку у меня ушло около 30 центов в OpenAI, часть промптов я тестировал через бесплатный веб-интерфейс. Возможности проверить на открытых моделях у меня нет. Стоимость обработки небольшой задачи, к которой прикреплены несколько изображений (3x15kb, 75kb) была на уровне одного цента.
Для ограничения бюджета применяется техника ограничения контекста при вызове промпта, мне это не очень нравится: контекст обрезался и мы получли ответ, который основан на обрывке фразы, мы об этом не узнали, поэтому я сторонюсь решения блокировать вызов, если он не поместился, но алертинг по отдельному каналу, комментарии не резиновые.
Холодный транзисторный
Сейчас агент — это декларация возможностей (skills), использование протоколов коммуникации (MCP). Есть готовая база агентов, можно скачать и использовать (для использования в РФ необходимо обходить ограничения), количество навыков, которые у них есть поражает. Общение с агентом происходит через обычный человечный язык в окне промпта, есть много разных готовых систем.
Я создал своего агента так, что бы он встроился в наши процессы и был помощником, видимо, мои предпочтения в развитии людей наконец встретились с интересами развития технологий, на текущий момент я вижу применение LLM в точности так, как его описывает название — язык. Пока инструменты разработки выигрывают в стоимости, использовать LLM в лоб — это будущее, но оно не решает проблемы сегодня.
Автор: za-ek2