
Тень стратега (2): Постановка цели
Продолжение. Первую часть можно прочитать здесь.
В первой части мы пришли к тому, что AI-агент — это не замена человеку, а его тень. Тень живёт своей жизнью, работает непрерывно, но не эволюционирует без стратега. Однако когда мы переходим от философии к внедрению AI-агентов в реальные Enterprise-процессы (в частности, опираясь на концепции из Whitepaper Сбера «AI-Disrupt PDLC», подробнее), мы сталкиваемся с реальностью.
Как загрузить качественным топливом конвейер разработки? Как измерить эффективность симбиоза человека и машины? И, главное, как не дать нейросетям превратить архитектуру системы в хаос из-за их врождённого желания «угодить» пользователю?
Сущность Стратега
Стратег — это абстрактная роль человека (или инкапсулированной сущности «человек + агенты»), который владеет концепцией, процессом или предметной областью на своём уровне и видит её целиком. Стратег определяет критерии «правильного», верифицирует результаты работы агентов и управляет эволюцией профиля знаний. Стратег инкапсулирован: наблюдаемы только вход и артефакт. Неважно, кто произвёл артефакт — человек или агент. Иерархия стратегов обеспечивает согласованность решений. Цель концепции — освободить стратегов от рутины, чтобы они успевали выполнять свою роль.
Что делает Стратега Стратегом
|
Признак |
Пояснение |
|---|---|
|
Владеет концепцией |
Держит в голове целостную картину: продукт, домен, процесс, стандарты |
|
Видит целиком |
Понимает, как части связаны между собой, и куда всё движется |
|
Определяет «правильное» |
Формулирует критерии: что такое хорошо, что такое плохо |
|
Режет углы |
Там, где агент будет «явно размышлять», стратег действует по интуиции |
|
Обучает агентов |
Передаёт своё видение в профиль агента |
|
Верифицирует |
Проверяет результаты работы агентов на соответствие концепции |
|
Управляет эволюцией |
Обновляет профиль знаний по мере развития продукта |
Что Стратег не делает
|
Не делает |
Почему |
|---|---|
|
Не пишет требования сам |
Это работа агентов и аналитиков |
|
Не пишет код |
Это работа Tiny Teams |
|
Не занимается рутиной |
Рутина делегируется агентам |
|
Не заменяется агентом |
Агент — тень, а не источник |
|
Не обязан иметь агентов |
Инкапсуляция: важен артефакт, а не инструмент |
Принцип инкапсуляции
Стратег инкапсулирован с агентами. Важен только артефакт. Неважно, кто его поставит — агент или человек.
Это ключевой принцип.
Следствия
|
Следствие |
Пояснение |
|---|---|
|
Не нужно описывать внутреннее устройство |
Достаточно входа и артефакта |
|
Неважно, есть ли агенты |
Если артефакт соответствует — всё хорошо |
|
Модульность |
Стратеги соединяются через артефакты |
|
Гибкость |
Агенты добавляются итеративно |
|
Снижение bus factor |
Профиль сохраняется в Confluence |
Стратег делегирует рутину агентам, оставляя себе только то, что требует человеческого суждения.
Задача концепции — освободить стратега от рутины, чтобы он успевал выполнять свою стратегическую роль. Не заменить его, а усилить.
Общая схема производственного процесса
Производственный процесс Tiny Teams из Whitepaper Сбера «AI-Disrupt PDLC» упрощённо выглядит следующим образом.
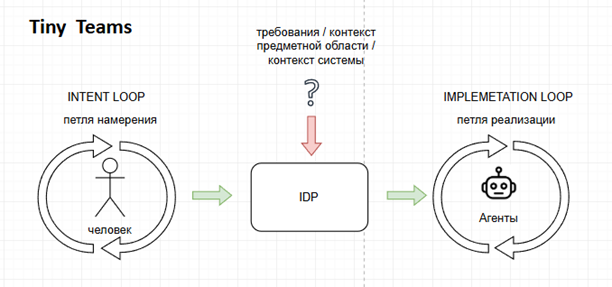
Основная проблема — как загрузить качественным топливом Intelligent Document Processing (IDP)?
Whitepaper вводит достаточно большой список ролей для реализации подхода IDP с Tiny Teams. Но по сути в основе лежит методология AI-Driven Development Lifecycle (AI-DLC).
Для первоначального подхода предлагается ввести следующие роли.
DD-Ops инженер (Domain-Driven Operations Engineer)
Эксперт по автоматизации архитектурных границ, управлению жизненным циклом доменных моделей и комплаенс-контролю ИТ-ландшафта с использованием инструментов AI. Наиболее близко соответствует роли Solution Architect (архитектор решений).
Ключевая задача роли: обеспечить скорость генерации и контроля «рамки мира» (Bounded Contexts, ArchUnit-тесты, схемы CQRS), сопоставимую со скоростью написания бизнес-кода микрокомандами Tiny Teams, полностью исключая рутинную нагрузку на архитекторов доменов и предотвращая доменный дрейф (Domain Drift).
BD-Ops (Business-Driven Operations) / Context-Ops
Обеспечить Tiny Teams / Следующего Стратега готовыми, непротиворечивыми «бизнес-рельсами» (выделенными контекстами, схемами BPMN и описанием сущностей) в момент старта фичи. Это исключает ручную аналитическую рутину, долгие согласования и «паралич проектирования» (Analysis Paralysis). Гибрид бизнес- и системного аналитика.
Ключевая задача роли: формализация требований бизнеса. Сбор требований и их оцифровка должны стремиться к максимальной автоматизации (оцифровка встреч на лету с агрегацией к эпику и с выводами через AI — саммаризация).
Перечисленные роли не являются чем-то уникальным — их задача обеспечить поставку артефактов для формирования требований и правил для процесса разработки. По сути, применяется один и тот же подход: фрагментация процесса реализации намерений с помощью AI-агентов на каждом этапе с конкретным артефактом/результатом.
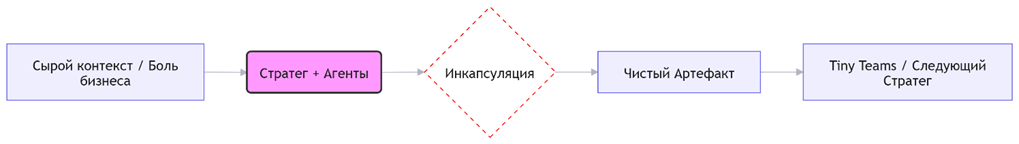
Подход здесь такой же, как при обычной разработке, просто разделение с явной зоной ответственности позволяет сделать процесс цикличным и с явным результатом (артефактом). Агенты же позволяют постоянно анализировать артефакты с учётом смысла и в рамках контекста.
Одна из целей внедрения ролей DD-Ops и BD-Ops — снижение требований к Tiny Teams по уровню компетенций через формирование правил.
Режим работы
Предположим, что DD-Ops ранее уже сформировал артефакты/требования (по сути, его схема работы аналогична схеме BD-Ops).
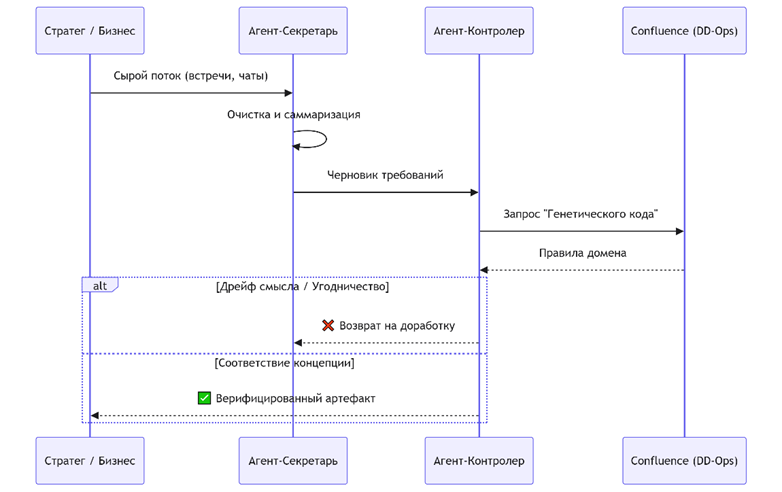
Тогда схема работы для BD-Ops будет следующей.
Фаза инициализации (слепок Стратега)
Стратег садится с агентом-опросником и в произвольной форме «скармливает» ему свой опыт, видение продукта, болевые точки и критерии «правильного».
Фаза экстракции (очистка сырья)
Агент перерабатывает этот хаотичный поток, убирает абстракции и формирует первый Skill-шаблон (свод правил домена). Этот шаблон фиксируется в Confluence.
Фаза разделения «личностей»
На основе одного Skill-шаблона и RAG создаются две разные сущности (два агента):
-
Агент-Секретарь: ему разрешено быть гибким в контекстном окне, слушать «сырой» бизнес, оцифровывать встречи.
-
Агент-Контролёр: его «личность/профиль» зажата в тиски. Он не общается с бизнесом напрямую. Он берёт то, что написал Агент-Секретарь, и сверяет с «Генетическим кодом» (правилами домена, поставщик данных DD-Ops) из Confluence. Если Агент-Секретарь под влиянием человека допустил дрейф смысла, Агент-Контролёр возвращает задачу на доработку со списком замечаний.
Фаза эволюции профиля
По результатам обработки задачи итоговые данные, верифицированные стратегом, фиксируются в «профиле» и переключают профиль на следующую версию знаний.
Итоговая общая схема процесса
Тогда общая производственная схема станет трёхуровневой: DD-Ops + BD-Ops + Tiny Teams. Где в IDP встречаются потоки от DD-Ops и BD-Ops, а Tiny Teams потребляет результат.
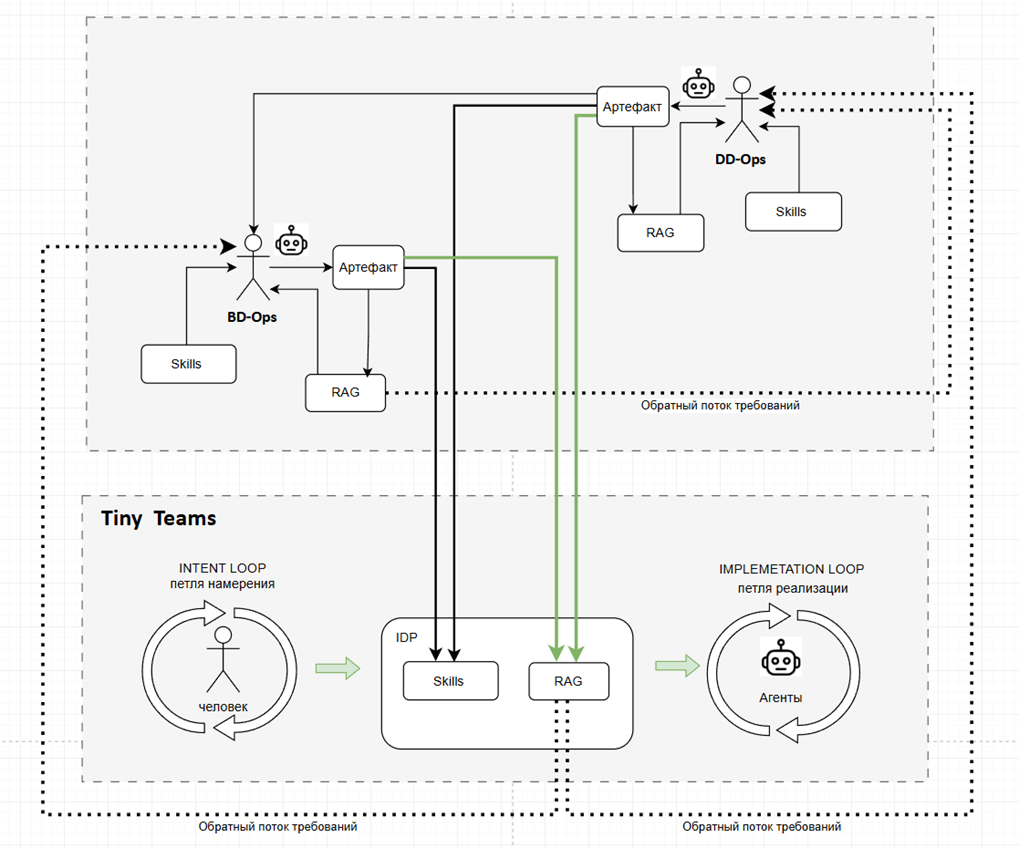
Основная цель — формирование профиля Архитектора и Аналитика системы через DD-Ops и BD-Ops с учётом итеративности и цикличности процесса.
Стратег — это не должность, а функция. Конкретные воплощения (DD-Ops, BD-Ops, PO, корпоративный архитектор, методологи) — это разные уровни одной и той же роли.
Далее рассмотрим возможность оценить эффективность и экономическое обоснование внедрения AI-агента в первом приближении в разрезе аналитика Tiny Teams, но в целом подход проецируется на любой раздел или роль аналогичным образом из-за принципа инкапсуляции.
Будут фигурировать два понятия: приведённое и базовое время. По своей сути они близки. С точки зрения дальнейшего примера приведённое время стремится к базовому, и разница между ними не критична для примера.
-
Базовое время — абсолютное значение и соответствующая сетка координат.
-
Приведённое время — расчётное значение в рамках контекста, как наиболее объективное значение для сетки координат в рамках контекста.
Экономика процесса
Основа всего — деньги, но время может быть универсальной единицей для приведения оценки процесса к единой сетке координат. Время тоже разное для каждой должности.
Сначала составим базовую матрицу должностей: Аналитик, Старший аналитик, Ведущий аналитик, Главный аналитик.
|
Должность |
Исходное время в часах |
Личный множитель |
Командный множитель |
Множитель уровня должности |
Приведённое время |
|---|---|---|---|---|---|
|
Аналитик |
1 |
1 |
1 |
8 |
0,33 |
|
Старший аналитик |
1 |
1 |
1 |
17 |
0,71 |
|
Ведущий аналитик |
1 |
1 |
1 |
22 |
0,92 |
|
Главный аналитик |
1 |
1 |
1 |
24 |
1 |
Исходное время в часах — реальное время сотрудника.
Личный множитель — личная характеристика сотрудника, применима к сильно замотивированным участникам процесса. (Пример: если сотрудник трудоголик и он работает по 12 часов, хотя исходное время в рамках рабочего дня может быть указано как 8 часов.)
Командный множитель — характеристика команды, дающая ей преимущества как единой сущности; применима к командам, работающим долго в одном составе и знающим свои слабые и сильные стороны.
Множитель уровня должности — характеристика, описывающая, что чем выше должность, тем выше уровень экспертизы сотрудника (подобран эмпирически). Оценка может показаться упрощённой, но основная цель — показать, что существует понятие «ценность» сотрудника. Параметр отражает не только уровень экспертизы, но и может быть сильно связан со стоимостью, то есть сотрудник не только ценен, но и может быть дорог.
Приведённое время — время в единой системе координат.
Я придерживаюсь мнения, что график для приведённого времени должен стремиться быть экспоненциальным для типовых задач в рамках одного направления: с ростом должности разница между уровнями становится менее заметна (хотя в примере он более линеен).
Возможно ли, что Личный множитель нивелирует Множитель уровня должности? Да, возможно, это не запрещено. Но что это может значить? Что на скорость типовых задач Множитель уровня должности не оказывает сильного влияния, но также и то, что, возможно, кого-то пора повысить :)
Формула
Приведённое время = Исходное время в часах × Личный множитель × Командный множитель × (Множитель уровня должности / max(Множитель уровня должности))
Из таблицы должностей не следует делать выводы, что, например, главного всегда можно заменить определённым количеством обычных аналитиков, но для типовых задач это возможно.
Есть план, есть факт. План считается в человеко-днях (чд). У стори-поинта есть коэффициент перевода в чд. Факт берётся или из таймшита, или может вычисляться как разница по времени между статусами задачи, умноженная на понижающий коэффициент; на выходе получаем значение в чд. Можно применить различные подходы, главное чтобы подход был единым как для плана, так и для факта.
То есть если соблюдать базовую гигиену при ведении Jira, то данных должно быть более чем достаточно.
Количество множителей может показаться избыточным, но из-за ожидаемого высокого отношения сигнал/шум (ОСШ) это не сильно критично и позволит увидеть картину в целом и более корректно её подкрутить.
Перевод стоимости токена во время
Пример
Формирование типового требования старший аналитик сделает за 40 часов. Для сценария с агентом потребуется суммарно 100 000 токенов + время на подготовку требования со стороны сотрудника. Время подготовки данных для агента может быть до 50% общего времени от изначальной оценки. Суммарное время работы агента в рамках указанной задачи составило 1 час.
-
Сценарий без агента: аналитик — 40 часов.
-
Сценарий с агентом: аналитик — 20 часов, агент — 1 час (100 000 токенов).
Для перевода токенов в единое время используем ценность артефакта — 40 часов аналитика (сценарий без агента).
Приведённое время токена = приведённое время старшего аналитика × 40 / 100 000 = 0,71 × 40 / 100 000 = 0,000284 ч
С учётом времени на подготовку стоимость токена по времени вырастет в 2 раза и составит 0,000568 ч.
Среднюю стоимость для 100 000 токенов можно оценить в 2000 руб. (возьмём условную оценку по верхней границе коммерческих моделей), тогда 1 токен = 0,02 руб.
1 токен = 0,000568 ч = 0,02 руб.
Таким образом, стоимость работы агента (относительно времени сотрудника):
-
1 час ≈ 35,21 руб.
-
8 часов ≈ 281,69 руб.
-
месяц (21 рабочий день) ≈ 5 915,49 руб.
Выбранная модель DeepSeek-V4.1 Flash
Уровень модели в пилоте оценивается как Старший аналитик.
Если в рамках данного процесса взять за основу текущую роль, то приведённое время для 1 токена для данного типа задачи составит:
Приведённое время уровня модели × время работы агента / количество токенов (in + out) = 0,71 × 1 / 100 000 = 0,0000071 ч
Берём несколько кейсов и выводим среднее значение приведённого времени для 1 токена.
Важно не путать!
-
Астрономический час работы LLM (генерация 100к токенов) стоит 2000 руб. (это счёт от провайдера).
-
Но за этот 1 час и 2000 рублей LLM генерирует артефакт, который в нашей системе координат имеет ценность
2000 / 35,21 = 56,8приведённых часов.
Тогда общую стоимость артефакта можно оценить как:
Время затрат сотрудника на задачу × Приведённое время сотрудника + количество токенов × приведённое время для 1 токена
И это можно сравнить с базовой оценкой аналогичной задачи без AI-агента.
Если перевести всё в базовое/приведённое время и сравнить, то базовое время — универсальная величина для оценки эффективности и экономики процесса.
Условно, при зарплате аналитика в 150 000 руб. (не считая налогов) и при КПД процесса в 50% может стремиться к 12-кратной экономии в первом приближении. Да, конечно, это идеальный результат, и могут быть неточности или особенности процессов, но кратный возможный рост, который даёт выигрыш, уже сложно не учитывать и игнорировать — как по времени, так и по стоимости.
До каких пор подход с агентом может иметь смысл?
-
В примере я взял стоимость коммерческой модели — схема подходит для предварительной оценки, когда у вас уже развёрнуты модели, но нет внутренней стоимости. Данный подход вполне можно взять за точку отсчёта. Даже если с вас явно не берут стоимость работы модели, но так или иначе она есть (стоимость ресурсов и людей).
-
Если стоимость токена вырастет в 10 раз, то это всё равно выгодно, так как хоть это становится сопоставимо с сотрудником, но работаете с агентом только когда он нужен вам, и не платите явно за его простой, а также он работает быстрее в ряде задач.
-
Если стоимость токена вырастет в 100 раз, то это полностью нивелирует все преимущества. Также стоит учитывать, что кратное падение скорости работы агента усилит негативный эффект. (Такая стоимость может быть вполне реальна, если на проект переложат TCO (совокупную стоимость владения) всей LLM-инфраструктуры.)
Сегментация ролей + веса сложности задачи + базовое время = универсальная метрика.
Пример не претендует на аксиому — его задача показать упрощённый подход с приведением к единой системе измерения. При работе с командой в течение квартала обычно уже складывается общее мнение о производительности как в целом команды, так и отдельных её участников, и можно составить свою таблицу перевода — суть от этого не изменится.
Дальше начинается процесс проверки теории и соответствия весов.
Чем больше осмысленных параметров, тем выше разрешающая способность системы.
Как применять сравнение
Сравнение объёма работы через базовое время сценариев с агентом и без него. Сначала среднее, затем средняя скользящая (Moving Average — MA).
Для полноценного производственного процесса формула усложнится, так как, например, часть процессов нельзя сделать без готовности результатов предыдущего этапа, но и там могут быть нюансы, как, например, возможность реализации части работ с пониженным КПД. В общем, как и везде, есть нюансы.
Но держим смысл в фокусе, идём дальше и не уходим в детали в плане оценки работы для детального учёта факта работ. Основная цель — это определение весов.
Так как в основе лежит теория кратного роста производительности, то ОСШ ожидается высоким. Мы также применим подход сразу не ко всему процессу разработки, а только к первому этапу, для которого можно получить конечный результат в виде артефакта.
На дистанции от полугода ожидается, что должен стать заметен эффект между планом и фактом трудоёмкости задач, а также снижение трудоёмкости задач, то есть по сути мы должны делать больше без увеличения трудоёмкости команды.
Задача — вывести связь/отношение в базовом времени для реализации артефакта.
Важно! Метрику не стоит применять как KPI — это дашборд для управления процессом. Его задача — определение и корректировка весов.
Оценка по времени может дать понятие о вероятности замены человека AI-агентом. Но нужно быть реалистом и учитывать, что чем проще оценочный механизм метрики, тем хуже вероятностная оценка. Таким образом, это не стоит воспринимать как основной аргумент к принятию данного решения, но подход позволит определить фокус по данному направлению.
Также важно понимать, что автоматизация рутины низших грейдов — это лишь способ оптимизации затрат, в то время как освобождение времени Главного или Ведущего от рутины — это мультипликатор прибыли и безопасности всего ИТ-ландшафта.
Проблемы процесса
Одна из уязвимых черт базовых LLM — их органическое, заложенное при обучении (через RLHF) стремление угождать пользователю (pleasing effect). В результате в процессе долгого диалога «ценность правды стремится к нулю», а агент превращается в конформиста, который может одобрять системный/архитектурный хаос. Можно предположить: если указать агенту на строгость суждения, что-то существенно изменится? Но нет — pleasing effect просто сменит знак на противоположный.
По сути, он вырождается в обычную тень: вы машете руками — тень повторяет. Вы прыгаете с моста… упс. Слепое послушание становится опасным, что может приводить к неосознанной генерации семантического шума.
Закон (принцип) Гудхарта на уровне промпт-инжиниринга
-
Суть: привязка «приведённого времени» к объёму токенов.
-
Проблема: внедряя эту метрику как дашборд, а не как KPI, однако в неидеальной человеческой системе, как только команды поймут, что объём пропущенных через агента токенов транслируется во «приведённые часы трудоёмкости» на дашборде Стратега, начнётся осознанная генерация семантического шума. Сотрудникам в «плохой день» станет выгодно скармливать агенту-опроснику огромные неотфильтрованные простыни переписок из мессенджеров вместо коротких структурированных резюме, чтобы искусственно раздувать объём затраченного «базового времени» и задирать метрики по утилизации времени для агентов.
-
Решение: внедрение микро-агента (линтера) для первичной компрессии и разметки.

Механика расчета КПД данных на конвейере требований
-
Двухэтапная фильтрация (очистка сырья): прежде чем сырой текст (транскрипт, выгрузка из чатов) попадает в основной счётчик токенов для расчёта «приведённого времени», промежуточный микро-агент (линтер контекста) выполняет первичную компрессию и разметку.
-
Формула полезного сигнала: КПД рассчитывается как отношение объёма токенов финального структурированного артефакта (контракта, BPMN-схемы, BRD) к объёму токенов «сырого» входящего потока.
-
Корректировка приведённого времени: в итоговый дашборд Стратега идёт значение, помноженное на этот КПД. Если сотрудник скормил модели 100 000 токенов «шума», из которых агент-секретарь смог выжать полезный контракт всего на 2 000 токенов, КПД системы падает до 2%. Соответственно, «приведённое время» за эту рутинную операцию штрафуется понижающим коэффициентом.
-
Коэффициент сложности домена (опция): необходимо добавить коэффициент сложности домена для нивелирования распутывания сложного домена или легаси. Коэффициент сложности со временем может снижаться по мере становления продукта и повышения его стабильности.
КПД данных = Токены валидного артефакта на выходе / Токены сырых данных на входе
Выводы
Результаты, которых хочется достичь:
-
Получить сравнение в стоимости работы сотрудника и AI-агента в единой системе координат.
-
Получить подтверждённый прирост для типовых задач x4 при неизменности качества или даже с учётом его повышения. Для исследовательских задач или задач с первичной постановкой получить прирост на 40%.
-
Проверить возможность создания и устойчивой работы производственного конвейера в режиме AI-DLC для закрытого контура.
Автор: ksa4004